
通信工程 / 系统课时
设计可复现的蒙特卡洛误码实验
设计可复现的蒙特卡洛误码实验
同一个信道或编码方案重复仿真时,误码率通常不会完全相同。要让结果可核对,必须固定随机种子、统计口径、停止条件和记录字段。本篇先用二元对称信道(BSC)搭建可运行基准,再说明怎样将它用于纠错码的性能对比。
学习目标
- 区分实际误码计数与理论误码概率,正确计算 BER。
- 固定随机流,用目标误码数和最大样本量共同控制仿真。
- 根据误码数量判断估计精度,并识别尚未收敛的曲线点。
确定统计口径与基准信道
比特误码率 BER 定义为错误比特数 与已比较比特数 之比:
例如比较 100,000 位,发现 93 位错误,则 BER 为 0.00093。帧误码率 FER 的分母是帧数,不能和 BER 混用;比较纠错方案时,应将译码后的信息比特与原始信息比特逐位比较,不能把冗余校验位也计入分母。
本例选择 BSC,单个比特以固定概率 翻转,分别测试 、、。因为 BSC 的翻转事件不依赖输入比特取值,可以直接抽取翻转事件完成基准校验;它验证的是统计框架,不是纠错编码增益。
固定种子并执行双重停止
设基础种子为 20261022,每个 使用基础种子加上参数序号,避免不同曲线点意外复用同一随机流。每批模拟 1,000 位,累计错误数与样本数;满足以下任一条件就停止:
- 错误数 ,达到目标统计量。
- 已比较位数 ,触及计算预算上限。
判断发生在每批结束后,因此最终错误数允许略大于 200。达到样本上限但没有积累够错误数,必须保留该结果的“未达误码目标”状态,不能把它当成同等精度的数据点。
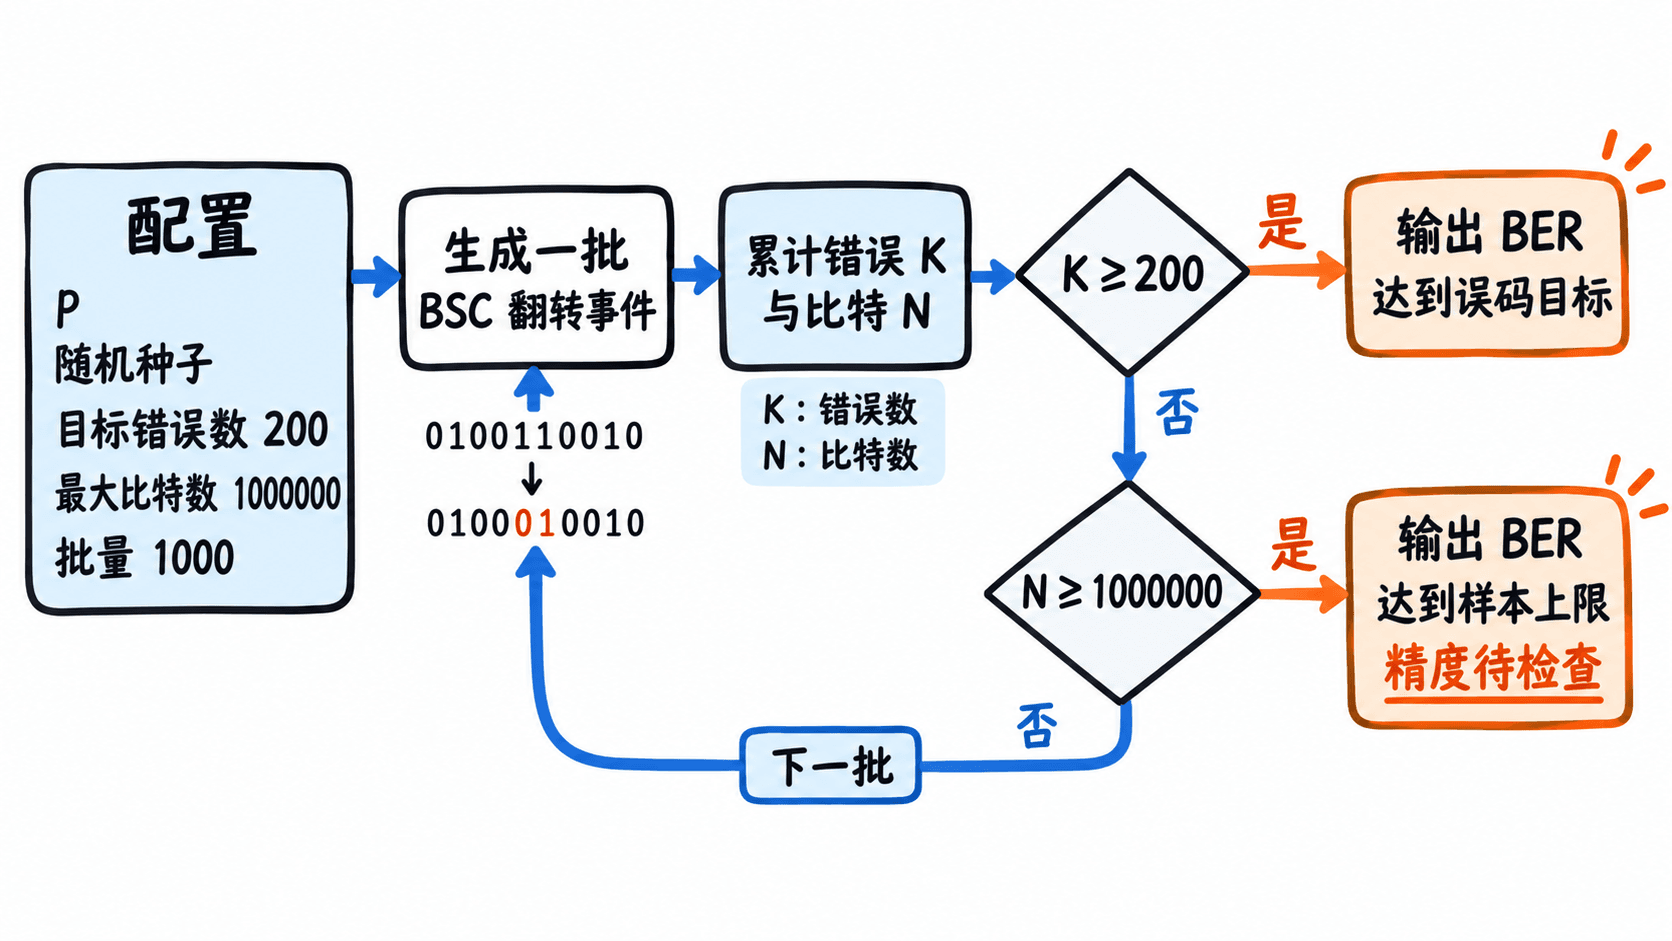
将下面代码保存为 ber_mc.py,使用 Python 3.9 或更高版本运行 python ber_mc.py;只依赖标准库。
import math
import random

SEED = 20261022
TARGET_ERRORS = 200
MAX_BITS = 1_000_000
BATCH_BITS = 1_000

def estimate_ber(p: float, seed: int):
    rng = random.Random(seed)
    errors, total_bits = 0, 0
    while errors < TARGET_ERRORS and total_bits < MAX_BITS:
        count = min(BATCH_BITS, MAX_BITS - total_bits)
        # BSC 的翻转事件即一次比特错误
        errors += sum(rng.random() < p for _ in range(count))
        total_bits += count
    ber = errors / total_bits
    # 误码数足够大时,粗估 95% 相对误差半宽
    rel_95 = 1.96 / math.sqrt(errors) if errors else float("inf")
    stop = "达到误码目标" if errors >= TARGET_ERRORS else "达到样本上限"
    return total_bits, errors, ber, rel_95, stop

def main():
    # 每个信道参数使用独立且确定的随机数流
    for i, p in enumerate((1e-2, 1e-3, 1e-4)):
        n, e, ber, relative, why = estimate_ber(p, SEED + i)
        print(f"p={p:.0e} bits={n} errors={e} ber={ber:.6f} "
              f"rel95=±{relative:.1%} stop={why}")

if __name__ == "__main__":
    main()
预期输出:
p=1e-02 bits=23000 errors=204 ber=0.008870 rel95=±13.7% stop=达到误码目标
p=1e-03 bits=220000 errors=202 ber=0.000918 rel95=±13.8% stop=达到误码目标
p=1e-04 bits=1000000 errors=108 ber=0.000108 rel95=±18.9% stop=达到样本上限
固定相同的 Python 随机数算法、种子与参数,重复运行应得到相同计数。若更换种子,计数可以变化,但结果应在合理统计波动范围内围绕理论值 分布。
用误码数核对样本是否足够
当误码事件近似独立、错误数不太小时,BER 估计的 95% 相对误差半宽粗估值为 。因此累计 200 个错误约对应 ±13.9% 的相对波动量级;要把该量级压至约 ±5%,需要约 个错误。这个近似值用于预算规划,并非对自适应停止实验的严格置信区间。
预估为了积累 200 个错误需要 位:当 时约 2 万位, 时约 20 万位, 时约 200 万位。示例的最后一个点只允许跑 100 万位,所以停在 108 个错误;若要满足同样的精度目标,可把上限提高到 300 万位并重跑。
迁移到纠错码性能对比
加入纠错码后,把每次试验改成“生成信息位、编码、经信道传输、译码、对照原信息位”。仍累计译码后的信息比特错误数 与信息比特数 ,同一信噪比点执行相同的停止规则。对不同码率的方案应统一 的定义及能量归一化,不能仅用相同噪声方差冒充公平比较。
每个数据点至少保存方案名称、码率、信道参数、随机种子、比特总数、错误数、BER、停止原因、目标错误数、最大样本量和程序版本。对接近的两条曲线,使用多个独立种子复测并汇总误码数与信息比特数;不要直接平均各次 BER,尤其在每次样本量不同的情况下。