
通信工程 / 系统课时
对比 Polar 码的 SC 与 SCL
对比 Polar 码的 SC 与 SCL
给定一组带噪声的接收软信息,SC 只沿一条路径逐位判断,SCL 则暂存多条候选路径。这篇用长度为 8 的 Polar 码复现一次 SC 误判、SCL 纠正的案例,具体说明何时分叉、怎样剪枝,以及更好的纠错表现需要付出多少计算和存储代价。
学习目标
- 区分 SC 的单路径逐位判决和 SCL 的多路径保留机制。
- 根据 LLR 与路径度量解释信息位扩展、冻结位约束和候选剪枝。
- 运行最小实例,对照译码结果并选择合适的列表大小。
SC 的逐位决策为什么可能失误
Polar 码把长度 的输入向量 分成信息位与冻结位。为方便观察,取从 0 开始的冻结索引集合 ,这些位置一律置 0;信息位索引为 ,因此 ,码率 。这是教学用短码,不是通信标准的参数配置。
接收端先获得编码比特 的对数似然比(LLR):正值偏向 0,负值偏向 1,绝对值越大表示把握越大。SC 通过极化译码树的 与 运算,结合已判定前缀计算当前 的 LLR。冻结位直接选 0;信息位按当前 LLR 符号选择 0 或 1。
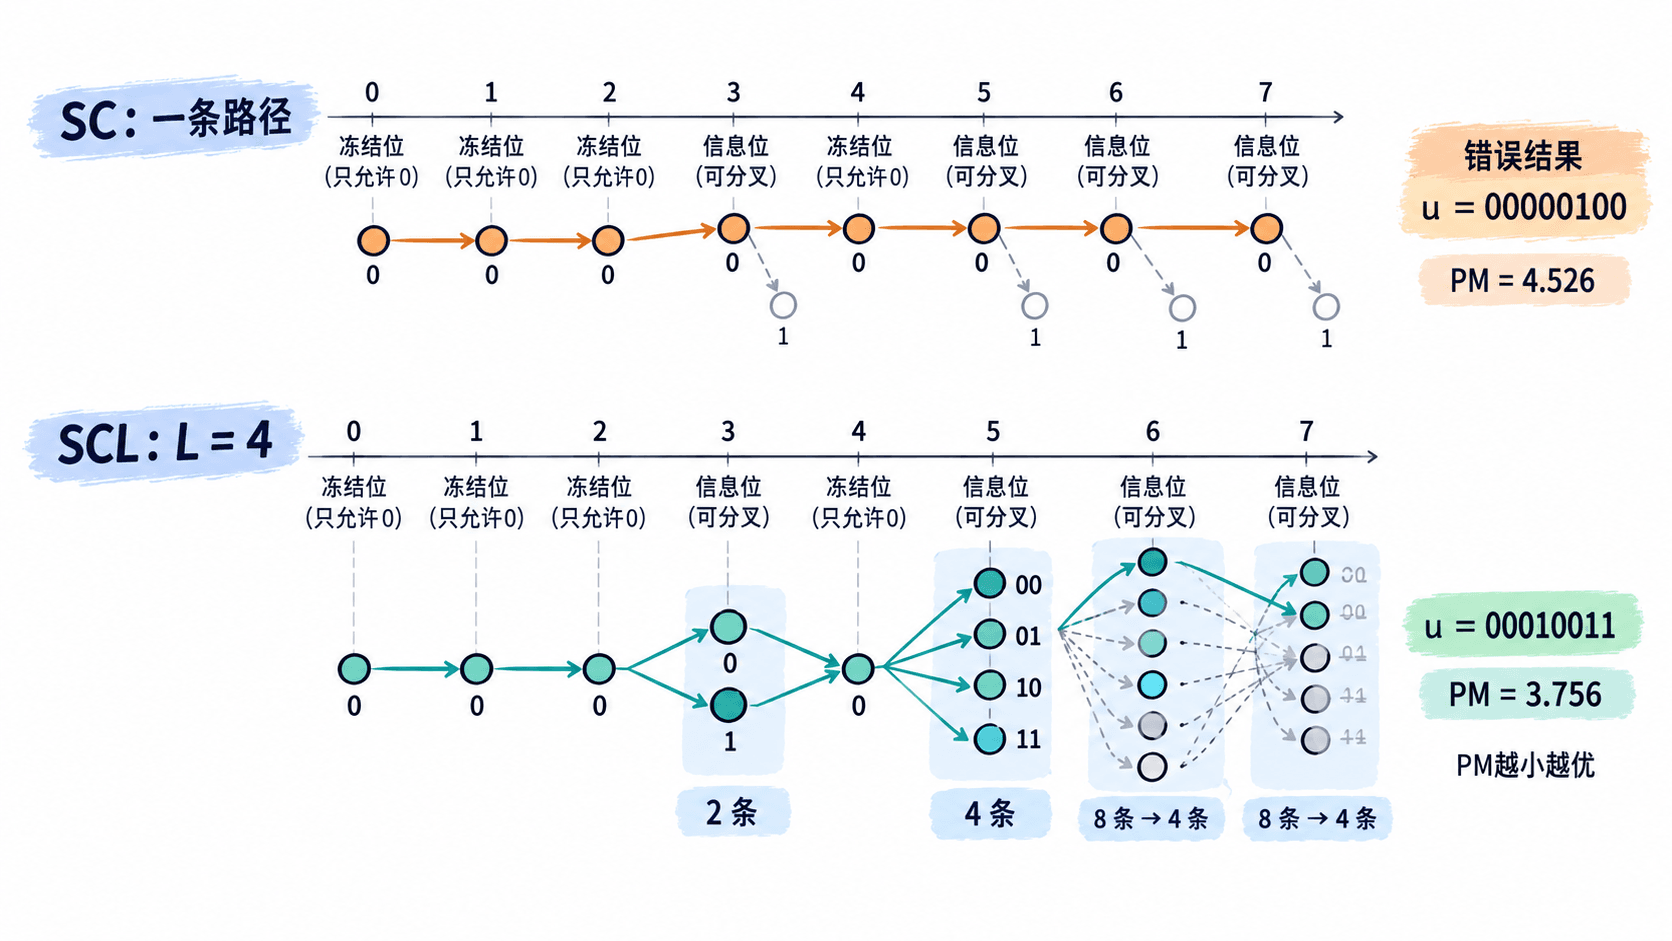
SC 从索引 0 译到 7,只保留已选择的一条前缀。假如第 3 位在噪声影响下选错,第 5~7 位的条件 LLR 也会受前缀影响;即使后面的观测提供了反证,SC 也不会返回第 3 位修正。它的优势是状态少、实现简单,但短码长下可能出现明显的错误传播。
SCL 如何扩展和剪掉候选路径
SCL 为每条候选保存“已判定前缀 + 路径度量(PM)”。处理信息位时,把候选分别延伸为比特 0 与 1;处理冻结位时只能延伸为 0。每轮按 PM 从小到大排序,最多留下 条。 时,便退化为 SC。
给定当前路径计算的 LLR 为 ,尝试比特 ,可以用精确的对数域增量:
将它累加到旧 PM;PM 越小越优。例如 时,选择 1 的代价约为 0.437,选择 0 的代价约为 1.037。SC 立即保留 1;SCL 可以暂时保留两个选择。冻结位虽然不分叉,也必须累加选择 0 的代价,否则不同前缀的 PM 将无法公平比较。
按上述 8 位索引并取 :经过信息位 3,路径数从 1 变为 2;经过冻结位 4,仍为 2;经过信息位 5,变为 4;处理信息位 6 时临时产生 8 条,裁剪至 4 条;信息位 7 再执行一次“8 选 4”。
用同一组 LLR 复现结果
把发送的极化输入设为 ,经过无比特反转的极化变换 ,得到编码字 。下面固定 8 个接收 LLR,比较同一输入下 SC()和 SCL();不依赖随机噪声,使用 Python 3.8+ 标准库即可运行。示例没有加入 CRC。
import math

FROZEN = {0, 1, 2, 4}

def encode(u):
    # 使用 F 的 Kronecker 幂实现蝶形编码,不做比特反转
    x = u[:]
    stride = 1
    while stride < len(x):
        for start in range(0, len(x), 2 * stride):
            for j in range(start, start + stride):
                x[j] ^= x[j + stride]
        stride *= 2
    return x

def f(a, b):
    sign = 1 if a * b >= 0 else -1
    return (sign * min(abs(a), abs(b))
            + math.log1p(math.exp(-abs(a + b)))
            - math.log1p(math.exp(-abs(a - b))))

def bit_llr(channel, prefix, index):
    n = len(channel)
    if n == 1:
        return channel[0]
    half = n // 2
    if index < half:
        left = [f(channel[j], channel[j + half]) for j in range(half)]
        return bit_llr(left, prefix, index)
    # g 计算必须使用左子树的编码部分和,而不是原始 u 前缀
    left_code = encode(prefix[:half])
    right = [(1 - 2 * left_code[j]) * channel[j] + channel[j + half]
             for j in range(half)]
    return bit_llr(right, prefix[half:], index - half)

def decode(channel, width):
    paths = [([], 0.0)]
    for index in range(len(channel)):
        expanded = []
        for bits, pm in paths:
            llr = bit_llr(channel, bits, index)
            for bit in ([0] if index in FROZEN else [0, 1]):
                z = -(1 - 2 * bit) * llr
                increment = max(0.0, z) + math.log1p(math.exp(-abs(z)))
                expanded.append((bits + [bit], pm + increment))
        # 信息位可分叉,但候选总数不得超过列表宽度
        paths = sorted(expanded, key=lambda item: item[1])[:width]
    return paths

u = [0, 0, 0, 1, 0, 0, 1, 1]
llr = [-4.03, 1.63, 1.24, 2.70, 1.03, -0.43, 2.03, 0.65]

print("x:", "".join(map(str, encode(u))))
for width in (1, 4):
    bits, pm = decode(llr, width)[0]
    print(f"L={width}: {''.join(map(str, bits))}, PM={pm:.3f}")
预期输出:
x: 10100101
L=1: 00000100, PM=4.526
L=4: 00010011, PM=3.756
SC 选中了错误的第 3 位,最终输入估计为 00000100;SCL 保留了第 3 位为 1 的候选,并在后续度量更新后选出正确的 00010011。信息位提取结果相应为 SC 的 0100 与 SCL 的 1011。这是一个确定性示例,不能据此推断任意信噪比下的误块率改进幅度。
复杂度、CRC 和工程取舍
对于带有中间结果复用和路径共享的高效实现,SC 的时间复杂度通常为 、存储约为 ;SCL 的时间复杂度约为 、存储约为 。上面的 Python 代码为了展现路径逻辑,会重复计算 LLR,不能用运行时间衡量高效 SCL 的理论复杂度。
| 方案 | 候选数 | 路径选择 | 代价与适用情况 |
|---|---|---|---|
| SC | 1 | 逐位立即决定 | 复杂度最低,错误不可回退 |
| SCL() | 最多 4 | 终点选 PM 最小者 | 可纠正部分早期误判,需分叉和剪枝 |
| CA-SCL() | 最多 4 | 优先从 CRC 通过的路径中选 PM 最小者 | 增加 CRC 校验与码率开销,通常进一步改善短码块错误率 |
CRC 辅助 SCL(CA-SCL)需要在发送前把 CRC 比特附加到有效载荷,再把“载荷 + CRC”一起放入 Polar 信息位置;译码结束后对候选逐一做 CRC 校验。若没有候选通过,接收端应依业务策略声明失败或回退到最小 PM,不能把 CRC 失败当作正确译码。
实际比较时可固定码长 、信道模型和有效载荷长度,分别测试 的误块率(BLER)、平均耗时和峰值内存,并明确 CRC 是否启用。列表加大并不保证每个接收块都更正确:正确路径可能在中途被剪掉,CRC 也可能误放行。若先要验证算法和最低资源消耗,用 SC;若短块可靠性更重要、允许更多内存与延迟,优先评估 CA-SCL。