
通信工程 / 系统课时
用块交织分散连续比特错误
用块交织分散连续比特错误
短时干扰可能连续翻转多个比特,让单个纠错码字超出可修复范围。这里用四行七列的块交织,把四位连续错误分散到四个汉明码字,再用 Python 对照验证能否还原原始信息。
学习目标
- 解释连续错误为何容易突破单个码字的纠错上限。
- 按写行、读列规则追踪交织前后的比特位置。
- 运行仿真,对比相同突发干扰下的译码结果,并计算缓冲代价。
连续错误为什么难以纠正
以汉明码 (7,4) 为例:每 4 位信息编码成 7 位码字,最小汉明距离为 3,因此每个码字最多能保证纠正 1 位错误。假设一次干扰恰好连续翻转 4 位,若这 4 位都落在同一个 7 位码字内,单错误译码器就不能可靠还原信息。
本例选取四组信息 1011、0110、1100、0011,各自编码后得到 0110011、1100110、0111100、1000011。如果按码字顺序直接发送,发送序列中从 0 开始编号的第 8~11 位恰好都属于第二个码字,错误分布是 [0, 4, 0, 0]。
四行七列怎样分散突发错误
块交织器把四个 7 位码字分别写入矩阵的四行,再按列依次读出并发送。每读取一列,就从四个不同码字各取一位。接收端收满同样的 28 位后,按相反的顺序写列、读行,完成解交织。
本例交织发送的 28 位序列为 0101111010100010011011011001。如果连续翻转第 8~11 位,这四位恰好对应第三列的四行。解交织后,每个码字只有第 3 位出错(位序从 1 开始),错误数便从单个码字的 4 位变为四个码字各 1 位。
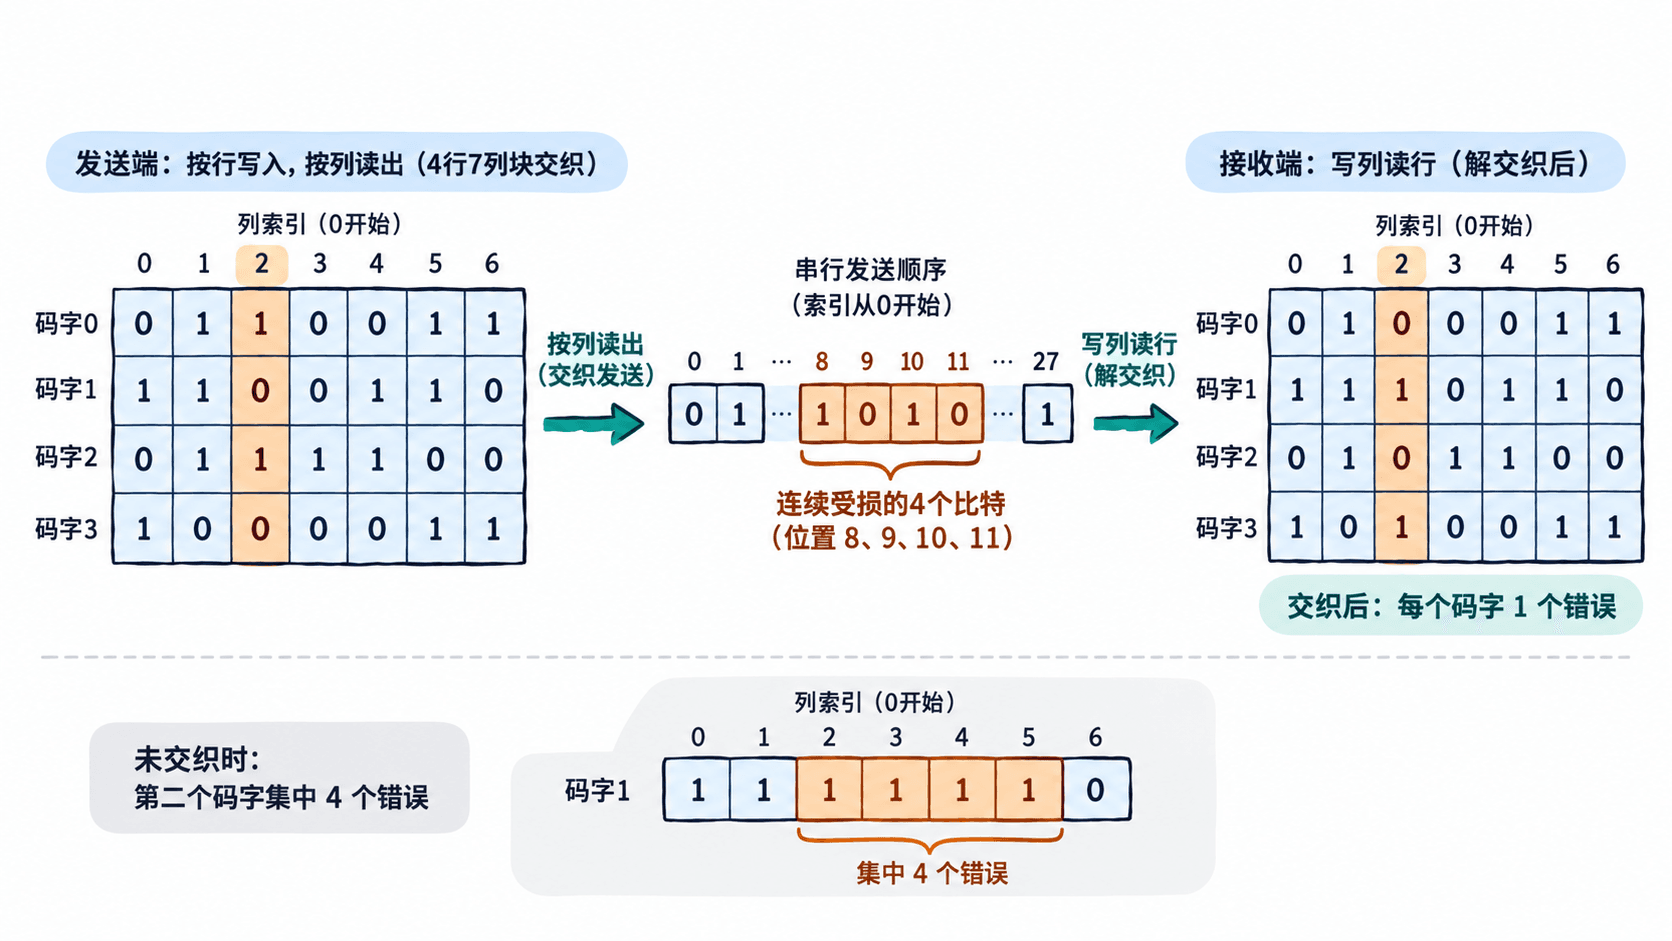
这张图的关键不是修改纠错码,而是修改相邻信道比特属于哪个码字。只要一次突发错误长度不超过交织深度 4,在此逐列发送方式下,同一块内每行最多分到 1 位错误。
用 Python 复现相同的四位干扰
以下示例适用于 Python 3.9 及以上版本,不依赖第三方库。encode 生成偶校验汉明 (7,4) 码字,decode 用伴随式进行单错误纠正;两组实验均翻转发送比特索引 8~11,唯一差别是是否交织。
def encode(payload):
    bits = [0] * 7
    for pos, value in zip((3, 5, 6, 7), map(int, payload)):
        bits[pos - 1] = value
    # 校验位在第1、2、4位,使用偶校验
    for parity in (1, 2, 4):
        bits[parity - 1] = sum(bits[i - 1] for i in range(1, 8) if i & parity) % 2
    return bits

def decode(bits):
    # 仅对至多1位错误保证正确纠正
    syndrome = sum(
        parity for parity in (1, 2, 4)
        if sum(bits[i - 1] for i in range(1, 8) if i & parity) % 2
    )
    fixed = bits.copy()
    if syndrome:
        fixed[syndrome - 1] ^= 1
    return "".join(str(fixed[i - 1]) for i in (3, 5, 6, 7))

def interleave(rows):
    return [rows[r][c] for c in range(7) for r in range(4)]

def deinterleave(stream):
    return [[stream[4 * c + r] for c in range(7)] for r in range(4)]

def flip_burst(stream):
    damaged = stream.copy()
    # 两组实验都翻转连续的4位
    for index in range(8, 12):
        damaged[index] ^= 1
    return damaged

data = ["1011", "0110", "1100", "0011"]
words = [encode(message) for message in data]
after_interleaving = deinterleave(flip_burst(interleave(words)))

plain = flip_burst([bit for word in words for bit in word])
without_interleaving = [plain[i:i + 7] for i in range(0, 28, 7)]

def counts(received):
    return [sum(a != b for a, b in zip(sent, got))
            for sent, got in zip(words, received)]

print("交织后各码字差错数:", counts(after_interleaving))
print("交织后译码:", [decode(word) for word in after_interleaving])
print("未交织各码字差错数:", counts(without_interleaving))
print("未交织译码:", [decode(word) for word in without_interleaving])
预期输出:
交织后各码字差错数: [1, 1, 1, 1]
交织后译码: ['1011', '0110', '1100', '0011']
未交织各码字差错数: [0, 4, 0, 0]
未交织译码: ['1011', '1010', '1100', '0011']
第一组四个码字都在单错误纠正能力内,因此恢复原始数据;第二组第二个码字出现 4 位错误,译码结果 1010 与原始 0110 不同。这里将信道突发错误简化为确定性的连续翻转,目的是隔离验证交织规则,不代表真实信道每次干扰都会恰好翻转四位。
深度和延迟该怎么选
对于每码字最多纠正 1 位错误的方案,若希望抵御最长 6 位的单次连续错误,可将交织深度从 4 提高至至少 6:每批处理 6 个 7 位码字,即 42 位。若仍用深度 4,长度为 6 的突发错误可能让同一行承受 2 位错误,单错误译码器不再有纠正保证。
交织不会改变汉明码的码率,仍是 4/7,也不会消除错误;代价是缓冲和时延。本例发送端需组织 28 位交织块,接收端也要收齐相应的 28 位才能重排。实际链路还要保证收发双方的块边界、行数和列数一致;帧中不足一块的数据须约定填充与去填充方式。
交织适用于突发比特错误与纠错码配合使用的场景。如果干扰连续超过所选深度、出现多次相邻突发错误,或整帧已经丢失,就应结合更深交织、擦除恢复或 ARQ 重传,而不能只依赖重新排列比特。