
通信工程 / 系统课时
绘制不同码型的 BER 与 FER 曲线
绘制不同码型的 BER 与 FER 曲线
不同码率的编码方案如果直接共用噪声标准差,画出的性能曲线就可能失真。这里以无编码 BPSK 与 Hamming(7,4) 为例,用相同的信息比特能量信噪比模拟 AWGN 信道,统计译码后的 BER、FER,并生成两张可核对的误码曲线。
学习目标
- 依据码率换算 与 AWGN 噪声标准差。
- 在等长信息帧上统计 BER、FER,绘制对数纵轴曲线。
- 区分误码率改善、误帧率改善与抽样误差。
固定信噪比与统计分母
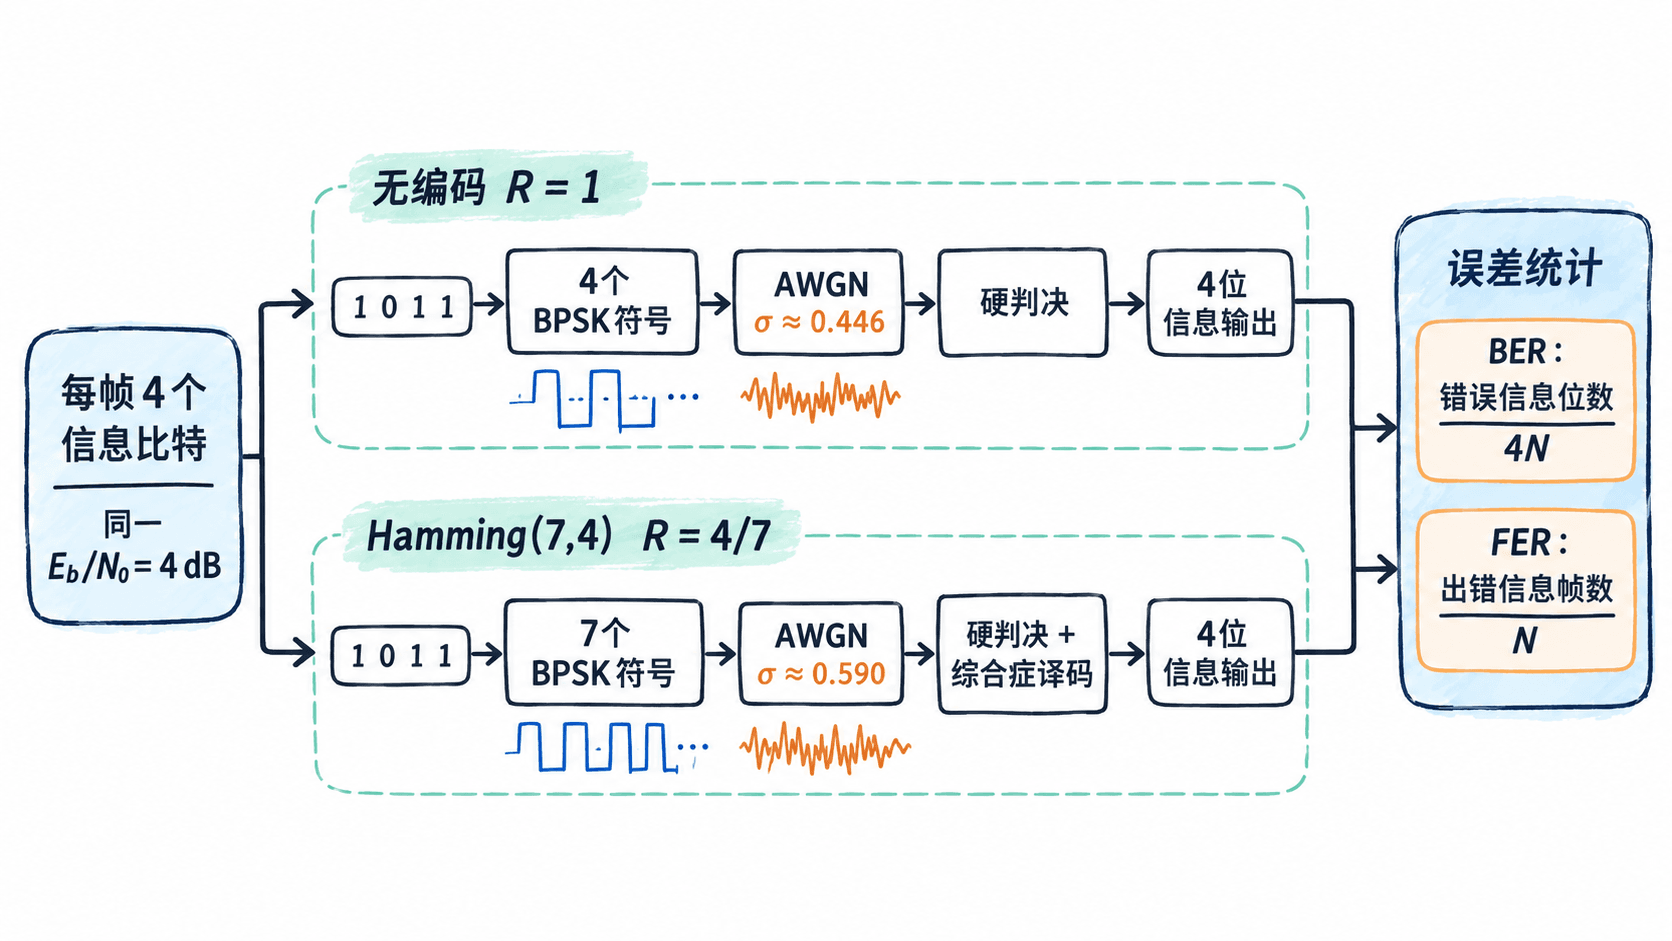
每帧固定传输 4 个信息比特。无编码方案直接发送 4 个 BPSK 符号,码率 ;Hamming(7,4) 编码后发送 7 个符号,码率 ,接收端使用硬判决与综合症译码,最多纠正 1 位码字错误。两种方案都经过独立的实值 AWGN 信道。
设 BPSK 符号为 与 ,所以符号能量 、信息比特能量 。若横轴数值 的单位是 dB,则信噪比线性值 和实高斯噪声的标准差 为:
例如 dB 时,无编码的 ,Hamming(7,4) 的 。两种噪声强度不相同,恰好是因为在符号幅度固定为 1 的条件下,它们的信息比特能量不同;这与固定 、按 缩放符号幅度等价。
BER 的分母是 个译码后信息位,FER 的分母是 个四位信息帧:只要一帧内至少一个信息位错误,就算一次帧错误。不能把 7 个接收码字位的误码率当作信息 BER,也不能将不同净荷长度的 FER 直接比较。
运行蒙特卡罗仿真
准备 Python 3.10 及以上版本,安装 NumPy、Matplotlib(命令:python -m pip install numpy matplotlib)。将下面的完整代码保存为 compare_ber_fer.py,运行 python compare_ber_fer.py。每个横轴点模拟 200000 帧;Hamming(7,4) 使用固定校验矩阵和单错误纠正,统计对象始终是原始 4 位净荷。
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
n_frames = 200_000
snr_db = [0, 2, 4, 6, 8]
# H 的七列依次是 1~7 的三位二进制表示(低位在上)。
H = ((np.arange(1, 8)[:, None] >> np.arange(3)) & 1).T
records = []

def detect_bpsk(bits, rate, gamma):
    # 星座为 ±1,噪声标准差由码率和信息位 Eb/N0 共同决定。
    sigma = np.sqrt(1 / (2 * rate * gamma))
    return (1 - 2 * bits + rng.normal(0, sigma, bits.shape) < 0).astype(np.int8)

for db in snr_db:
    info = rng.integers(0, 2, (n_frames, 4), dtype=np.int8)
    code = np.zeros((n_frames, 7), dtype=np.int8)
    code[:, [2, 4, 5, 6]] = info
    code[:, 0] = code[:, 2] ^ code[:, 4] ^ code[:, 6]
    code[:, 1] = code[:, 2] ^ code[:, 5] ^ code[:, 6]
    code[:, 3] = code[:, 4] ^ code[:, 5] ^ code[:, 6]

    gamma = 10 ** (db / 10)
    uncoded = detect_bpsk(info, 1.0, gamma)
    hard = detect_bpsk(code, 4 / 7, gamma)
    synd = (hard @ H.T) % 2
    pos = synd @ np.array([1, 2, 4])
    rows = np.flatnonzero(pos)
    # 非零综合症数值就是出错位置(位置从 1 开始)。
    hard[rows, pos[rows] - 1] ^= 1
    decoded = hard[:, [2, 4, 5, 6]]

    uerr, herr = uncoded != info, decoded != info
    records.append((uerr.mean(), uerr.any(axis=1).mean(),
                    herr.mean(), herr.any(axis=1).mean()))

result = np.array(records)
print("Eb/N0   unc_BER  unc_FER  ham_BER  ham_FER")
for db, (b0, f0, b1, f1) in zip(snr_db, result):
    print(f"{db:>5}   {b0:.6f} {f0:.6f} {b1:.6f} {f1:.6f}")

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
for ax, col0, col1, metric in [(axes[0], 0, 2, "BER"),
                                (axes[1], 1, 3, "FER")]:
    ax.semilogy(snr_db, result[:, col0], "o-", label="Uncoded")
    ax.semilogy(snr_db, result[:, col1], "s-", label="Hamming(7,4)")
    ax.set(xlabel="Eb/N0 (dB)", ylabel=metric)
    ax.grid(True, which="both", alpha=0.3)
    ax.legend()
fig.tight_layout()
fig.savefig("ber_fer.png", dpi=160)
print("Saved: ber_fer.png")
预期输出(固定随机种子的一次运行,依赖库版本变化可能导致末位波动):
Eb/N0   unc_BER  unc_FER  ham_BER  ham_FER
    0   0.078845 0.280120 0.119121 0.261575
    2   0.037422 0.141600 0.054761 0.123115
    4   0.012578 0.049385 0.015865 0.036405
    6   0.002464 0.009830 0.002599 0.005935
    8   0.000196 0.000785 0.000104 0.000245
Saved: ber_fer.png
程序会在当前目录写出 ber_fer.png:左图比较信息位 BER,右图比较四位净荷 FER;两张图的纵轴均为对数刻度。每个点使用相同的信噪比横坐标和帧数,但分别生成随机噪声,不能把两种方案的数据样本混为一次误码计数。
从两张曲线读取差异
在 4 dB 处,无编码的 BER 为 0.012578,Hamming(7,4) 为 0.015865,编码方案的信息位 BER 反而更差;但两者的 FER 分别为 0.049385 和 0.036405,编码方案的坏帧比例更低。这是因为一帧发生多个信息位错误时,BER 会计入多个错误,FER 仍只计一次,二者不能相互替代。
到 8 dB 时,Hamming 的 BER 为 0.000104,低于无编码的 0.000196;FER 为 0.000245,也低于无编码的 0.000785。交叉位置取决于码型、译码算法和信道条件,不能据此宣称 Hamming 在所有信噪比下都优于无编码。
在固定符号速率下,Hamming(7,4) 每传 4 个信息位需要 7 个符号,原始净荷速率只有无编码的 。因此即使 FER 较低,也需要连同重传开销、净吞吐量及译码复杂度一起选择方案。
核对理论基线与样本量
无编码 BPSK 在 AWGN 下的理论误码率为 。取 4 dB 可得约 0.012501,与仿真的 0.012578 接近。如果差距显著,优先检查是否忘记在噪声公式中乘码率 、是否把 dB 当成线性值、是否用码字位而不是信息位计数。
8 dB 时编码方案的 FER 为 0.000245,在 200000 帧中实际上只观察到 49 个错误帧,抽样波动仍明显。需要更稳的高信噪比曲线时,可将 n_frames 改为 1_000_000,并尽量让每个点累计至少 100 个错误帧;增加帧数后重新运行,参考数值也会改变。