
通信工程 / 系统课时
用软输入改进 Viterbi 路径度量
用软输入改进 Viterbi 路径度量
硬判决把 BPSK 接收符号压成 0 或 1,舍弃了它离判决门限有多远的信息。这里用接收幅度计算 Viterbi 分支代价,在相同的含噪样本上同时执行硬判决和软输入译码,观察两种度量为何会选出不同的信息序列。
学习目标
- 区分汉明距离与平方欧氏距离,能手算两个候选分支的代价。
- 在四状态卷积码的 Viterbi 译码器中切换硬、软度量并验证输出。
- 识别 BPSK 映射、尾比特和软信息标定错误造成的译码偏差。
接收幅度怎样变成分支代价
采用码率 、约束长度 的卷积码,生成多项式为八进制 ,每输入 1 位输出 2 位。BPSK 映射约定编码位 0 对应 ,编码位 1 对应 ;接收端观察到两维实数 。
硬判决先按门限 0 把负幅度判成 1,再数两位中有几位与候选编码输出不同。软输入不提前丢弃幅度,而是按候选编码位对应的理想符号,计算平方欧氏距离:
例如收到 ,硬判决得到 11:候选输出 00 的硬代价为 2,11 为 0;对应的软代价分别是 与 。硬判决把两个微弱的负值当作完全确定的 1,软度量则保留了“离零很近”的不可靠程度。
若另一拍收到 ,候选 01 的软代价为 0,而 10 为 8。一个可靠的符号对可抵消此前几次贴近门限的误判,这正是累计路径度量可能改变赢家的原因。
四状态网格怎样选择幸存路径
用状态 保存前两次输入,共有 00、01、10、11 四个状态。输入 时,两路编码输出依次为 和 ,新状态变为 。每个状态每拍最多有两条候选入边。
Viterbi 不逐条保存全部 种输入序列,而是在每个时刻对每个状态只留下累计代价最小的前驱:
初始状态 00 的度量设为 0,其余状态设为无穷大。若发送端在 6 位信息后补两个 0,编码器便回到 00;译码时也从最终状态 00 回溯,去掉末尾两位。下面的图局部放大两条路径分叉、重新汇合的几拍,以免把幅度可靠度和路径选择混为一谈。
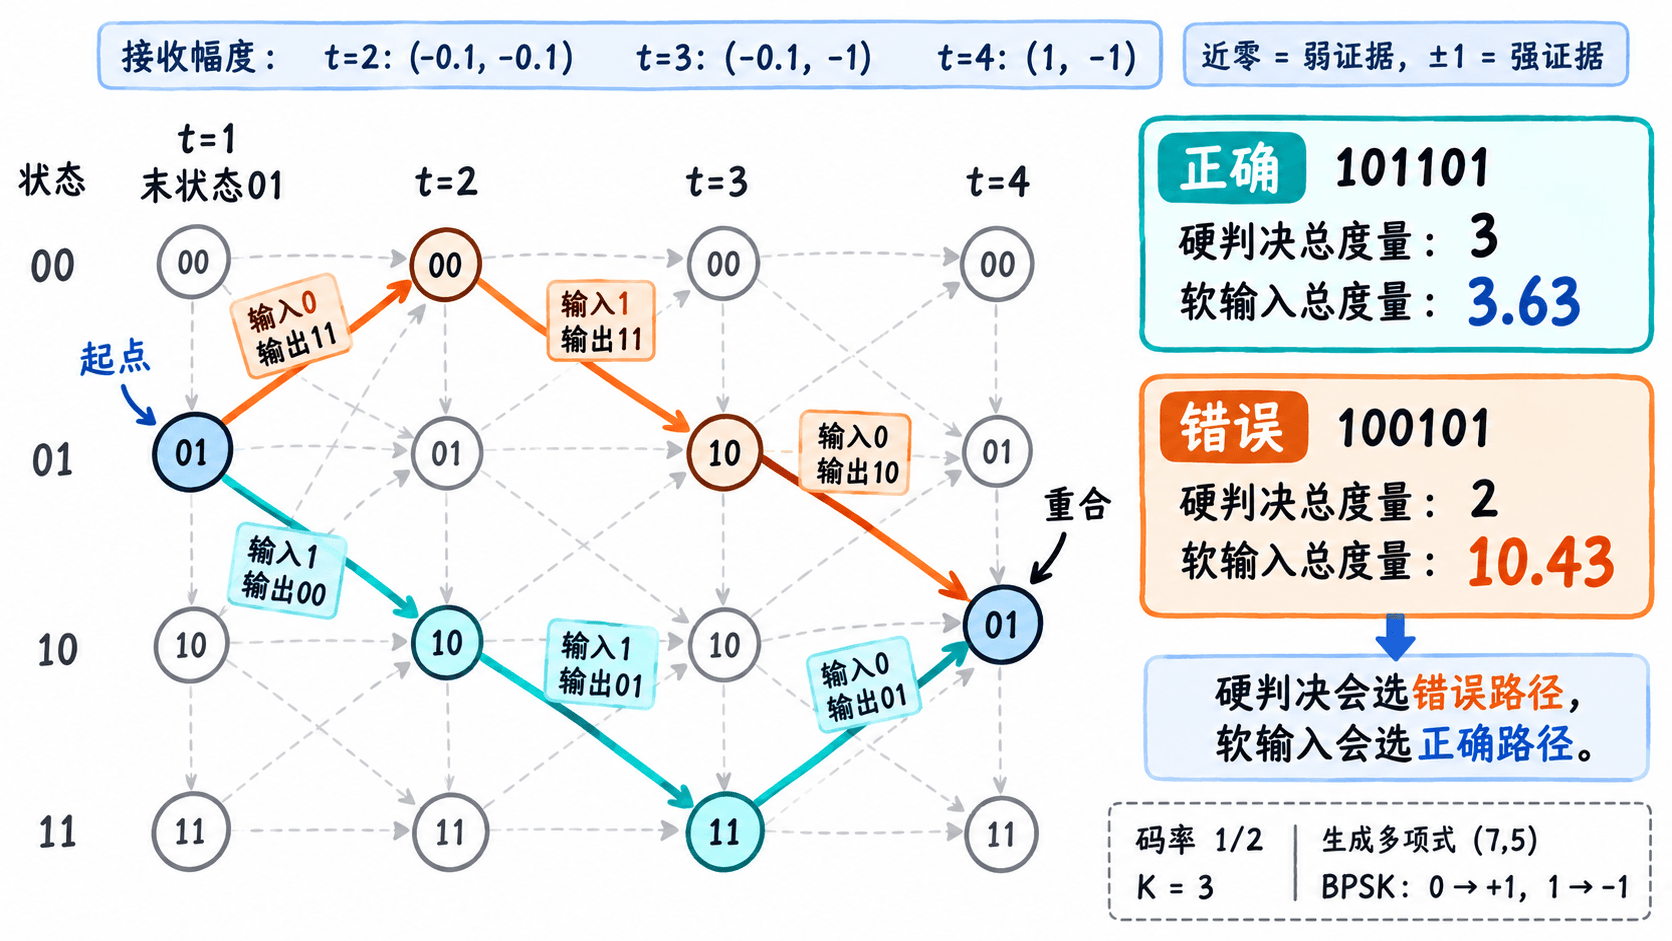
运行同一帧的两种译码
下面是仅用 Python 3 标准库即可运行的完整示例。信息位为 101101,尾比特为 00;发送的 8 组编码输出使用生成多项式 得到。接收样本中特意放入三个幅度很小、符号却反向的值,用于放大硬判决的信息损失。
from math import inf

received = [
    (-1.0, -1.0), (-1.0, 1.0), (-0.1, -0.1), (-0.1, -1.0),
    (1.0, -1.0), (1.0, 1.0), (-1.0, 1.0), (-1.0, -1.0),
]

def encode(bits):
    state, output = 0, []
    for bit in bits:
        d1, d2 = state >> 1, state & 1
        output.append((bit ^ d1 ^ d2, bit ^ d2))
        state = (bit << 1) | d1
    return output

def decode(samples, soft):
    metrics = {0: 0.0}
    traceback = []
    for y in samples:
        next_metrics, parents = {}, {}
        hard = tuple(int(v < 0) for v in y)
        for state, metric in metrics.items():
            d1, d2 = state >> 1, state & 1
            for bit in (0, 1):
                output = (bit ^ d1 ^ d2, bit ^ d2)
                next_state = (bit << 1) | d1
                if soft:
                    branch = sum((v - (1 - 2 * b)) ** 2 for v, b in zip(y, output))
                else:
                    branch = sum(a != b for a, b in zip(hard, output))
                candidate = metric + branch
                # 每个到达状态仅留下累计代价最低的前驱
                if candidate < next_metrics.get(next_state, inf):
                    next_metrics[next_state] = candidate
                    parents[next_state] = (state, bit)
        metrics = next_metrics
        traceback.append(parents)

    # 两个尾零使末态为 00,从此状态回溯并去掉尾位
    state, bits = 0, []
    for parents in reversed(traceback):
        state, bit = parents[state]
        bits.append(bit)
    return "".join(map(str, reversed(bits)))[:-2], round(metrics[0], 2)

info = [1, 0, 1, 1, 0, 1]
coded = encode(info + [0, 0])
print("encoded:", " ".join("".join(map(str, p)) for p in coded))
print("hard bits:", " ".join("".join(str(int(v < 0)) for v in y) for y in received))
print("hard:", decode(received, False))
print("soft:", decode(received, True))
预期输出:
encoded: 11 10 00 01 01 00 10 11
hard bits: 11 10 11 11 01 00 10 11
hard: ('100101', 2.0)
soft: ('101101', 3.63)
核对时不要直接比较 2.0 与 3.63 的大小:汉明距离和平方欧氏距离不是同一单位,应在各自度量内部选最小路径。真正的验证点是硬译码输出 100101 与发送信息不同,软译码输出 101101 与发送信息一致。对于这两条候选路径,硬代价分别为 2、3,软代价分别为 10.43、3.63。
换成实际接收机时要检查什么
平方欧氏距离对应已知幅度、独立同方差高斯噪声的 BPSK 模型。若信道增益已变,先进行同步、均衡或使用正确的符号参考值;若各观测的噪声方差不同,应按各自方差加权,而不是直接把不同可信度的样本等权平方相加。
如果解调器输出的是对数似然比 LLR,而非实数幅度,要先统一符号约定:例如 表示正值支持 0,可用与 等价的分支负对数似然代价。不要把 LLR 当作 BPSK 幅度直接代入平方欧氏公式。还要核对两项容易漏掉的条件:发送端是否真的补了两个尾零,以及编码器的 抽头和状态位顺序是否与译码器一致。
这组固定样本只证明软信息能够改变一次路径选择,不能代表平均误码增益。若要评估实际收益,应在相同信息长度、码率、调制方式和 下复用同一批噪声样本,分别统计多帧的 BER 或 FER,而不是比较两次独立随机试验。