
通信工程 / 系统课时
用冻结位构造 Polar 编码结构
用冻结位构造 Polar 编码结构
构造 Polar 码时,需要先选出可靠的信息位位置,再将其余位置设为已知冻结位,最后执行极化变换。这里用擦除概率为 0.5 的二元擦除信道构造 Polar(8,4),追踪三层异或网络,并通过 Python 验证最终的八位码字。
学习目标
- 根据位信道可靠性选择信息位与冻结位,理解冻结位为什么不必连续排列。
- 将四位消息放入八位编码输入,追踪三层极化变换及其输出。
- 使用 Python 复现编码结果,识别不同信道模型和位序约定带来的差异。
先明确冻结位与信息位的关系
Polar 码通过递归组合信道,使不同输入位置对应的合成位信道呈现不同可靠性。编码器把消息放在可靠性较高的位置,把较差位置设为发送方和接收方事先约定的冻结值。冻结位通常取 0,但并不要求连续分布。
本例采用以下参数:
| 参数 | 取值 | 含义 |
|---|---|---|
| 码长 | 8 | 输出 8 个编码比特 |
| 信息长度 | 4 | 承载 4 个消息比特 |
| 码率 | 0.5 | |
| 设计信道 | BEC(0.5) | 擦除概率为 0.5 |
| 冻结值 | 0 | 双方预先知道的固定值 |
| 位索引 | 0~7 | 从 0 开始编号 |
要区分两个长度均为 8 的向量: 是极化变换之前的输入,其中包含信息位和冻结位; 是经过变换的发送码字。冻结的是输入向量 的指定位置,并不是要求输出码字 的对应位置保持为 0。
根据信道可靠性选择冻结位置
对于二元擦除信道 BEC,合成位信道的巴氏参数 等于该位信道的擦除概率。 越小,位信道越可靠,越适合承载信息。
每进行一次信道极化,就把一个父信道分成两个合成子信道,其递推规则为:
其中 对应较差的子信道, 对应较好的子信道。以初始值 为例,第一轮得到 和 ;继续按先差后好的顺序展开,总共三轮即可得到 8 个位信道。
按照本例的位索引约定,计算结果如下:
| 位索引 | 可靠性参数 | 位置分配 |
|---|---|---|
| 0 | 0.996094 | 冻结位 |
| 1 | 0.878906 | 冻结位 |
| 2 | 0.808594 | 冻结位 |
| 3 | 0.316406 | 信息位 |
| 4 | 0.683594 | 冻结位 |
| 5 | 0.191406 | 信息位 |
| 6 | 0.121094 | 信息位 |
| 7 | 0.003906 | 信息位 |
选择 最小的四个位置,得到信息位集合 ;剩余位置构成冻结位集合 。
注意,索引 3 的可靠性高于索引 4,因此它是信息位,而索引 4 仍被冻结。**不能简单地把前四个位置设为信息位、后四个位置设为冻结位。**实际构造要依据可靠性排序,而不是位置大小。
追踪三层极化变换
假设待发送消息为 1011,按信息位索引从小到大的顺序,将消息依次放入位置 3、5、6、7,再把冻结位置填为 0,得到:
本例采用不附加比特倒序置换的生成矩阵约定:
所有加法都在二元域 中进行,也就是异或运算。例如 ,。
由于 ,需要执行三层蝶形变换。每一层把间隔为 的两个位置组成一对,对上路执行异或,下路原值透传。
- 第一层:间隔 。 配对 (0,1)、(2,3)、(4,5)、(6,7),变换后为
00110001。 - 第二层:间隔 。 配对 (0,2)、(1,3)、(4,6)、(5,7),变换后为
11110101。 - 第三层:间隔 。 配对 (0,4)、(1,5)、(2,6)、(3,7),最终得到
10100101。
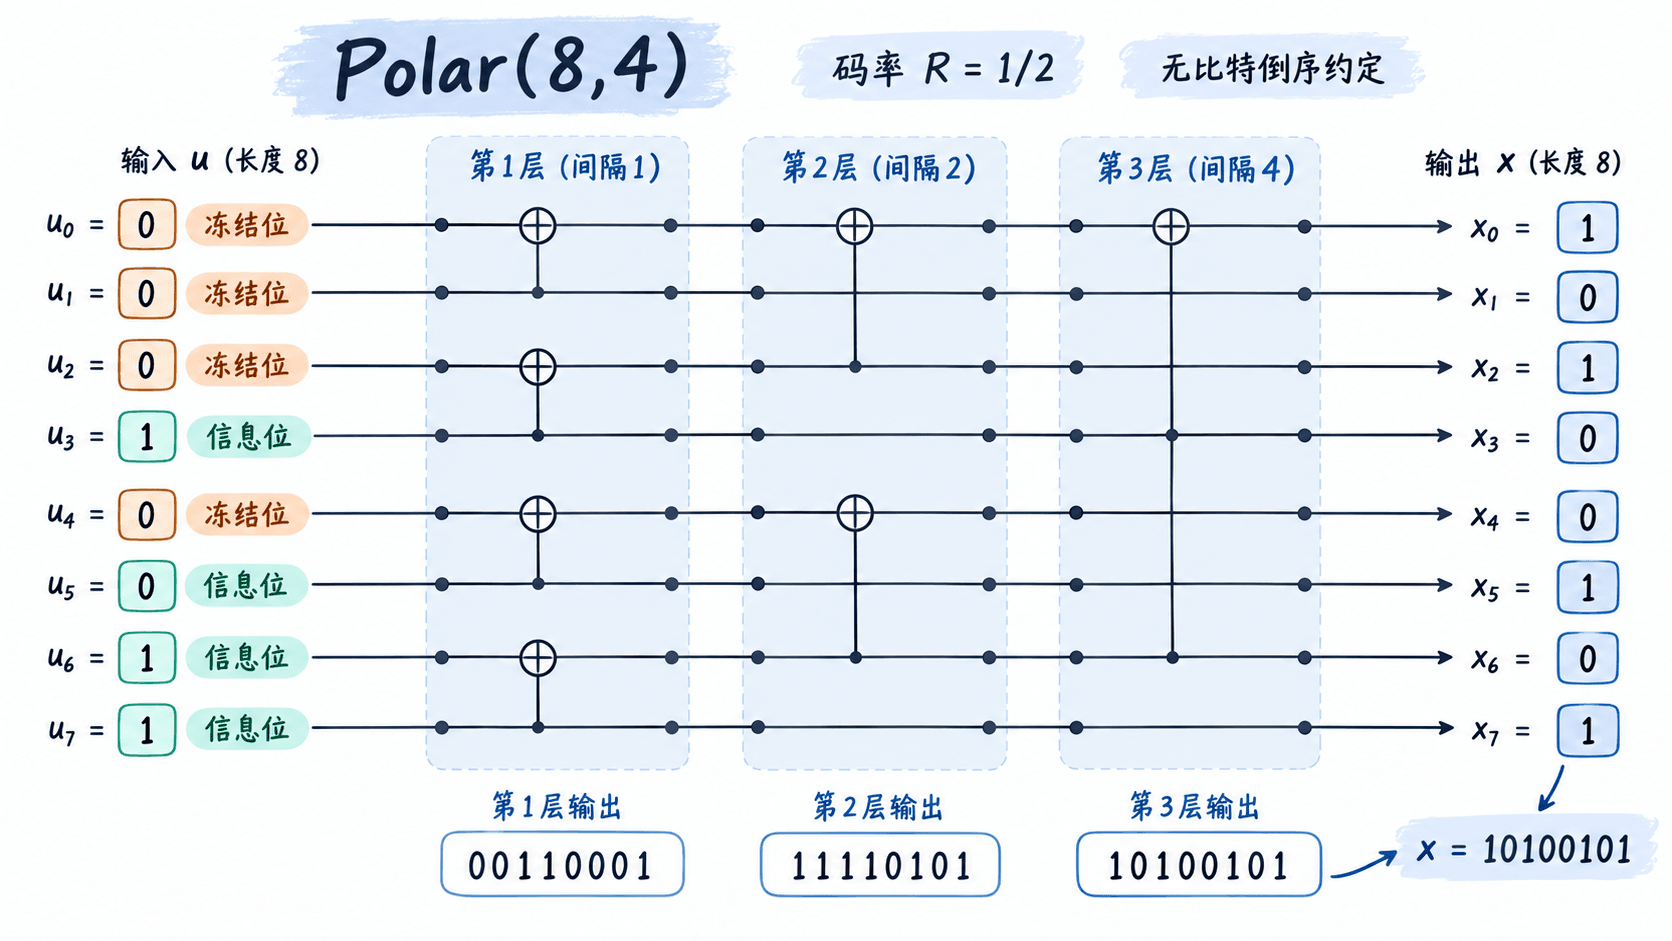
这个变换本质上是结构化的二元矩阵乘法,不需要直接生成完整的 矩阵。对于长度为 的码字,蝶形网络包含 层,每层执行 次异或,因此编码时间复杂度为 ,暂存向量需要 空间。
用 Python 复现编码结果
下面使用 Python 3.8 及以上版本的标准库完成可靠性计算、冻结位选择与极化编码。代码沿用前述先差后好的信道递推顺序,并且不执行额外的比特倒序置换。
def bec_reliability(n, erasure):
    z = [erasure]
    while len(z) < n:
        # 每个父信道依次产生较差和较好的两个子信道
        z = [value for p in z for value in (2*p-p*p, p*p)]
    return z


def polar_encode(u):
    x = u.copy()
    step = 1
    while step < len(x):
        for base in range(0, len(x), 2 * step):
            for i in range(base, base + step):
                # 上路异或,下路保持不变
                x[i] ^= x[i + step]
        step *= 2
    return x


n, k, erasure = 8, 4, 0.5
z = bec_reliability(n, erasure)
info = sorted(sorted(range(n), key=lambda i: z[i])[:k])
frozen = [i for i in range(n) if i not in info]

message = [1, 0, 1, 1]
u = [0] * n
for i, bit in zip(info, message):
    u[i] = bit

x = polar_encode(u)
print("信息位索引:", info)
print("冻结位索引:", frozen)
print("u:", "".join(map(str, u)))
print("x:", "".join(map(str, x)))
print("回变换校验:", polar_encode(x) == u)
预期输出:
信息位索引: [3, 5, 6, 7]
冻结位索引: [0, 1, 2, 4]
u: 00010011
x: 10100101
回变换校验: True
最后一项为 True,因为在二元域中本例使用的极化变换矩阵满足自逆性质,对结果再做一次相同变换可以恢复 。这只是编码变换的代数正确性检查,不等于经过含噪信道后已经成功纠错;实际接收端还需要 SC、SCL 等译码算法。
读者可以将消息改成 0000,检查最终码字是否也为 00000000。也可以将消息改成 1000,预期输出码字为 11110000,以验证单个信息位如何影响多个编码位置。
什么时候必须重新构造冻结位
冻结位集合由设计信道、码长、码率和索引约定共同决定。上面得到的集合只针对本例的 BEC(0.5) 可靠性模型,不能直接把这些擦除概率当成 BPSK 在 AWGN 信道上的误码概率。
工程实现中尤其需要检查三个边界:
- 信道模型变化: 如果改用 AWGN 信道,应使用与目标信噪比匹配的可靠性构造方法,例如高斯近似,或者采用目标通信标准规定的可靠性序列。
- 位序约定变化: 有些实现会在极化变换中引入比特倒序置换 。采用不同生成矩阵与索引约定时,输入位置和输出码字的对应关系可能不同,不能直接混用冻结位表。
- 编码与译码不匹配: 接收端必须知道同一组冻结位位置和冻结值。如果发送端把位置 4 设为冻结位,译码器却把它当成信息位,译码路径就不再对应发送的码结构。
联调时先用本例的固定测试向量检查:输入 00010011,编码结果必须为 10100101。通过这一最小测试后,再扩展到更长码长,并通过 BER 或 BLER 仿真评估不同冻结位构造和译码算法的实际可靠性。