
通信工程 / 系统课时
用 BCH 码解释多比特纠错
用 BCH 码解释多比特纠错
当一个 15 位码字同时发生两处比特翻转时,简单奇偶校验可能完全漏检,更无法给出两个位置。这里以 BCH(15,7) 为例,从设计距离和有限域根构造校验关系,再用 Python 算出错误位置并恢复 7 位信息。
学习目标
- 根据 BCH 的设计距离判断可保证纠正的错误位数与编码开销。
- 解释 GF(16) 中的共轭根怎样决定生成多项式和伴随式。
- 运行双比特错误示例,核对定位位置、修复码字和校验结果。
设计距离怎样约束纠错能力
选择二元本原窄义 BCH 码,令扩域阶数 ,码长为 。指定设计距离 ,BCH 界保证最小汉明距离 ,因而能保证纠正任意不超过 2 位的错误;这不是说每 5 位就可纠正 2 位,而是整个 15 位码字内至多两位。
本例生成多项式的次数为 8,所以信息位数 ,码率 。编码器把 7 位信息扩成 15 位,其中 8 位是校验冗余。对这个具体的 BCH(15,7) 码,实际最小距离也等于 5。
有限域的根怎样生成校验关系
为了使用长度为 15 的循环码,取 ,令 为多项式 的一个根,所以 且 。域元素可用 4 位二进制数表示:加法是异或,乘法后按 约简。
让每个合法码字多项式 满足 ,其中 。二元系数还有一个特性:若 是根,则其平方、四次方等也必为根。因此四个指定根会落入两组共轭类:
- ,最小多项式 。
- ,最小多项式 。
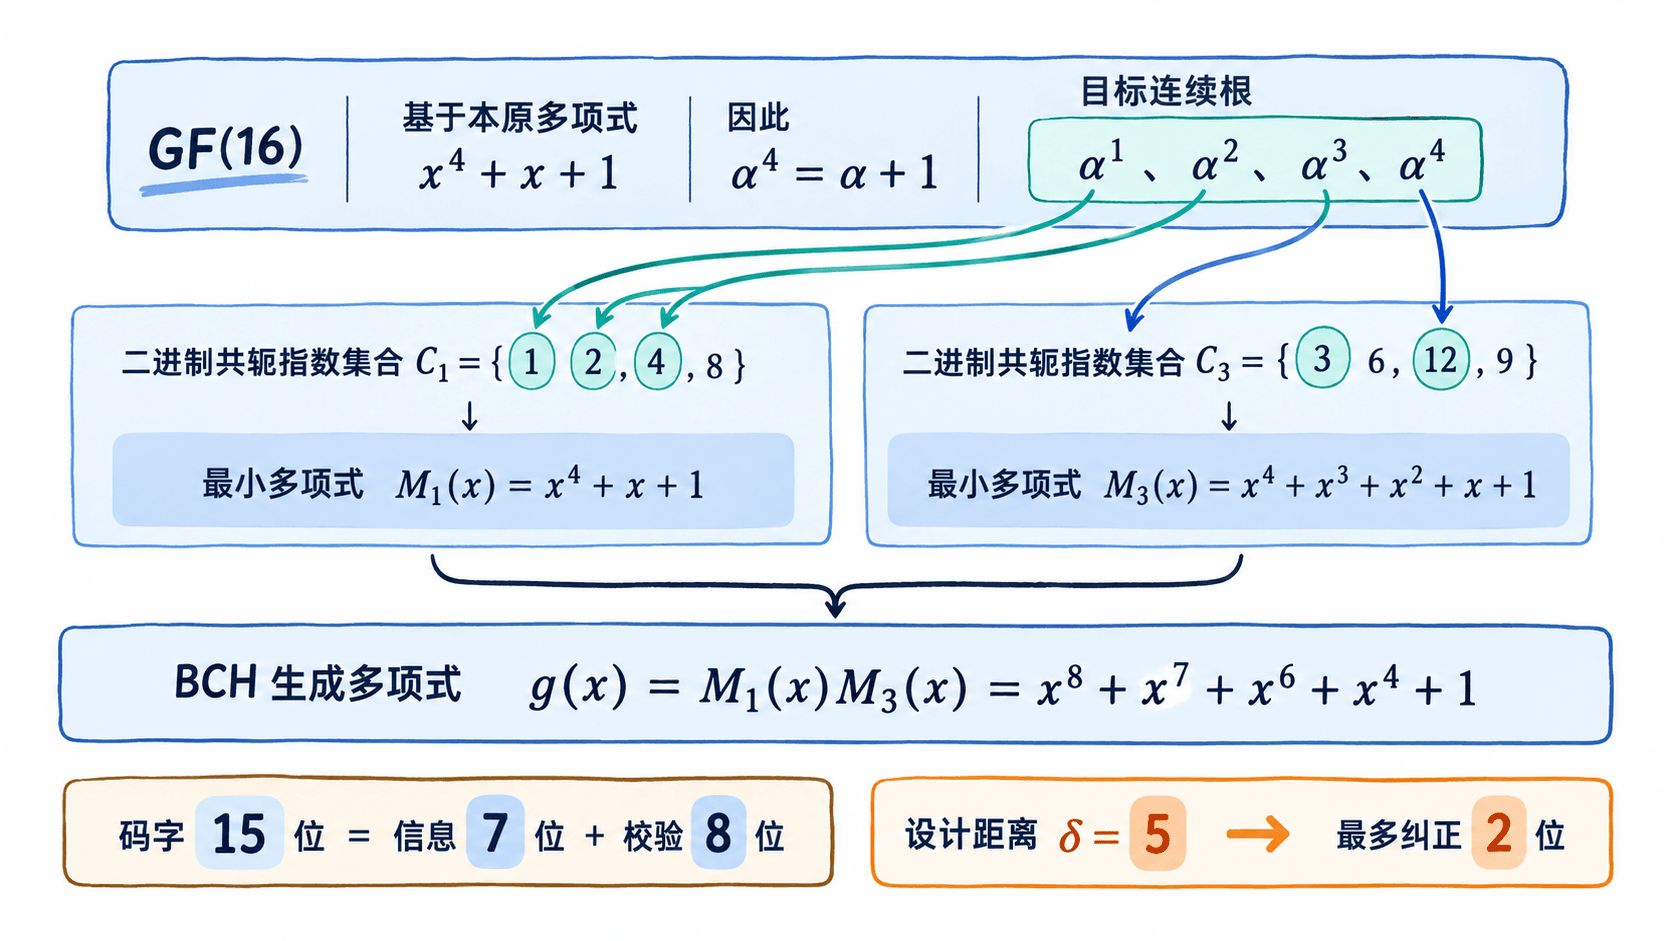
两组最小多项式互不相同,生成多项式取其乘积:
二进制系数从高次到低次写成 111010001。对 7 位信息多项式 ,先计算 除以 的模二余数,再把余数异或到低 8 位,即得到可被 整除的系统码字。
用伴随式定位两处错误
接收多项式记为 。计算四个伴随式 ():无错码字的四个结果全为零。对于二元码,、,所以定位两位错误只需要独立计算 和 。
若从右起第 、 位翻转,令 、,则 、。两位错误的定位多项式为:
这些运算都在 中进行,不能把除法当作普通整数除法。依次测试 到 ,使 的位置就是错误位。单错时 ,同一方法退化为一次式;超出两错时则不保证可靠定位。
使用 Python 验证两比特纠错
以下程序只使用 Python 3 标准语法,不依赖第三方包。以 实现域乘法,以模二长除法做系统编码,然后把右起第 2、9 位翻转。将代码保存为 bch_demo.py,运行 python bch_demo.py。
N, K = 15, 7
G = 0b111010001
PRIM = 0b10011  # GF(16) 约简多项式 x^4+x+1

def gf_mul(a, b):
    result = 0
    for _ in range(4):
        if b & 1:
            result ^= a
        b >>= 1
        a <<= 1
        if a & 0b10000:
            a ^= PRIM
    return result

def gf_pow(a, exponent):
    result = 1
    for _ in range(exponent):
        result = gf_mul(result, a)
    return result

def gf_div(a, b):
    if b == 0:
        raise ZeroDivisionError("有限域除零")
    return gf_mul(a, gf_pow(b, 14))  # 非零域元素的逆是 b^14

def poly_mod(value, divisor):
    while value.bit_length() >= divisor.bit_length():
        value ^= divisor << (value.bit_length() - divisor.bit_length())
    return value

def evaluate(bits, point):
    result = 0
    for j in range(N - 1, -1, -1):
        result = gf_mul(result, point) ^ ((bits >> j) & 1)
    return result

def syndromes(bits):
    return [evaluate(bits, gf_pow(2, i)) for i in range(1, 5)]

def decode(received):
    checks = syndromes(received)
    if checks == [0] * 4:
        return received, []
    s1, _, s3, _ = checks
    if s1 == 0:
        raise ValueError("超出最多两位错误的假设")
    sigma2 = gf_div(gf_pow(s1, 3) ^ s3, s1)
    positions = []
    # Chien 式逐位置求根;第 j 位对应 z=alpha^(-j)
    for j in range(N):
        z = gf_pow(2, (-j) % N)
        if 1 ^ gf_mul(s1, z) ^ gf_mul(sigma2, gf_mul(z, z)) == 0:
            positions.append(j)
    if not 1 <= len(positions) <= 2:
        raise ValueError("未找到有效的错误位置")
    corrected = received
    for j in positions:
        corrected ^= 1 << j
    if syndromes(corrected) != [0] * 4:
        raise ValueError("纠错后复检失败")
    return corrected, positions

message = 0b1011001
shifted = message << (N - K)
codeword = shifted ^ poly_mod(shifted, G)
received = codeword ^ (1 << 2) ^ (1 << 9)
restored, positions = decode(received)

print("信息位:", format(message, "07b"))
print("编码码字:", format(codeword, "015b"))
print("接收码字:", format(received, "015b"))
print("伴随式 S1~S4:", [format(s, "04b") for s in syndromes(received)])
print("错误位置(右起,0基):", positions)
print("纠正码字:", format(restored, "015b"))
print("恢复信息:", format(restored >> 8, "07b"))
print("复检通过:", syndromes(restored) == [0] * 4)
预期输出:
信息位: 1011001
编码码字: 101100100011110
接收码字: 101101100011010
伴随式 S1~S4: ['1110', '1011', '0011', '1001']
错误位置(右起,0基): [2, 9]
纠正码字: 101100100011110
恢复信息: 1011001
复检通过: True这里的位序是最右侧为第 0 位,与代码中 1 << j 的位编号一致。双错定位要对 15 个位置逐个验根;对固定 而言,这一步随码长线性增长。更长的 BCH 码通常用 Berlekamp–Massey 算法求定位多项式,再做 Chien 搜索。
三位错误为什么不能照样处理
把程序中的接收码字改为翻转第 2、9、11 位,可用来观察越界情形,但不要把报错或校验不通过视为一定发生。超过两位时,错误模式可能被误判成另一组可纠正错误;即使修正后四个伴随式全为零,也只能说明落在某个合法码字上,无法证明恢复了原始信息。
实用验收方式是分别检查零错、全部 15 种单错和全部 105 种双错,均须恢复原始 15 位码字。这个保证来自 ;更多错误需要更大的设计距离、更多冗余,或在链路中额外加入完整性检测。