
通信工程 / 系统课时
用伴随式定位单比特错误
用伴随式定位单比特错误
接收端拿到七位比特后,校验失败只能说明接收序列不满足码字约束,还不能直接知道哪一位出错。利用线性分组码的伴随式,可以把校验结果映射为具体的错误位置。本课以 (7,4) 汉明码为例,完成伴随式计算、单比特错误定位、码字恢复和 Python 验证。
学习目标
- 理解伴随式与校验矩阵列向量之间的对应关系。
- 根据三位伴随式定位七位码字中的单比特错误,并通过翻转恢复原码字。
- 使用 Python 验证纠错过程,识别多比特错误造成的误纠正风险。
约定校验矩阵与位序
线性分组码使用校验矩阵 判断接收序列是否满足奇偶校验约束。对于 (7,4) 汉明码,每个码字包含 4 位信息位和 3 位校验位,因此校验矩阵有 3 行、7 列。
本例采用系统形式,码字从左到右依次为第 1 至第 7 位,前 4 位是信息位,后 3 位是校验位。使用以下校验矩阵:
该矩阵采用 的结构,对应的系统形生成矩阵为 。其中 和 分别是四阶、三阶单位矩阵。
观察 的七个列向量:
| 码字位置 | 对应列向量 |
|---|---|
| 第 1 位 | 110 |
| 第 2 位 | 101 |
| 第 3 位 | 011 |
| 第 4 位 | 111 |
| 第 5 位 | 100 |
| 第 6 位 | 010 |
| 第 7 位 | 001 |
七个列向量恰好是全部七种非零三位二进制向量,而且互不相同。因此,只要能计算出一个非零的三位伴随式,就可以在假设最多发生一位错误的情况下,找到唯一匹配的列。
例如,合法发送码字取 ,即 1011010。它满足 ,三条奇偶校验均通过。
计算接收字的伴随式
假设发送码字为 1011010,传输中从左往右数第 3 位由 1 翻转为 0,接收端得到 1001010。
将接收向量记为 ,在二元域 上计算伴随式:
这里的乘法按普通二进制位乘法进行,加法按模二运算进行,即 、、。计算时也可以直接使用异或操作。
对于当前接收字,三条校验分别为:
- 第一行检查第 1、2、4、5 位:。
- 第二行检查第 1、3、4、6 位:。
- 第三行检查第 2、3、4、7 位:。
因此,伴随式为:
也就是 011。因为伴随式不为零,接收字没有通过校验,需要进一步定位错误。
按列定位并翻转错误位
伴随式之所以能定位单比特错误,来自线性分组码的一个性质:所有合法码字都满足 。
设只有第 位出错,错误向量 仅在第 位为 1,其余位均为 0。接收字为 ,则:
其中 表示校验矩阵的第 列。因为合法码字的校验结果为零,伴随式实际上只保留了错误向量产生的校验结果。
本例得到 011,它与 的第 3 列完全相同,因此定位到第 3 位错误。
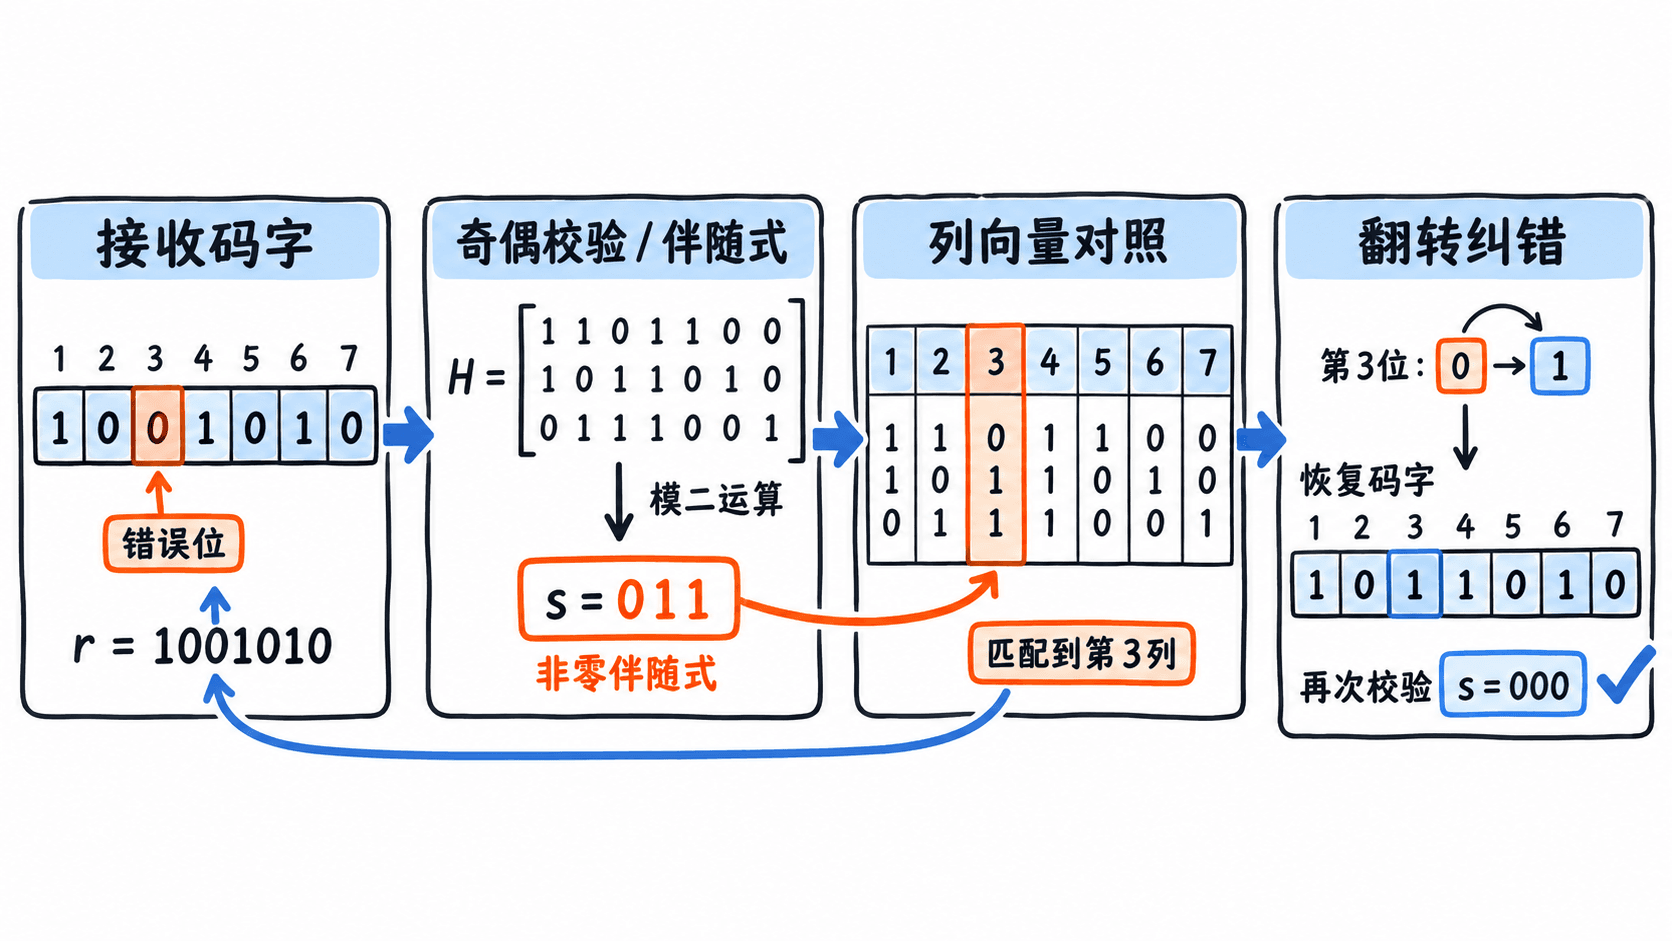
实际纠错只需要三个步骤:
- 将伴随式
011与校验矩阵的七列逐一比较,找到第 3 列。 - 翻转接收字的第 3 位,将
1001010改为1011010。 - 对恢复后的码字重新计算 ,确认伴随式变为
000。
由于采用系统码,恢复后的前四位 1011 就是原始信息位,不需要再执行额外的逆矩阵运算。
用 Python 验证纠错过程
使用 Python 3 标准库即可完成这个实验,不需要安装 NumPy 等第三方依赖。下面的程序定义校验矩阵、模拟单比特翻转、计算伴随式,并自动建立列向量到错误位置的映射。
H = [
    [1, 1, 0, 1, 1, 0, 0],
    [1, 0, 1, 1, 0, 1, 0],
    [0, 1, 1, 1, 0, 0, 1],
]

# 使用满足 Hc^T=0 的合法七位码字
c = [1, 0, 1, 1, 0, 1, 0]
r = c.copy()
r[2] ^= 1  # 模拟第3位发生翻转

def syndrome(bits):
    return tuple(
        sum(row[j] * bits[j] for j in range(7)) % 2
        for row in H
    )

s = syndrome(r)

# 按实际矩阵列建立查找表,索引从0开始
column_to_position = {
    tuple(row[j] for row in H): j
    for j in range(7)
}

error_position = (
    column_to_position.get(s)
    if s != (0, 0, 0) else None
)

corrected = r.copy()
if error_position is not None:
    corrected[error_position] ^= 1

print("发送码字:", "".join(map(str, c)))
print("接收码字:", "".join(map(str, r)))
print("伴随式:", "".join(map(str, s)))
print("错误位置:", "未发现" if error_position is None
      else f"第{error_position + 1}位")
print("纠正码字:", "".join(map(str, corrected)))
print("复验伴随式:", "".join(map(str, syndrome(corrected))))
预期输出:
发送码字: 1011010
接收码字: 1001010
伴随式: 011
错误位置: 第3位
纠正码字: 1011010
复验伴随式: 000
程序使用 r[2] 操作第三位,因为 Python 列表下标从 0 开始;输出位置时使用 error_position + 1,转换为读者习惯的从 1 开始计数。
syndrome 函数逐行执行模二点积,返回长度为 3 的元组。查找表以矩阵列向量作为键、列表下标作为值,能够避免对错误位置进行硬编码。
可以把 r[2] ^= 1 改为 r[5] ^= 1 再执行程序。此时应得到伴随式 010,错误位置变为第 6 位,纠正码字仍是 1011010。这能检查列映射是否真的覆盖了不同错误位置。
识别多比特错误的边界
标准 (7,4) 汉明码的最小码距为 3,因此可以保证纠正任意一个比特错误,但不能可靠地纠正两个比特错误。非零伴随式不代表接收字一定只错了一位。
例如,若原码字 1011010 的第 1 位和第 2 位同时翻转,接收字将变为 0111010。两处错误产生的伴随式为:
这个结果恰好等于校验矩阵的第 3 列。单比特纠错算法会错误地认为第 3 位出错,进而将接收字改为 0101010。虽然修改后的伴随式也等于 000,但它并不是原始发送码字。
因此,需要区分以下情形:
| 伴随式与实际错误 | 处理结果 |
|---|---|
000,实际没有错误 |
直接接受码字 |
| 非零,实际只有一位错误 | 可以唯一定位并纠正 |
| 非零,实际有两位错误 | 可能被误判为另一处单比特错误 |
000,实际有多位错误 |
可能存在未被发现的错误 |
如果系统要求纠正一位错误并检测两位错误,可以增加整体奇偶校验位,采用扩展汉明码,例如 (8,4) SECDED(单错纠正、双错检测)。对于存在更多随机错误或突发错误的通信系统,还需要结合 CRC、交织或重传机制进行设计。
实际实现中应同时检查伴随式、错误位置映射和纠错能力边界。只要固定校验矩阵与位序,单比特错误就能通过一次矩阵乘法、一次列匹配和一次比特翻转完成恢复。