
通信工程 / 系统课时
从误码曲线计算净编码增益
从误码曲线计算净编码增益
比较两种信道编码方案时,不能只看哪条误码曲线更靠左,还必须确认横轴的能量定义,并考虑码率带来的冗余开销。本篇使用指定 BER 目标和一组示意测点,通过对数插值计算净编码增益,并用 Python 复核结果。
学习目标
- 在相同目标 BER 下,从误码曲线读取所需的 。
- 区分每信息比特能量与每发送码比特能量,正确处理码率开销。
- 使用 Python 对离散测点插值,计算并解释净编码增益。
对齐误码率与能量口径
编码增益衡量的是:达到同样的信息比特误码率时,编码系统比未编码系统少需要多少信噪比。比较时必须固定调制方式、信道模型、目标 BER 和接收判决条件,并使用译码后的信息比特 BER,而不是编码器输出或译码器输入端的原始误码率。
设分组码每 个信息比特生成 个码比特,码率为 。令 表示每信息比特能量, 表示每发送码比特能量。在相同平均发射功率下,有 。
如果编码曲线原始横轴采用每码比特的 ,必须先换算为每信息比特的 。用 dB 表示时:
其中 是以每码比特能量为基准的横轴读数, 是以每信息比特能量为基准的读数。
例如码率 ,每发送两个码比特只携带一个信息比特,换算量为 dB。如果编码曲线已经使用每信息比特的 ,则不需要再加 3.01 dB,也不能在计算增益后重复扣除它。
从半对数误码曲线读取门限
设置目标信息比特误码率 。下面采用 BPSK、AWGN 条件下的一组教学示意测点,仅用于演示读数与计算,不代表某种具体编码器的实际仿真性能。
| 方案 | 原始横轴(dB) | BER |
|---|---|---|
| 未编码, | 9.0 | |
| 未编码, | 10.0 | |
| 编码,, | 3.0 | |
| 编码,, | 4.0 |
误码曲线的纵轴通常为对数刻度,横轴 为线性 dB 刻度。因此,在相邻测点之间应对 做线性插值,而不是直接对 BER 数值做线性插值。
对于相邻两点 和 ,目标处的横坐标为:
本例得到未编码门限约 9.57 dB;编码曲线在原始每码比特能量口径下的门限为 3.50 dB。将后者加上码率折算量 3.01 dB,得到每信息比特门限 6.51 dB。
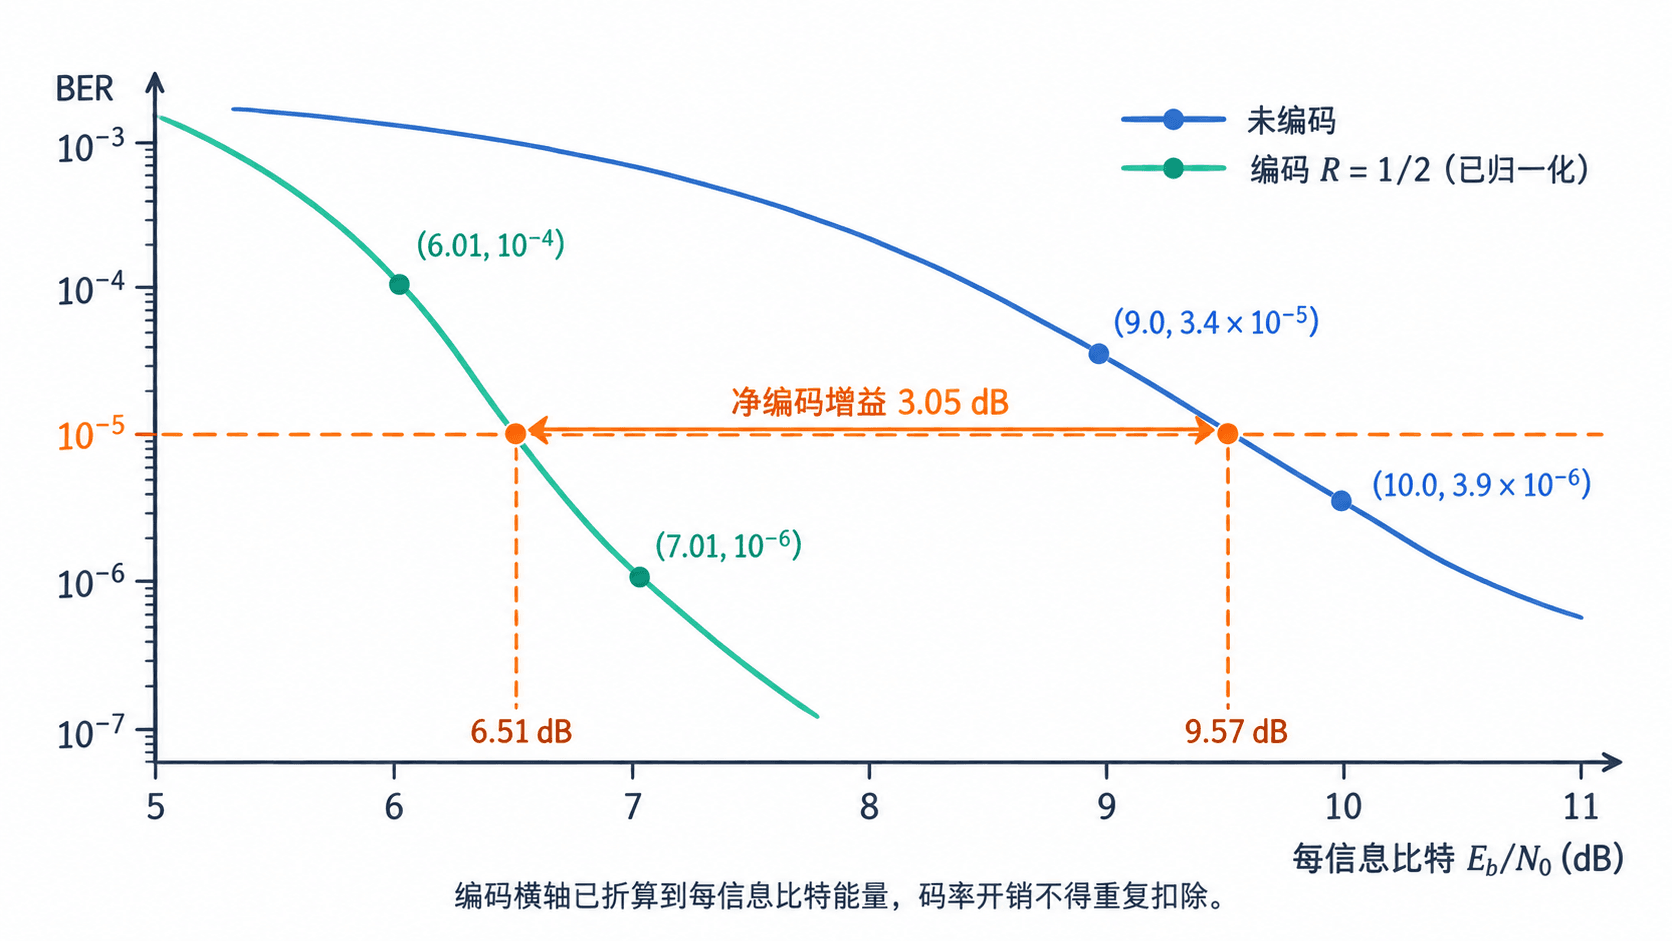
净编码增益就是经过统一能量口径后,两条曲线在目标 BER 处的横向差值:
代入本例,得到 dB。这意味着在相同的信息比特误码率目标下,示例编码方案所需的每信息比特信噪比降低约 3.05 dB,而不是可以直接提升 3.05 dB 的数据吞吐率。
使用 Python 计算净编码增益
手动读图会受到坐标分辨率影响。对于保存在 CSV 或仿真程序中的离散 BER 测点,可以直接使用 Python 标准库实现对数插值,统一能量口径后再相减。
使用 Python 3.8 或更新版本运行以下完整示例,无须安装第三方依赖:
import math

target_ber = 1e-5
rate = 1 / 2
uncoded = [(9.0, 3.4e-5), (10.0, 3.9e-6)]
coded_tx = [(3.0, 1e-4), (4.0, 1e-6)]

def at_target(points, target):
    (x0, p0), (x1, p1) = points
    if not (min(p0, p1) <= target <= max(p0, p1)):
        raise ValueError("目标 BER 未被测点夹住")
    # 在对数 BER 轴插值,横轴保持 dB 线性刻度
    w = (math.log10(target) - math.log10(p0)) / (math.log10(p1) - math.log10(p0))
    return x0 + w * (x1 - x0)

uncoded_db = at_target(uncoded, target_ber)
coded_tx_db = at_target(coded_tx, target_ber)

# 每码比特能量换算为每信息比特能量
rate_adjust_db = 10 * math.log10(1 / rate)
coded_info_db = coded_tx_db + rate_adjust_db
net_gain_db = uncoded_db - coded_info_db

print(f"未编码所需 Eb/N0: {uncoded_db:.2f} dB")
print(f"编码每码比特 Ec/N0: {coded_tx_db:.2f} dB")
print(f"码率折算: +{rate_adjust_db:.2f} dB")
print(f"编码每信息比特 Eb/N0: {coded_info_db:.2f} dB")
print(f"净编码增益: {net_gain_db:.2f} dB")
预期输出:
未编码所需 Eb/N0: 9.57 dB
编码每码比特 Ec/N0: 3.50 dB
码率折算: +3.01 dB
编码每信息比特 Eb/N0: 6.51 dB
净编码增益: 3.05 dB
如果不考虑码率,直接用 9.57 减去 3.50,会得到约 6.07 dB。这个数值只是两种不同能量口径下的原始水平差,不能作为最终净编码增益。对码率 1/2 而言,扣除约 3.01 dB 的折算量,才得到 3.05 dB。
判断增益结果是否可信
实际仿真得到的净编码增益还受测点密度、统计误差和曲线形状影响。交付一份可复现的编码方案比较报告时,至少检查以下条件:
- 目标一致:例如两组都在译码后的信息比特 BER= 处读数,不能把一组的 与另一组的 比较。
- 能量口径一致:记录横轴采用每信息比特还是每发送码比特能量,标明码率。若曲线已按信息比特归一化,不得重复扣除码率开销。
- 测点覆盖目标:参与插值的两个 BER 应位于目标两侧。如果测点只到 ,不应将外推到 的结果当作可靠实测门限。
- 统计样本足够:在 BER= 附近,仿真 个信息比特平均约出现 100 个错误,统计相对标准差约为 10%。要求更高精度时需要增加样本,不能只凭少量错误计数判断方案优劣。
- 曲线没有异常误码平台:如果编码曲线在高信噪比下出现错误平台,应检查译码迭代次数、最大帧长、终止条件和错误计数方式,不能简单沿用低信噪比区域的斜率外推。
最终报告可以写为:在 BPSK、AWGN、目标信息比特 BER=、编码码率 的示意条件下,未编码门限为 9.57 dB,编码门限按每信息比特归一化后为 6.51 dB,净编码增益为 3.05 dB。实际选择编码方案时,还需单独核对带宽、有效吞吐率、译码延迟和实现复杂度;净编码增益不能替代这些指标。