
通信工程 / 系统课时
判断 CRC 可检出的错误模式
判断 CRC 可检出的错误模式
CRC 能否发现传输错误,取决于错误比特的位置以及生成多项式,而不只是翻转了多少位。通过错误多项式的整除关系,可以准确区分必然检出和可能漏检的错误模式,并用 Python 仿真验证判断结果。
学习目标
- 使用错误多项式表示单比特、双比特和突发错误。
- 根据错误多项式与 CRC 生成多项式的整除关系判断检出能力。
- 通过可运行程序验证 CRC 的检测保证与漏检反例。
用错误多项式建立判定条件
CRC 把二进制序列看作 GF(2) 上的多项式,所有系数只能取 0 或 1,加法和减法均为异或运算。例如,二进制序列 1011 对应 。
设发送码字为 ,接收码字为 ,错误多项式为 ,则有:
错误多项式中,系数为 1 的位置表示对应比特发生翻转。假设发送码字已正确附加 CRC,能够被生成多项式 整除,那么接收端计算的余数满足:
因此,CRC 是否检出错误完全取决于 能否被 整除:
- 余数非零:确定接收码字不满足 CRC 校验,检测到错误。
- 余数为零:接收码字通过校验,但无法区分无错误和错误恰好漏检两种情况。
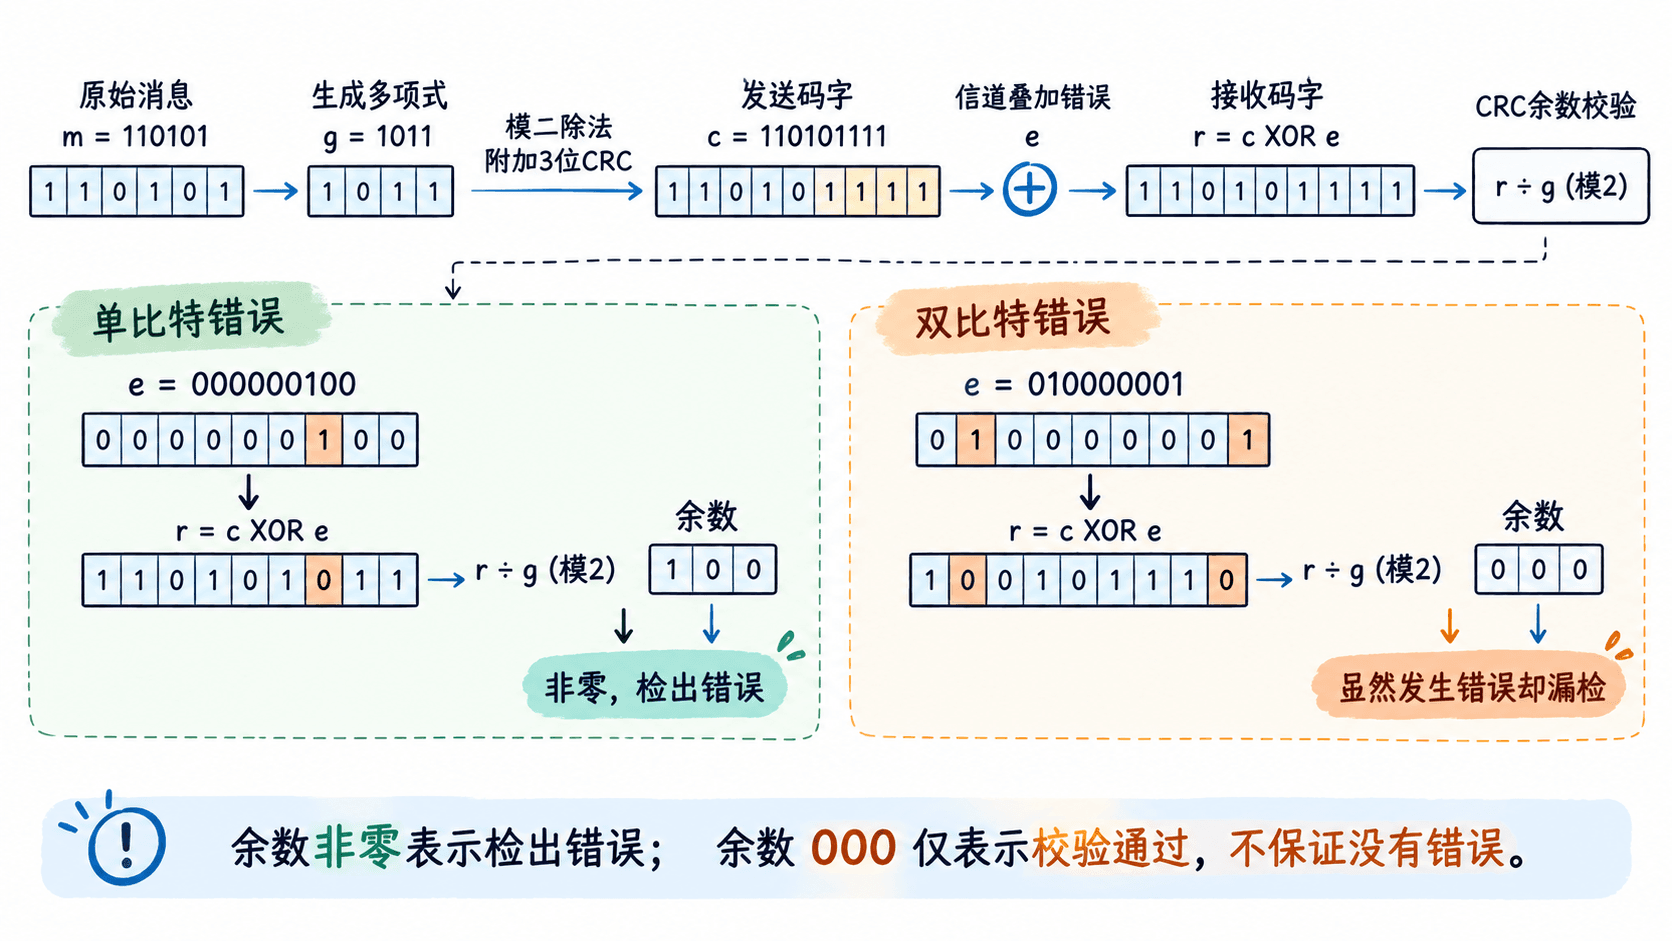
这里采用教学型 CRC:生成多项式为 ,二进制表示 1011,校验位宽度为 3,初始余数为零,不进行最终异或。以下所有算例都使用这组参数。
判断典型错误模式
单比特错误可表示为 。由于本例生成多项式的常数项为 1,且次数大于零, 不可能整除单项式 ,所以任意位置的单比特错误都能被检测出来。
双比特错误可以写成:
由于 ,它与 互素。因此,能否检出双比特错误取决于 是否整除 ,也就是两个错误位置之间的距离。
对本例的 1011,存在以下整除关系:
所以,当两个翻转位置相距 7 位时,例如 ,其错误多项式能被生成多项式整除,CRC 将漏检。更一般地,本例中距离为 7 的正整数倍时也会漏检;距离不是 7 的倍数时能够检出。
| 错误模式 | 本例检测能力 | 判断依据 |
|---|---|---|
| 单比特错误 | 全部检出 | 不被 整除 |
| 双比特错误 | 部分漏检 | 两个位置间距为 7 的倍数时漏检 |
| 奇数个比特错误 | 不保证全部检出 | 1011 本身包含 3 个非零位且可被自身整除 |
| 长度不超过 3 的突发错误 | 全部检出 | 非零错误多项式去除前导位置因子后次数小于 3 |
| 长度为 4 的突发错误 | 可能漏检 | 错误模式 1011 恰好等于生成多项式 |
这里的突发长度是从第一个翻转比特到最后一个翻转比特的跨度,包括中间没有翻转的位置。例如 1011 有 3 个错误比特,但突发长度为 4。
对于次数为 且常数项为 1 的 CRC 生成多项式,所有长度不超过 的非零突发错误都能检出。因为这样的错误可写成 ,其中 且 的次数小于 ,不可能包含完整的生成多项式因子。
用 Python 验证检出与漏检
使用 Python 3.8 或更新版本即可运行以下示例,无需安装第三方库。程序先生成一个 9 位 CRC 码字,再通过异或错误掩码模拟不同位置的比特翻转,最后计算接收码字除以生成多项式的余数。
def gf2_remainder(value: int, generator: int) -> int:
    # GF(2) 多项式长除法,使用异或消去最高次项
    while value.bit_length() >= generator.bit_length():
        shift = value.bit_length() - generator.bit_length()
        value ^= generator << shift
    return value


g = 0b1011
message = 0b110101
degree = g.bit_length() - 1

# 将消息左移3位,附加除法余数形成系统码字
shifted = message << degree
codeword = shifted | gf2_remainder(shifted, g)

errors = {
    "无错误": 0,
    "单比特 x^2": 1 << 2,
    "双比特 x^7+1": (1 << 7) | 1,
    "三比特 1011": 0b1011,
    "突发 3 位 111": 0b111,
}

print(f"发送码字: {codeword:09b}")
for name, error in errors.items():
    # 错误掩码为1的位置发生翻转,0的位置保持不变
    received = codeword ^ error
    remainder = gf2_remainder(received, g)
    status = "漏检" if error and remainder == 0 else (
        "检出" if remainder else "通过"
    )
    print(f"{name}: 余数={remainder:03b}, {status}")
预期输出:
发送码字: 110101111
无错误: 余数=000, 通过
单比特 x^2: 余数=100, 检出
双比特 x^7+1: 余数=000, 漏检
三比特 1011: 余数=000, 漏检
突发 3 位 111: 余数=111, 检出
这里有三个值得检查的现象。首先,单比特翻转得到非零余数,符合理论保证。其次,双比特错误虽然改变了接收数据,但因为错误多项式恰好是生成多项式的倍数,余数仍为零。最后,错误模式 1011 具有三个翻转位,也会漏检,而长度为 3 的突发模式 111 能被检出。
可以把双比特错误中的 (1 << 7) | 1 改为 (1 << 6) | 1 后重新运行。此时两个错误位置相距 6 位,接收余数将变为非零,结果由漏检变为检出。这说明相同的错误比特数量不意味着相同的检测结果。
根据错误模式评估 CRC 方案
在实际通信链路中,不能只比较 CRC 的位数,还要结合帧长度、生成多项式和需要覆盖的错误类型进行判断。
- 确认生成多项式:将二进制生成多项式写成 GF(2) 多项式,明确其次数、常数项以及是否包含 因子。
- 检查单比特和双比特错误:对单比特使用 ,对双比特检查 的整除关系。若要保证指定帧长度内全部双比特错误可检出,需要确认所有可能的正整数间距 都不会产生零余数。
- 核对突发长度:次数为 3 的本例只能保证检出长度不超过 3 的所有非零突发错误。更长的突发错误需要结合具体多项式分析。
- 用帧内错误掩码验证:构造指定长度的码字,逐项异或错误掩码并计算余数;对较短帧还可以穷举所有非零错误掩码,统计检出与漏检情况。
判断 CRC 检测能力时,应从具体错误多项式出发计算整除关系。对于已经确定的生成多项式和帧长度,这种方法能够给出严格的检出保证,也能构造可复现的漏检反例。