
多人游戏与网络同步 / 系统课时
高延迟丢包回归测试怎么设计
高延迟丢包回归测试怎么设计
网络优化上线前,不能只在理想网络里看平均延迟。更可靠的做法是固定负载与操作脚本,重复注入高延迟、抖动和丢包,并同时检查同步正确性、输入响应和最终收敛,确保优化没有在弱网条件下暴露新的状态问题。
学习目标
- 设计可重复的高延迟、丢包与组合弱网测试矩阵
- 为同步正确性、输入响应和状态收敛设置可判定门禁
- 用脚本把多组测试结果统一判定为通过或失败
先固定测试矩阵
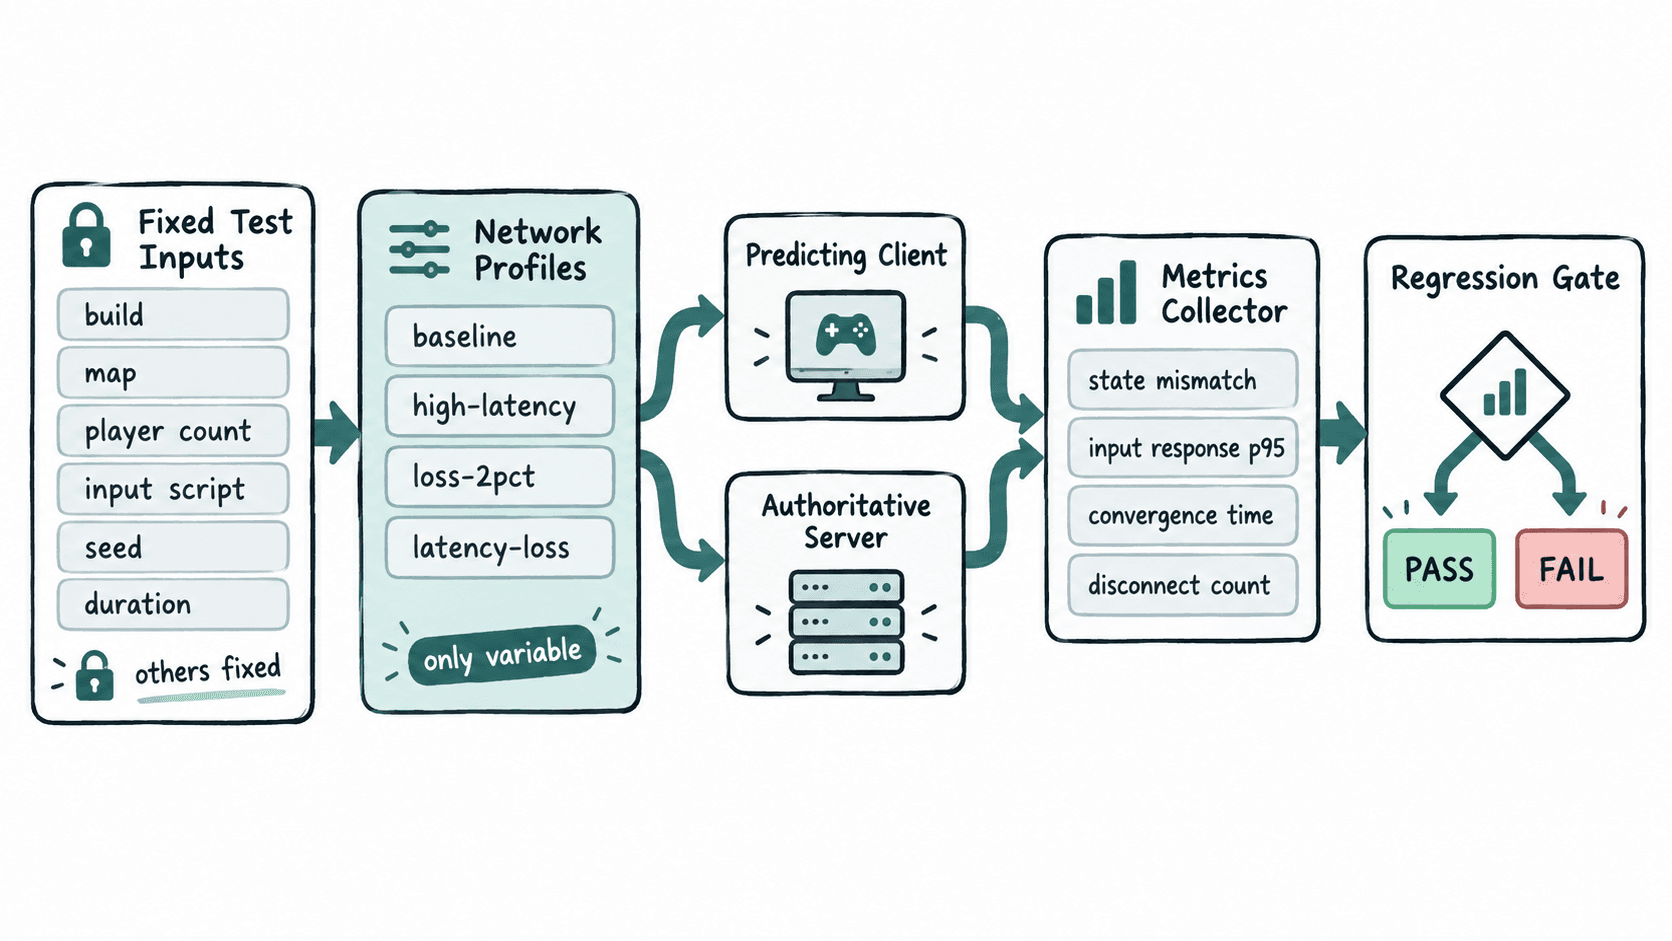
弱网回归最容易失真的是“每次条件都不一样”。测试时应固定构建版本、地图或场景、玩家数量、输入脚本、随机种子、持续时间和网络注入位置,只改变本轮指定的网络条件。
下面是一组可作为起点的示例。这里的延迟指测试设备在一个方向上额外注入的延迟,并不是天然等同于完整 RTT;如果只整形客户端出口,反向链路仍未被模拟。
| Profile | 额外延迟 | 抖动 | 丢包 | 主要验证目标 |
|---|---|---|---|---|
| baseline | 0 ms | 0 ms | 0% | 建立同构建基准 |
| high-latency | 75 ms | 10 ms | 0% | 输入响应与预测校正 |
| loss-2pct | 25 ms | 5 ms | 2% | 丢包后的重传或状态补偿 |
| latency-loss | 75 ms | 20 ms | 2% | 延迟与丢包叠加时的最终收敛 |
把通过条件写成可判定门禁
每个 Profile 都要同时看三类结果。第一类是正确性,例如安静窗口结束后客户端与权威状态不再分叉、关键事件没有重复应用。第二类是响应性,例如输入到本地可见反馈或权威确认的 p95 没有越过预算。第三类是收敛性,即发生丢包或校正后,客户端能在规定时间内回到权威状态。
门限必须由项目基线和体验预算决定,不应把下面的数字当成通用标准。更重要的是提前写死判定规则,避免测试结束后再挑对自己有利的指标。
| 检查项 | 示例门禁 |
|---|---|
| 稳定窗口后的状态差异 | state_mismatch_count == 0 |
| 会话稳定性 | disconnects == 0 |
| 输入响应 | 各 Profile 使用各自 p95 上限 |
| 最终收敛 | 各 Profile 使用各自最大收敛时间 |
用脚本一次判完多组结果
下面的 Python 示例把四组测试结果和门限放在同一个脚本中。真实项目里应把 results 替换为测试客户端或指标系统导出的结果,但判定逻辑可以直接复用。
results = [
    {"profile": "baseline", "input_p95_ms": 82, "converge_ms": 120,
     "state_mismatch_count": 0, "disconnects": 0},
    {"profile": "high-latency", "input_p95_ms": 238, "converge_ms": 420,
     "state_mismatch_count": 0, "disconnects": 0},
    {"profile": "loss-2pct", "input_p95_ms": 154, "converge_ms": 610,
     "state_mismatch_count": 1, "disconnects": 0},
    {"profile": "latency-loss", "input_p95_ms": 276, "converge_ms": 920,
     "state_mismatch_count": 0, "disconnects": 0},
]

limits = {
    "baseline": {"input_p95_ms": 120, "converge_ms": 300},
    "high-latency": {"input_p95_ms": 260, "converge_ms": 500},
    "loss-2pct": {"input_p95_ms": 180, "converge_ms": 700},
    "latency-loss": {"input_p95_ms": 300, "converge_ms": 800},
}

failed = False

for row in results:
    limit = limits[row["profile"]]
    reasons = []

    if row["state_mismatch_count"] != 0:
        reasons.append(
            f"state_mismatch_count={row['state_mismatch_count']}"
        )
    if row["disconnects"] != 0:
        reasons.append(f"disconnects={row['disconnects']}")
    if row["input_p95_ms"] > limit["input_p95_ms"]:
        reasons.append(
            f"input_p95_ms={row['input_p95_ms']} > {limit['input_p95_ms']}"
        )
    if row["converge_ms"] > limit["converge_ms"]:
        reasons.append(
            f"converge_ms={row['converge_ms']} > {limit['converge_ms']}"
        )

    status = "FAIL" if reasons else "PASS"
    print(f"{row['profile']}: {status}" + (
        f" - {', '.join(reasons)}" if reasons else ""
    ))
    failed = failed or bool(reasons)

raise SystemExit(1 if failed else 0)
预期输出
baseline: PASS
high-latency: PASS
loss-2pct: FAIL - state_mismatch_count=1
latency-loss: FAIL - converge_ms=920 > 800
脚本以非零退出码表示整轮回归失败,因此可以接入 CI。示例中特意保留两个失败:一个暴露同步正确性问题,另一个说明组合弱网下虽然最终状态方向正确,但收敛时间已经超出门限。
失败时按正确性到体验顺序定位
弱网失败不应先看“平均带宽是否下降”。先确认状态是否正确,再确认是否能收敛,最后看输入响应是否满足体验预算。状态已经分叉时,继续优化平均延迟没有意义。
排查时保留每轮的构建标识、Profile、玩家数量、随机种子、原始事件日志和指标文件。只要某个失败能用同一组输入重放出来,就可以判断修复是否真正消除了问题,而不是被下一轮网络随机性掩盖。
一轮有效的高延迟丢包回归,最终交付的不是“感觉还能玩”,而是一张固定测试矩阵、一组明确门禁和可复现的失败记录。这样同步正确性、响应速度和最终收敛才能在每次网络优化后被同样的方法重新验证。