
多人游戏与网络同步 / 系统课时
丢包环境下怎样验证协议行为
丢包环境下怎样验证协议行为
验证丢包不能只看“还能不能连上”。真正要确认的是:可靠消息是否按约定重传并保持交付语义,不可靠状态是否正确丢弃过期数据,以及网络恢复后客户端能否重新收敛到服务器权威状态。
学习目标
- 把重传、顺序、过期丢弃和最终收敛转换成可检查的不变量
- 用可重复的丢包与乱序脚本验证可靠通道和最新状态通道
- 根据日志与终态区分正常重试、错误回滚和隐藏状态分叉
先把“正确”写成协议不变量
丢包测试最容易犯的错误,是只统计“掉了多少包”。协议真正需要验证的是应用层可见行为。可靠通道在连接仍有效、重试预算未耗尽时,不应静默缺失消息;如果定义为可靠有序,接收端还必须按序交付。底层发生重传并不等于业务事件可以执行多次,因此接收端通常还要用序列号或消息 ID 去重。
对于位置、朝向这类 latest-wins 状态,不可靠传输允许丢包,也允许后发包先到。接收端需要记住最后接受的序列号,只应用更新的状态,迟到的旧状态应被丢弃,不能让角色“回滚”到更早位置。
| 要验证的行为 | 建议观测量 | 失败信号 |
|---|---|---|
| 可靠消息补发 | 发送序号、尝试次数、ACK | 丢包后没有重传或永久缺号 |
| 有序交付 | 应用层交付序号 | 先执行高序号再执行低序号 |
| 过期状态丢弃 | latestSeq、staleDrop | 旧快照覆盖新快照 |
| 最终收敛 | 权威版本、状态摘要 | 网络恢复后版本或关键状态仍不同 |
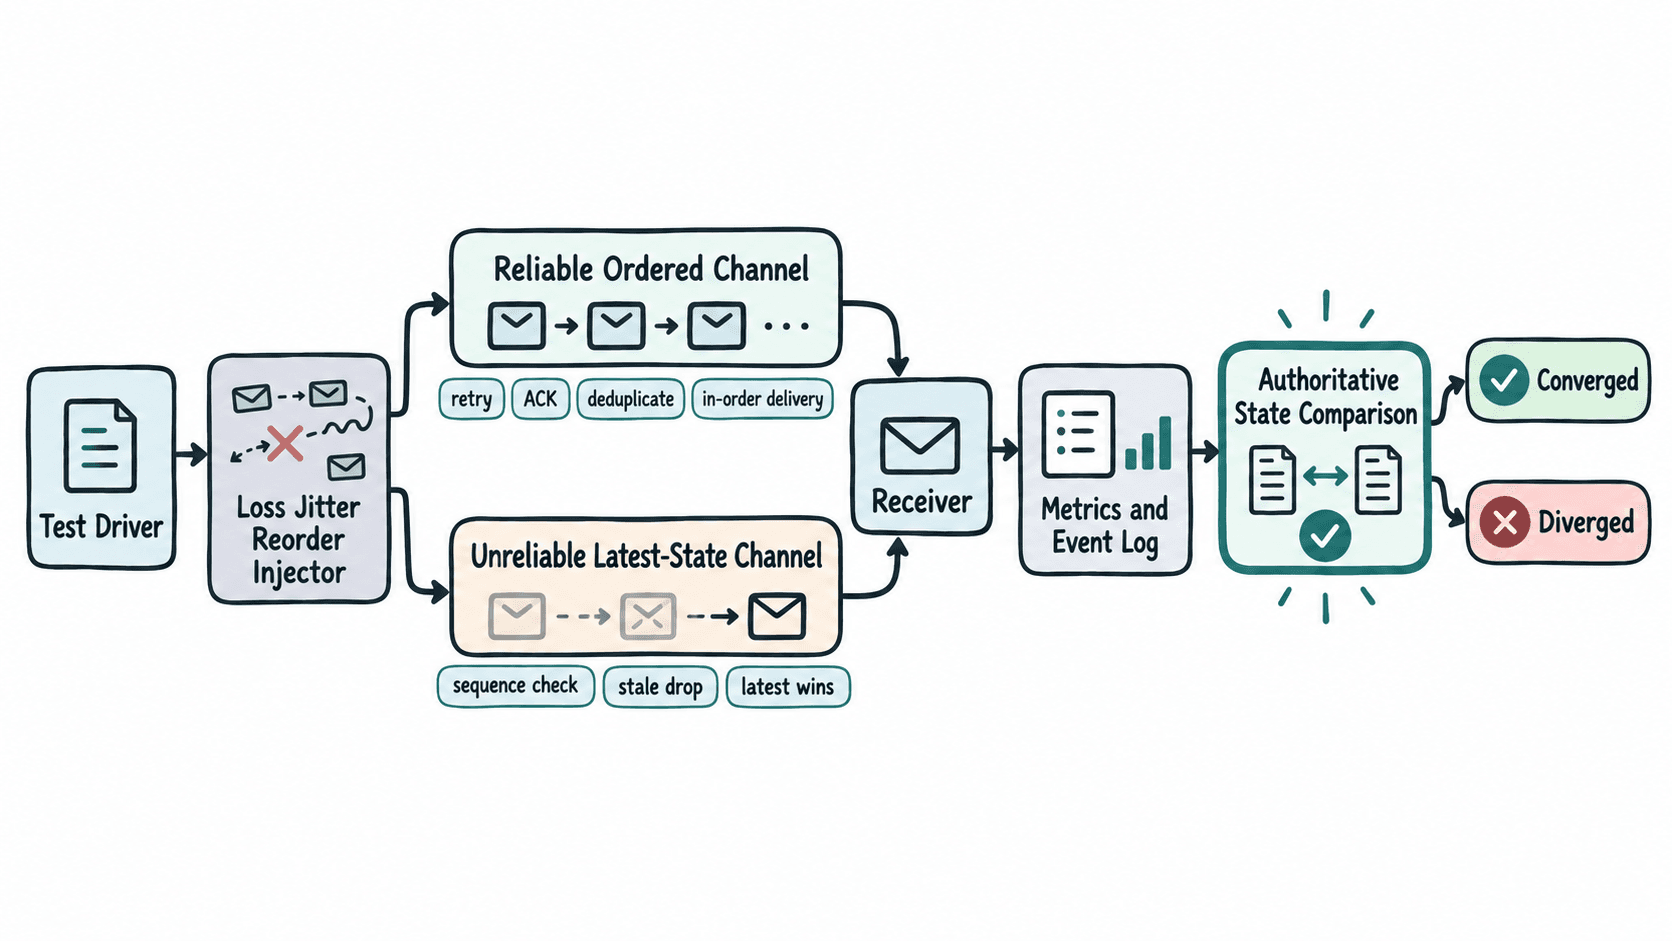
用确定性脚本先验证核心行为
下面的脚本在同一进程里模拟 0%、10%、30% 丢包。可靠消息会持续重试直到送达,并在接收端按序应用;状态快照只发送一次,同时加入随机到达延迟,让接收端主动丢弃迟到快照。固定随机种子可以让每次运行得到相同结果,适合作为协议单元测试的第一层。
import random

def simulate(loss_rate: float, seed: int = 20261006):
    reliable_rng = random.Random(seed + int(loss_rate * 1000))
    pending = list(range(1, 21))
    attempts = {seq: 0 for seq in pending}
    buffer = set()
    expected = 1
    applied = []
    retries = 0

    # 可靠通道:失败的序号进入下一轮重传,接收端只按连续序号交付。
    while pending:
        next_pending = []
        for seq in pending:
            attempts[seq] += 1
            if attempts[seq] > 1:
                retries += 1
            if reliable_rng.random() < loss_rate:
                next_pending.append(seq)
                continue

            buffer.add(seq)
            while expected in buffer:
                buffer.remove(expected)
                applied.append(expected)
                expected += 1
        pending = next_pending

    # latest-wins 快照:单次发送,额外抖动会制造乱序到达。
    snap_rng = random.Random(seed + 10000 + int(loss_rate * 1000))
    arrivals = []
    drops = 0
    for seq in range(1, 21):
        if snap_rng.random() < loss_rate:
            drops += 1
            continue
        arrivals.append((seq + snap_rng.uniform(0, 4), seq))

    latest_seq = 0
    stale_drops = 0
    for _, seq in sorted(arrivals):
        if seq <= latest_seq:
            stale_drops += 1
        else:
            latest_seq = seq

    final_state = applied[-1]
    return (
        retries,
        applied == list(range(1, 21)),
        drops,
        stale_drops,
        final_state,
        final_state == 20,
    )

for rate in (0.0, 0.1, 0.3):
    retries, ordered, drops, stale, final_state, converged = simulate(rate)
    print(
        f"loss={int(rate * 100)}% "
        f"reliable_retries={retries} "
        f"ordered={ordered} "
        f"unreliable_drops={drops} "
        f"stale_drops={stale} "
        f"final_state={final_state} "
        f"converged={converged}"
    )
预期输出
loss=0% reliable_retries=0 ordered=True unreliable_drops=0 stale_drops=8 final_state=20 converged=True
loss=10% reliable_retries=5 ordered=True unreliable_drops=4 stale_drops=5 final_state=20 converged=True
loss=30% reliable_retries=9 ordered=True unreliable_drops=7 stale_drops=3 final_state=20 converged=True
即使 0% 丢包仍出现 stale_drops,也是预期行为:脚本把“丢包”和“到达顺序变化”拆成了两个独立故障维度。随着丢包率升高,reliable_retries 增加,但 ordered=True 与 converged=True 仍必须保持;如果它们变为 False,才说明协议语义被破坏。
放到真实网络路径时观察同一组证据
进入集成测试后,可以用网络模拟器或受控代理分别对客户端上行、服务器下行注入 1%、5%、10%、20% 等丢包率,并保持玩家数、发送频率、场景和构建版本不变。单向注入尤其重要,因为“客户端输入丢失”和“服务器状态下行丢失”会触发不同代码路径。
日志至少应能关联 connectionId、消息序号、发送次数、ACK 或确认版本、重复包数、乱序数、过期丢弃数与当前权威版本。只看总带宽或平均 Ping 无法证明重传是否正确,也无法发现旧快照覆盖新状态这类逻辑错误。
用终态收敛做最终验收
故障注入结束后,恢复正常网络并等待一个明确的恢复窗口,再比较客户端与服务器的关键权威状态。可以使用状态版本、实体数量、关键字段或稳定的状态摘要;对于可预测移动,还应等待未确认输入完成确认或回放后再比较。
一次合格的测试应同时满足:可靠有序消息没有应用层缺号或乱序执行,重复传输没有导致业务动作重复,不可靠旧状态被拒绝,丢包升高时重试指标按预期增加,并且恢复后双方最终状态一致。这样才能证明协议是在丢包下保持语义,而不只是“连接没有断”。