
多人游戏与网络同步 / 系统课时
服务器负载高但流量不高怎么查
服务器负载高但流量不高怎么查
当服务器 CPU、Tick 耗时或负载明显升高,但出口带宽和包量没有同步增长时,问题通常不在“发得太多”,而在“算得太贵”。排查应先证明网络不是主瓶颈,再沿 Tick、复制计算、脚本热点和对象规模逐层缩小范围。
学习目标
- 区分带宽瓶颈与服务器计算瓶颈,避免只盯流量曲线
- 用 Tick 分解指标定位复制、脚本或对象数量造成的高负载
- 建立从现象、根因到修复验证的最短排查顺序
先确认不是单纯带宽瓶颈
“CPU 高、流量低”并不等于网络模块无关。复制系统可能花大量 CPU 做相关性判断、脏状态扫描、序列化和压缩,最后因为对象没有变化或被预算器丢弃,真正发送的数据仍然很少。因此第一步应同时看计算与发送,而不是只看网卡。
至少把同一时间窗口中的这些指标放在一起:
- CPU 使用率与单 Tick 耗时,重点看 p95、p99,而不是只看平均值。
- 每 Tick 扫描的网络对象数、进入相关集合的对象数、实际序列化对象数。
- 复制或序列化耗时、脚本耗时、物理耗时和垃圾回收耗时。
- 出口字节数、包数以及每客户端发送量。
如果 CPU 和 Tick 耗时上升,而出口字节数基本稳定,就应把调查方向转向“每发送一个字节之前做了多少无效工作”。
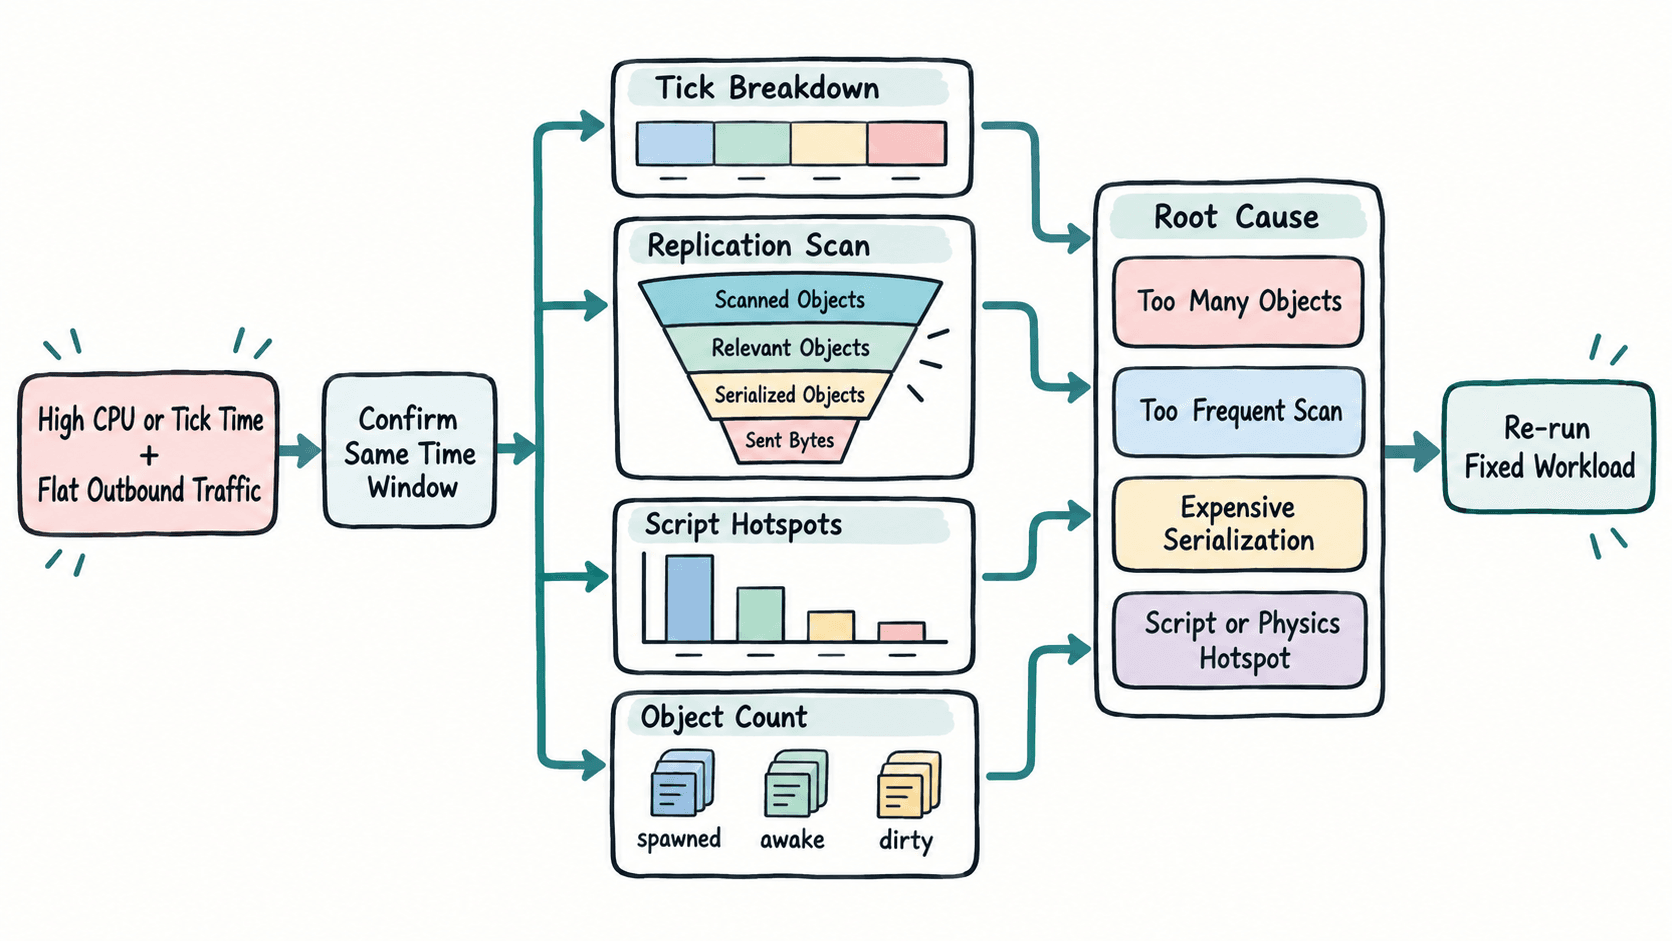
按 Tick 成本拆开,而不是按模块名称猜
最有效的做法是给一次固定负载回放建立 Tick 成本分解。假设总 Tick 时间由脚本、物理、复制和其他工作组成,可以先看哪一项随负载增长最快,再继续向下钻。
例如某次采样导出了 5 个连续窗口的数据,可以用下面的最小脚本计算均值并判断“复制计算是否重、实际网络发送是否低”。实际项目中只需把示例列表替换成监控系统或 profiler 导出的数据。
from statistics import mean

samples = [
    {"tick_ms": 28.4, "replication_ms": 10.8, "script_ms": 9.2, "objects": 18400, "sent_kbps": 620},
    {"tick_ms": 31.1, "replication_ms": 12.6, "script_ms": 9.8, "objects": 19350, "sent_kbps": 640},
    {"tick_ms": 30.7, "replication_ms": 12.2, "script_ms": 10.1, "objects": 19120, "sent_kbps": 635},
    {"tick_ms": 32.0, "replication_ms": 13.1, "script_ms": 10.0, "objects": 19880, "sent_kbps": 645},
    {"tick_ms": 31.6, "replication_ms": 12.9, "script_ms": 9.9, "objects": 19740, "sent_kbps": 638},
]

avg_tick = mean(s["tick_ms"] for s in samples)
avg_rep = mean(s["replication_ms"] for s in samples)
avg_script = mean(s["script_ms"] for s in samples)
avg_objects = mean(s["objects"] for s in samples)
avg_kbps = mean(s["sent_kbps"] for s in samples)

print(f"avg tick: {avg_tick:.1f} ms")
print(f"avg replication: {avg_rep:.1f} ms")
print(f"avg script: {avg_script:.1f} ms")
print(f"avg objects: {avg_objects:.0f}")
print(f"avg outbound: {avg_kbps:.0f} kbps")

if avg_rep / avg_tick >= 0.35 and avg_kbps < 1000:
    print("candidate: replication computation is expensive while outbound traffic stays low")
预期输出:
avg tick: 30.8 ms
avg replication: 12.3 ms
avg script: 9.8 ms
avg objects: 19300
avg outbound: 636 kbps
candidate: replication computation is expensive while outbound traffic stays low
这个结果不能单独证明根因,但它把问题从“网络是不是堵了”缩小到“复制阶段为什么占了约四成 Tick”。下一步应继续看扫描对象数、相关集合大小、序列化次数和单次序列化成本。
四类高概率根因怎么区分
对象数量异常时,通常能看到总对象数或 awake/dirty 对象数同步上涨。常见原因包括生成泄漏、销毁延迟、休眠条件失效,或者把本来应在客户端表现的环境对象放进服务器权威同步集合。
扫描频率过高时,总对象数未必异常,但每 Tick 被检查的对象很多。此时应确认相关性计算是否每帧全量执行、空间分区是否退化,以及远距离对象是否仍参与高频判断。带宽低只是说明它们最后没被发送,不代表前面的筛选免费。
单对象序列化昂贵时,对象数量也可能正常。应按对象类型聚合 serialize time / update count,找出每次更新最贵的类型,再检查大数组、复杂状态拼装、重复压缩或频繁分配。
脚本或物理热点则会表现为复制耗时正常,但 Tick 总时长仍高。此时网络数据只是伴随指标,应该转向 CPU profiler、任务队列长度、碰撞对数量、AI 更新频率或 GC 暂停。
修复后要用同一负载验证
修复时只改一个主要变量,并使用与故障复现相同的玩家数、地图、行为脚本和持续时间。验收至少比较 Tick p95/p99、CPU、复制耗时、对象数量和出口流量;如果 CPU 降了但 Tick 长尾没降,说明仍有其他热点。
一个可靠的结论应能写成:固定 100 玩家回放下,删除无效 awake 对象后,相关性扫描对象数下降,复制耗时与 Tick p95 同时下降,而出口带宽基本不变。这样的证据才说明真正减少的是服务器无效计算,而不是刚好换了一个更轻的测试场景。