
多人游戏与网络同步 / 系统课时
从一次带宽异常完成优化闭环
从一次带宽异常完成优化闭环
一次带宽告警并不等于“压缩数据就行”。本课从固定场景中的出口异常出发,先找出真正贡献流量的对象,再实施最小修改,并用完全相同的负载复测带宽、时延和服务器指标,完成可回滚的优化闭环。
学习目标
- 从总带宽异常下钻到对象类型、更新频率和单次负载大小
- 区分“对象太多、发得太频繁、每次太大”三类常见根因
- 在相同压测条件下比较基线与候选版本,并用回归指标决定接受或回滚
先固定异常,再开始定位
假设 50 人固定场景的总下行预算是 4.0 Mbit/s,而稳定复现出的 p95 为 8.4 Mbit/s。此时先冻结玩家数量、地图、动作脚本、网络模拟和测试时长;如果一边改场景一边改代码,后面的差异就无法归因。
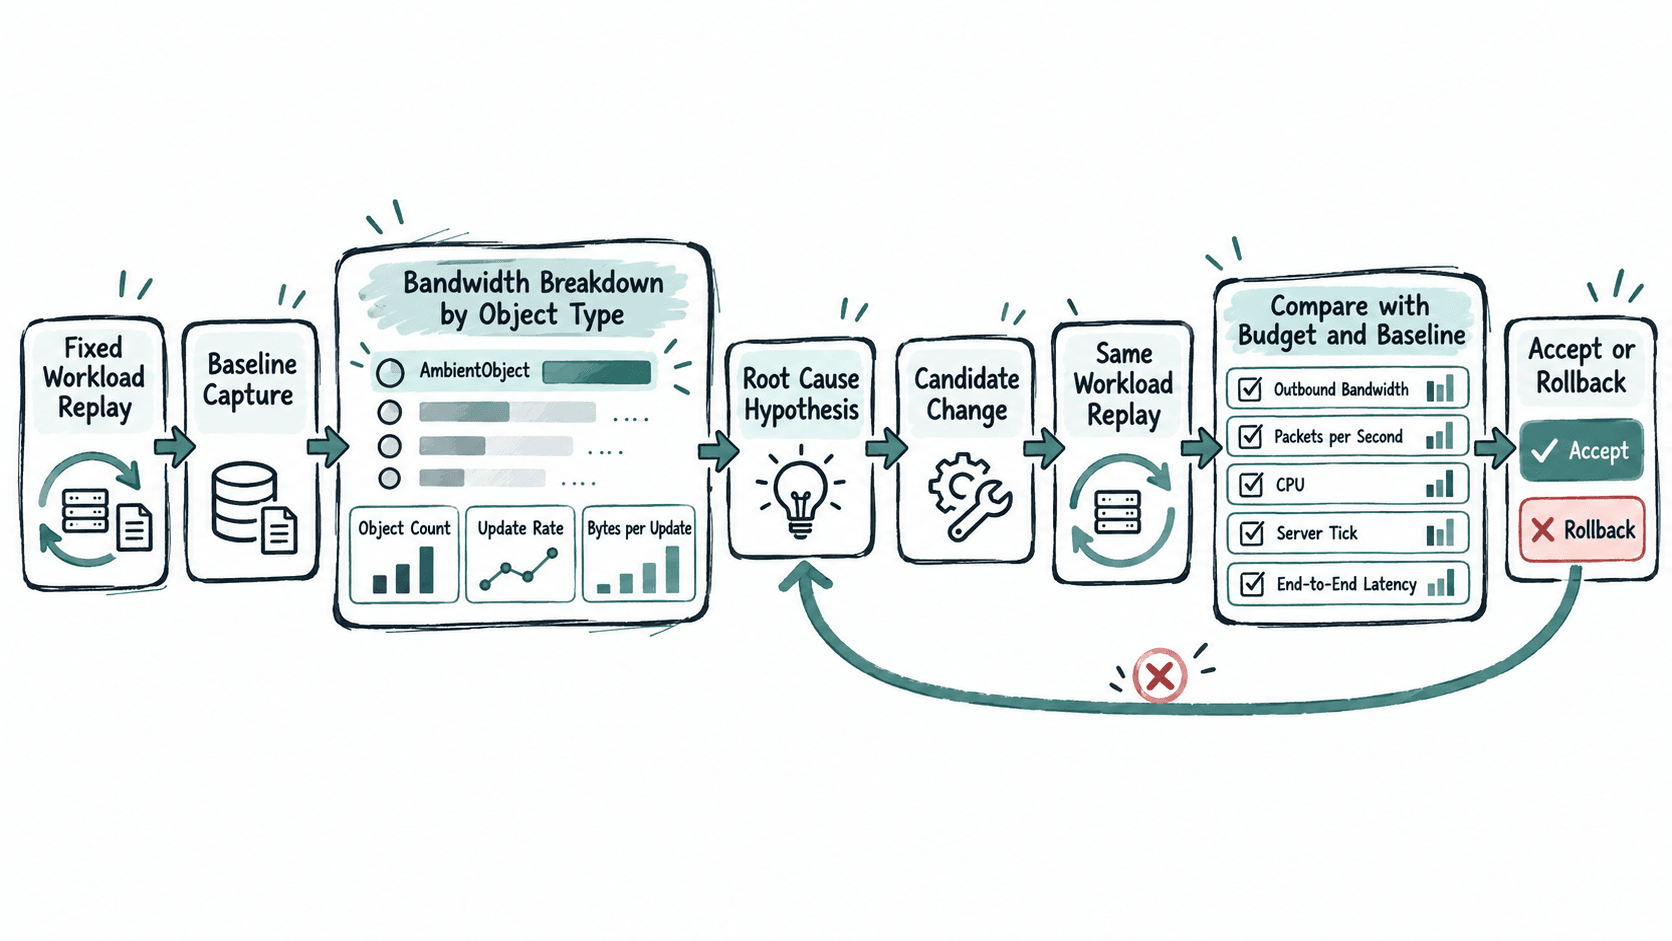
定位时不要先猜“序列化太大”,而要把总量拆成三个因子:对象数量、每秒更新次数、每次有效负载字节数。三者中任何一个异常,都可能把总出口推高。
用对象级统计找出最大贡献者
下面用一个可运行的 Python 脚本模拟对象级流量统计。它按“对象数 × 更新频率 × 单次 payload”估算业务负载,用于判断先优化哪一类对象;它不包含 UDP/IP 头、加密、聚合、重传等开销,所以最终容量仍应以 transport 或网卡实测为准。
from dataclasses import dataclass

@dataclass(frozen=True)
class TrafficClass:
    name: str
    object_count: int
    updates_per_second: float
    bytes_per_update: int

def mbit_per_second(item: TrafficClass) -> float:
    return (
        item.object_count
        * item.updates_per_second
        * item.bytes_per_update
        * 8
        / 1_000_000
    )

def report(label: str, rows: list[TrafficClass]) -> float:
    print(f"[{label}]")
    ordered = sorted(rows, key=mbit_per_second, reverse=True)
    for row in ordered:
        print(f"{row.name}: {mbit_per_second(row):.2f} Mbit/s")
    total = sum(mbit_per_second(row) for row in rows)
    print(f"total: {total:.2f} Mbit/s")
    return total

baseline = [
    TrafficClass("PlayerState", 50, 20, 80),
    TrafficClass("ProjectileState", 400, 15, 40),
    TrafficClass("AmbientObject", 1200, 10, 60),
]

# 候选修改只针对主要贡献者:降低低价值环境对象频率并缩小 payload。
candidate = [
    TrafficClass("PlayerState", 50, 20, 80),
    TrafficClass("ProjectileState", 400, 15, 40),
    TrafficClass("AmbientObject", 1200, 2, 32),
]

baseline_total = report("baseline", baseline)
candidate_total = report("candidate", candidate)
reduction = (baseline_total - candidate_total) / baseline_total * 100

print(f"reduction: {reduction:.1f}%")
print("budget_gate: " + ("PASS" if candidate_total <= 4.0 else "FAIL"))
预期输出
[baseline]
AmbientObject: 5.76 Mbit/s
ProjectileState: 1.92 Mbit/s
PlayerState: 0.64 Mbit/s
total: 8.32 Mbit/s
[candidate]
ProjectileState: 1.92 Mbit/s
PlayerState: 0.64 Mbit/s
AmbientObject: 0.61 Mbit/s
total: 3.17 Mbit/s
reduction: 61.8%
budget_gate: PASS
这个结果说明异常主要不是 PlayerState,而是 AmbientObject 同时具备数量多、频率高、单次 payload 大三个因素。优先处理它,比对所有消息做无差别压缩更可控。
把修改限制在根因上
对环境对象的候选方案可以是:没有显著变化时不发送;距离较远时降低更新频率;对可容忍误差的字段降低量化精度。一次验证最好只引入一组逻辑相关的修改,否则即使结果变好,也很难知道真正有效的是哪一项。
修改后要保留原始对象级计数器。若 AmbientObject 流量下降但服务器 CPU 明显上升,可能是变化检测或相关性计算过重;若带宽下降但客户端校正次数暴增,则可能是更新频率降得过头。
用完全相同的条件复测
候选版本必须重放与基线相同的 50 人场景。下面是一组示例验收结果,重点不是具体数字,而是比较方法:主指标回到预算内,同时 CPU、Tick 和交互时延没有明显回归。
| 指标 | 预算 | 基线 | 候选 | 结果 |
|---|---|---|---|---|
| 总下行 p95 | ≤ 4.0 Mbit/s | 8.4 | 3.6 | 通过 |
| CPU p95 | ≤ 70% | 58% | 56% | 通过 |
| Server Tick p99 | ≤ 30 ms | 22 ms | 21 ms | 通过 |
| 输入到可见反馈 p95 | ≤ 120 ms | 94 ms | 96 ms | 通过 |
这里候选版本的实测总下行 3.6 Mbit/s 高于脚本估算的 3.17 Mbit/s,是合理现象,因为真实链路还包含协议头、控制流量以及可能的重传。验收应以实测值为准,估算只负责解释构成。
记录证据并保留回滚条件
一次优化真正闭环,需要保留基线构建、候选构建、固定负载描述、对象级流量分解和最终验收表。若候选带宽下降但任一关键回归指标越过预算,就回滚并重新提出假设,而不是继续叠加更多改动掩盖问题。
可验证的网络优化始终遵循同一条链路:先稳定复现异常,再用数据找到最大贡献者,只修改根因,最后在相同条件下证明收益且没有把成本转移到 CPU、Tick 或时延。