
多人游戏与网络同步 / 系统课时
玩家说卡时第一步查什么
玩家说卡时第一步查什么
玩家一句“很卡”无法直接说明是网络延迟、丢包、客户端掉帧还是服务器 Tick 超时。第一步不是立刻改网络参数,而是用同一时间窗口检查几类关键指标,把问题先归到客户端、网络、服务器或带宽压力中的一类。
学习目标
- 用延迟、丢包、帧率、Server Tick 和带宽建立第一轮排障入口
- 根据指标组合区分客户端卡顿、链路异常和服务器过载
- 用统一采样时间关联玩家反馈与服务端观测数据
先把“卡”拆成可测现象
玩家感知到的停顿可能来自完全不同的路径。高 RTT 会让操作确认变慢;丢包和抖动会让快照到达不均匀;客户端帧时间过高会造成画面停顿;Server Tick 超时会让所有客户端更晚收到权威状态;带宽打满则可能引起排队、丢包和重要消息延后。
因此第一轮至少检查以下信号:
| 指标 | 优先回答的问题 |
|---|---|
| RTT 与 jitter | 往返时间是否升高或波动扩大 |
| packet loss | 是否发生持续或突发丢包 |
| client frame time / FPS | 卡顿是否只发生在渲染端 |
| server tick p95/p99 | 服务器是否无法按目标节奏完成模拟 |
| outbound bandwidth / packet rate | 发送队列是否接近容量上限 |
这些指标必须尽量对齐同一个时间窗口。如果玩家报告 21:05 出现卡顿,却拿 21:20 的平均监控值判断,通常无法定位真正原因。
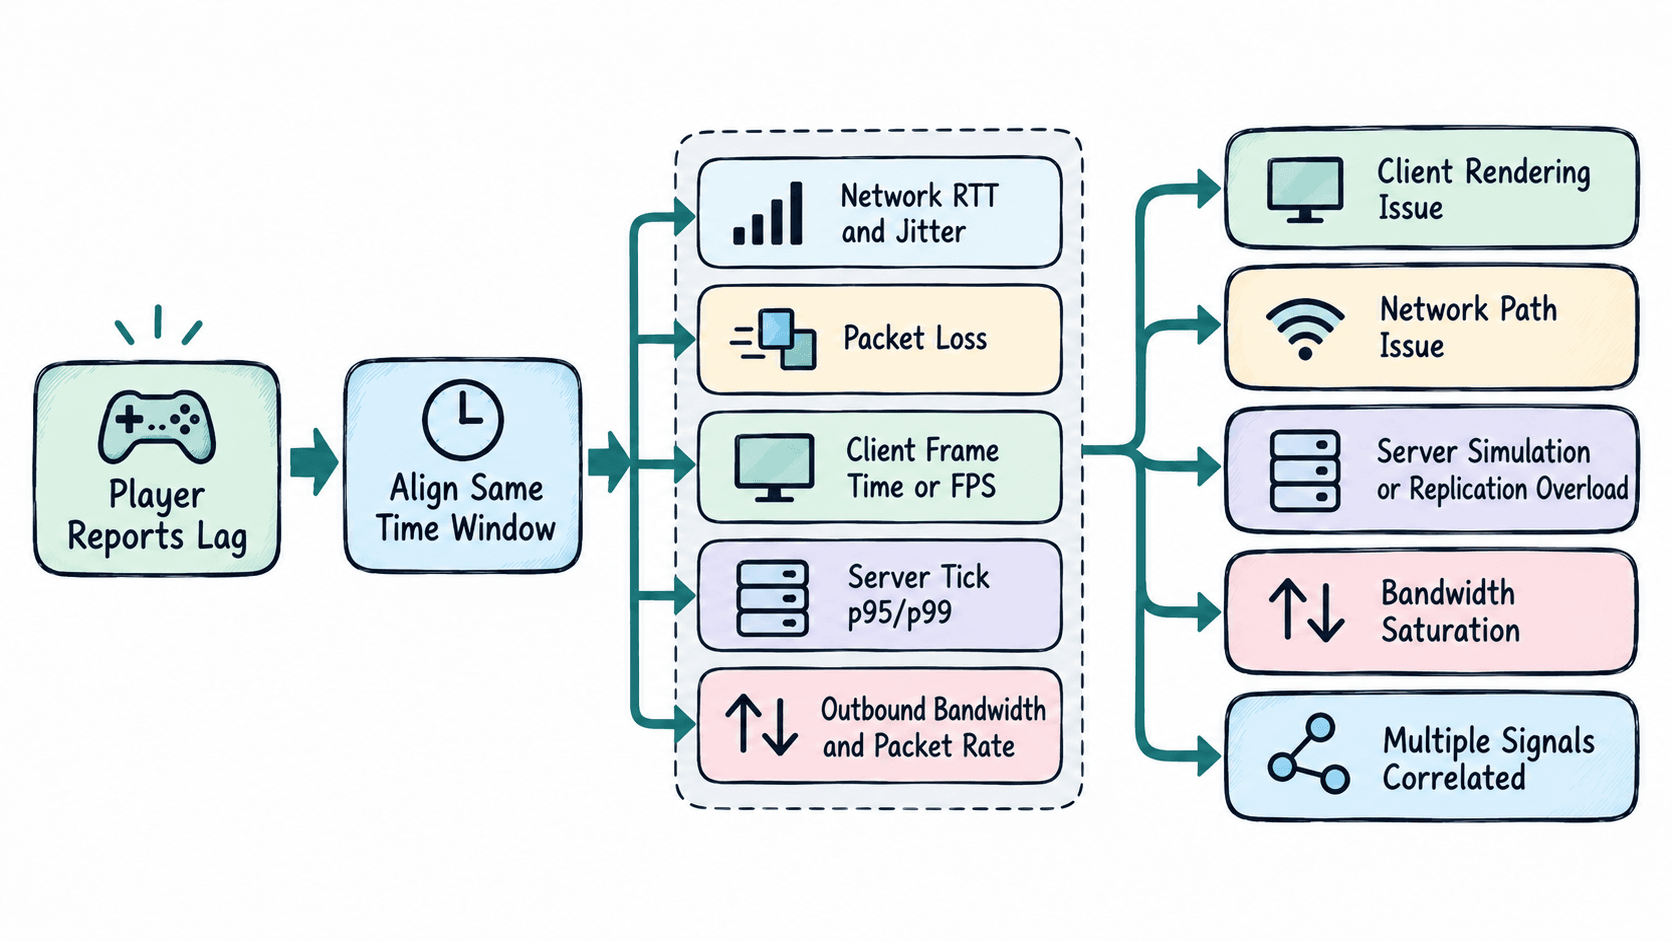
用组合信号判断问题落在哪一层
单个指标很少能独立定责。例如 RTT 高不一定是服务器慢,服务器 Tick 超时也不一定来自网络。第一轮排障更重要的是看指标组合。
如果客户端 FPS 明显下降,而 RTT、丢包和 Tick 都稳定,优先检查客户端渲染、脚本或资源加载。若 FPS 正常,但 RTT 和 jitter 同时恶化,并伴随丢包,则优先检查玩家到机房的网络路径。若多个玩家在同一时间出现卡顿,同时 Server Tick p99、CPU 或复制耗时上升,更像服务器侧负载问题。
带宽也要与其他指标一起看。出口带宽接近实例或网络预算上限,同时出现发送队列增长、packet rate 激增或丢包,说明需要继续分析复制数量、更新频率和消息优先级,而不是简单把问题归因于“Ping 高”。
建立一个最小分诊脚本
下面的可运行 Python 示例模拟一次统一时间窗口的采样,并按照简单规则给出首要调查方向。阈值仅用于演示工作流,项目中应使用自己的性能基线和告警标准。
sample = {
    "rtt_ms_p95": 42.0,
    "jitter_ms_p95": 6.0,
    "packet_loss_percent": 0.2,
    "client_fps_p05": 58.0,
    "server_tick_ms_p99": 51.0,
    "tick_budget_ms": 33.3,
    "outbound_utilization_percent": 64.0,
}

reasons = []

# 先区分客户端、网络和服务器,再决定下一轮采集什么细节。
if sample["client_fps_p05"] < 45:
    reasons.append("investigate client frame performance")
if sample["packet_loss_percent"] >= 1.0 or sample["jitter_ms_p95"] >= 20:
    reasons.append("investigate network path")
if sample["server_tick_ms_p99"] > sample["tick_budget_ms"]:
    reasons.append("investigate server tick overload")
if sample["outbound_utilization_percent"] >= 85:
    reasons.append("investigate outbound bandwidth pressure")

if not reasons:
    reasons.append("no obvious first-level bottleneck; inspect timeline and per-player traces")

for reason in reasons:
    print(reason)
预期输出:
investigate server tick overload这里的价值不在于几条固定阈值,而在于建立稳定的分诊顺序。脚本发现 Tick p99 超过预算后,下一步应进入服务器 CPU、模拟阶段耗时和复制耗时分析,而不是继续无目的地查看客户端 Ping。
第一轮排障最容易犯的错误
最常见的错误是只看一个平均 Ping。低平均 RTT 仍可能伴随 jitter、短时丢包、Server Tick 长尾或客户端帧时间尖峰,因此“Ping 30 ms”不能证明链路和游戏体验都正常。
另一个错误是把所有玩家混成一个平均值。若只有某个地区、某个 ISP 或单个玩家异常,应分玩家、地区或接入点比较;若大量玩家在同一秒出现问题,则服务器或共享网络路径的可能性更高。
第一轮结束时要得到什么
第一轮排障的目标不是立刻找到最终代码缺陷,而是把搜索空间缩小。结束时至少应能回答:问题主要发生在客户端、网络路径、服务器 Tick 还是发送容量;异常是否只影响单个玩家;异常是否与某个明确时间段的指标尖峰对应。
只有完成这一步,后续抓包、Profiler、复制统计或客户端性能分析才有明确方向。把“玩家说卡”转换成时间对齐的指标组合,是整个网络性能排障工作流最重要的入口。