
多人游戏与网络同步 / 系统课时
把网络优化和 CPU 优化一起验证
把网络优化和 CPU 优化一起验证
网络优化很容易出现“带宽下降了,但游戏反而更卡”的假胜利。压缩、合包、降 Tick 频率或更复杂的差量编码,都可能把成本从网络侧转移到 CPU、Tick 或延迟。本篇建立一套联合验证方法,让每次优化都在相同负载下同时检查 CPU、带宽、Tick 和端到端延迟。
学习目标
- 识别网络指标改善但 CPU、Tick 或延迟回归的典型情况
- 在固定负载下建立可比较的联合指标基线
- 用自动验收规则阻止单指标优化进入发布版本
单指标为什么会给出假胜利
降低 outbound Mbps 并不等于服务器更健康。例如更激进的压缩能减少字节数,却增加序列化和压缩 CPU;把多个小包攒成大包可以降低 packets/s,却可能延后发送时机;直接降低服务器 Tick Rate 则能同时降低 CPU 与带宽,但会扩大输入到权威状态更新之间的等待时间。
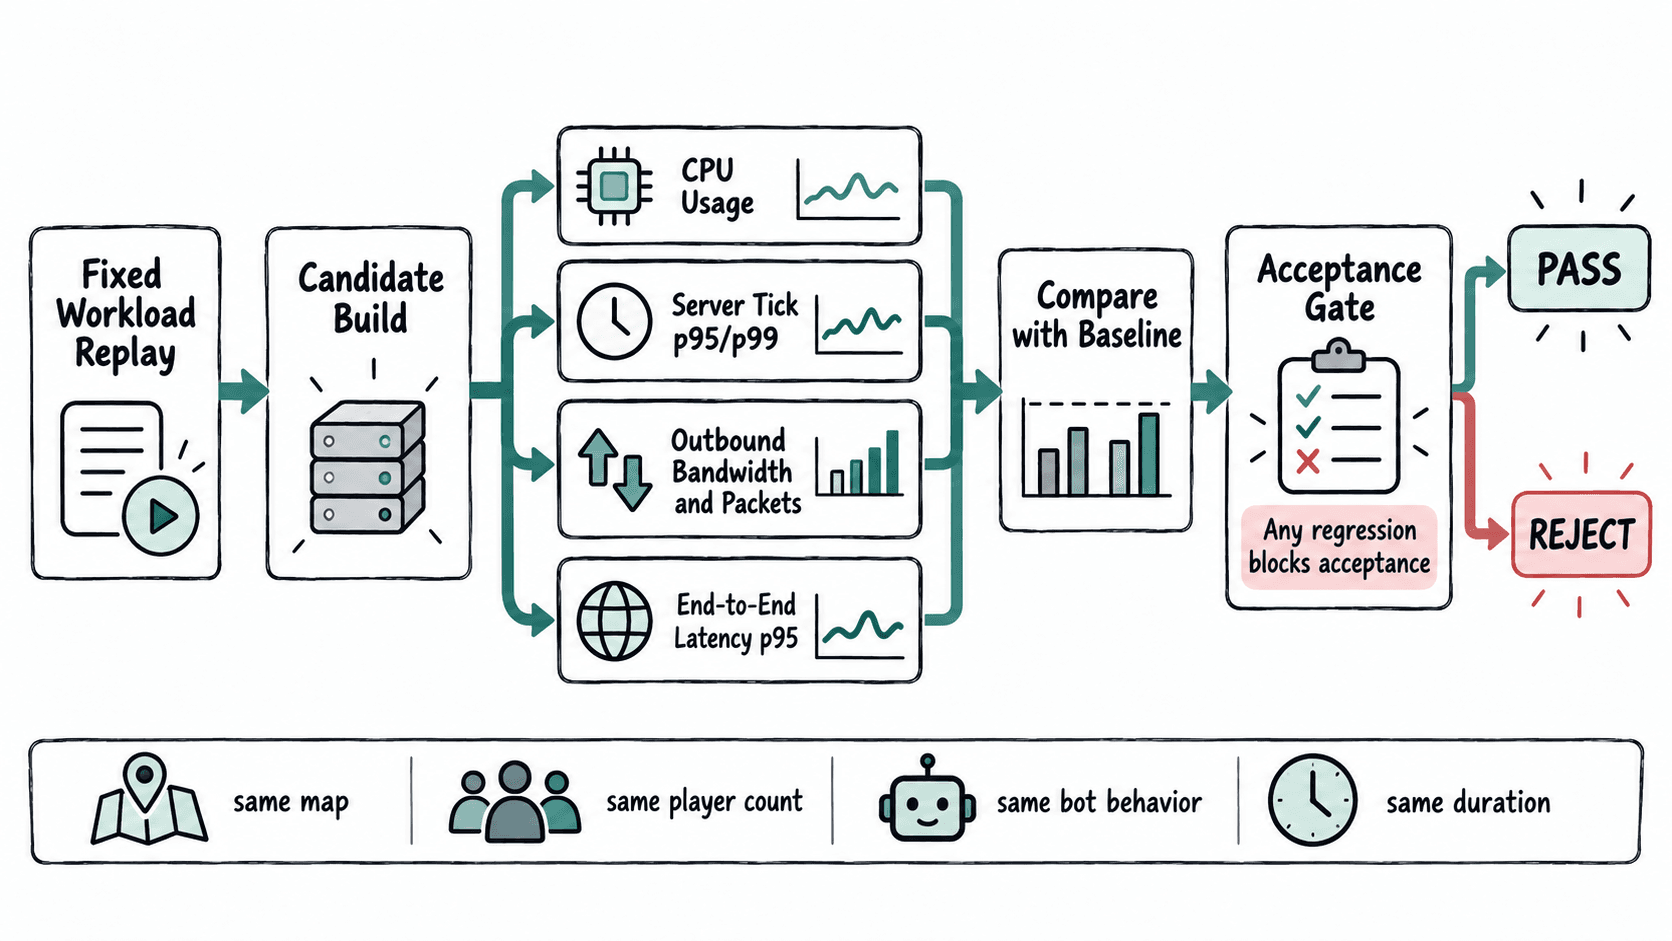
因此,优化结果至少要回答四个问题:CPU 是否下降或保持可控、Tick p95 是否没有恶化、出口带宽是否真正减少、玩家感知的延迟是否没有回归。若只报告其中一个指标,成本转移就很容易被隐藏。
先固定负载再比较版本
联合指标只有在输入条件一致时才有意义。基线版本与候选版本应使用相同地图、玩家数量、机器人行为脚本、测试时长、服务器规格和网络条件,并尽量让压测从相同的暖机阶段开始。否则 CPU 或延迟变化可能来自负载差异,而不是代码改动。
推荐至少记录以下四组核心数据:CPU 使用率或每 Tick CPU 时间、Tick p95/p99、服务器出口带宽、端到端延迟 p95。若改动涉及分包或重传,还应把 packets/s、丢包率和发送队列长度作为保护指标。平均值只能帮助观察总体趋势,决定是否通过时应更重视尾部延迟和 Tick 长尾。
用自动规则阻止指标回归
下面的 Python 脚本模拟一次基线与候选版本对比。这里规定 CPU、带宽和 Tick 不允许变差,端到端延迟最多允许比基线高 5%。实际项目应从压测系统读取真实统计值,并根据业务目标调整阈值。
import sys

baseline = {
    "cpu_pct": 72.0,
    "outbound_mbps": 85.0,
    "tick_p95_ms": 18.4,
    "latency_p95_ms": 73.0,
}

candidate = {
    "cpu_pct": 61.0,
    "outbound_mbps": 61.0,
    "tick_p95_ms": 15.9,
    "latency_p95_ms": 70.0,
}

checks = {
    "cpu_pct": lambda new, old: new <= old,
    "outbound_mbps": lambda new, old: new <= old,
    "tick_p95_ms": lambda new, old: new <= old,
    "latency_p95_ms": lambda new, old: new <= old * 1.05,
}

failed = False

for name, old in baseline.items():
    new = candidate[name]
    change_pct = (new / old - 1.0) * 100.0
    passed = checks[name](new, old)
    print(
        f"{name}: {old:.1f} -> {new:.1f} "
        f"({change_pct:+.1f}%) {'PASS' if passed else 'FAIL'}"
    )
    failed = failed or not passed

print("OVERALL:", "FAIL" if failed else "PASS")
sys.exit(1 if failed else 0)
预期输出
cpu_pct: 72.0 -> 61.0 (-15.3%) PASS
outbound_mbps: 85.0 -> 61.0 (-28.2%) PASS
tick_p95_ms: 18.4 -> 15.9 (-13.6%) PASS
latency_p95_ms: 73.0 -> 70.0 (-4.1%) PASS
OVERALL: PASS
这个脚本的价值不是四个固定阈值,而是把“是否接受优化”变成显式规则。假设带宽从 85 Mbps 降到 50 Mbps,但 Tick p95 从 18.4 ms 升到 24 ms,那么候选版本就应该失败,除非团队已经证明新的 Tick 预算仍满足目标并重新定义了基线。
指标要在同一时间轴上解释
只比较测试结束后的四个汇总数字还不够。发生尖峰时,应把 CPU、Tick、发送字节、发送队列和延迟放到同一时间轴上看因果顺序。例如先出现 CPU 峰值,随后 Tick 变长,再看到发送队列增加和客户端延迟抬升,通常说明服务器算不完导致网络发送被推迟,而不是链路本身突然变差。
反过来,如果 CPU 和 Tick 稳定,但带宽接近网卡或宿主机限额后延迟与丢包一起升高,则更应从包量、突发发送、队列和限速策略排查。联合指标的目的正是区分“网络是根因”还是“网络只是最后暴露症状的地方”。
给每次优化设置通过条件
一次网络优化至少应有一个主目标和若干保护条件。例如主目标是“出口带宽下降 25%”,保护条件可以是“CPU 不增加超过 3 个百分点、Tick p95 不恶化超过 5%、延迟 p95 不恶化超过 5%”。阈值要来自产品目标和历史基线,而不是为了让某次改动通过临时调整。
发布前还应在多个玩家规模上重复验证,因为 20 人场景通过,不代表 100 人场景没有新的拐点。只有当带宽收益在目标负载下成立,并且 CPU、Tick 与延迟都没有出现不可接受的回归,这次优化才算真正降低了系统成本,而不是把瓶颈从一列指标搬到了另一列。