
多人游戏与网络同步 / 系统课时
复制计算为什么会吃掉服务器 CPU
复制计算为什么会吃掉服务器 CPU
多人服务器的复制开销并不只发生在“发包”瞬间。每个 Tick 都可能先扫描对象,再为每个连接判断相关性,随后比较变化、序列化字段并准备发送队列。理解这些阶段,才能知道 CPU 时间究竟消耗在哪里,以及该从对象数量、判断次数还是序列化成本下手。
学习目标
- 拆解复制 Tick 中对象遍历、相关性判断、序列化与发送准备的 CPU 成本
- 用一个可计算的成本模型判断哪个阶段最值得优化
- 区分“网络带宽高”和“复制 CPU 高”这两个不同问题
一次复制 Tick 实际做了什么
典型权威服务器会在固定 Tick 中更新世界,然后决定哪些状态需要发给哪些客户端。复制阶段的核心工作通常可以抽象为四段:扫描候选对象、判断对象与连接是否相关、把需要更新的字段编码成网络表示、把结果放入待发送队列。
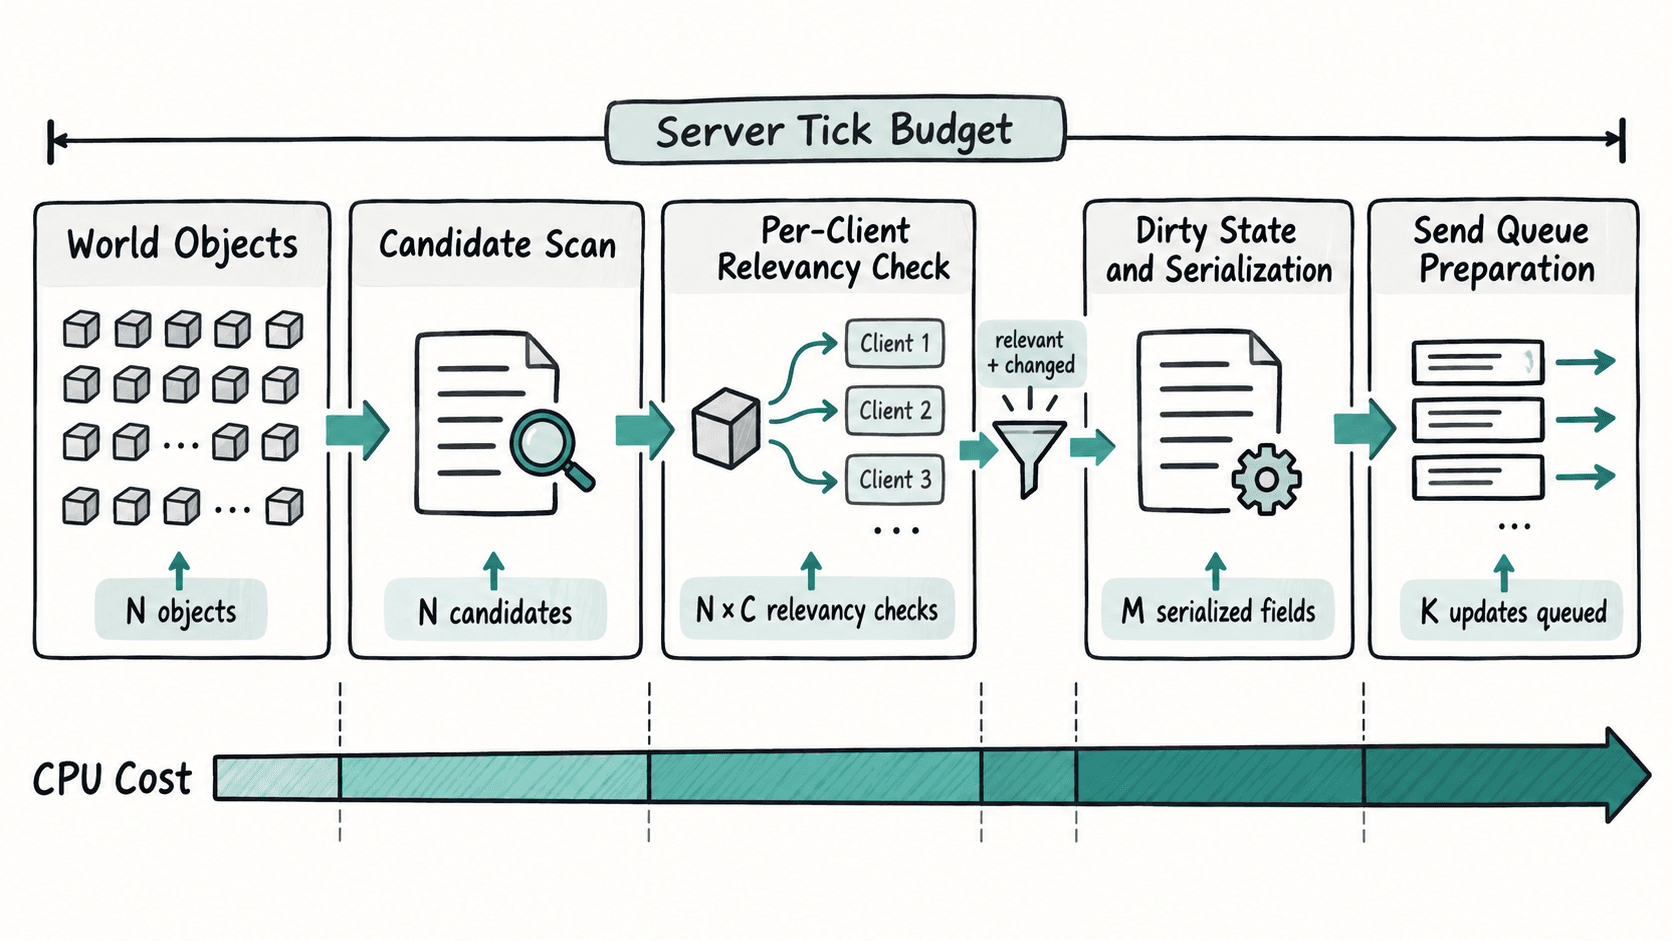
最容易被低估的是乘法效应。假设有 个候选对象、 个客户端,如果相关性判断接近“每个客户端检查大量对象”,判断次数会向 靠近。即使单次判断只需几百纳秒或几微秒,数量放大后也会吃掉明显的 Tick 预算。
四类成本怎样累积
对象遍历的成本主要与候选集合大小有关。休眠对象、远距离对象或本可提前排除的对象如果仍进入扫描,服务器会先为“永远不会发送”的对象付一次 CPU 成本。
相关性判断通常是第二个放大器。距离检查很便宜,但视野、队伍、房间、权限、空间分区等规则叠加后,每个“对象—连接”组合都可能执行多次分支和数据访问。客户端越多,这一段越容易成为热点。
序列化成本取决于真正进入更新的对象数量、字段数量和编码方式。复杂结构、字符串、动态数组、压缩或自定义编码都可能使一次更新比简单的位置量化昂贵得多。发送准备还会产生缓冲区写入、包组装和队列管理成本,但它与实际 socket 发送并不是一回事。
用成本模型检查 Tick 预算
下面的 Python 程序把一次复制 Tick 简化为“操作次数 × 单次平均耗时”。它不是某个引擎的真实 Profiler,但可以帮助你读懂采样数据:优化优先级应看总成本,而不是只看单次操作有多贵。
stages = [
    ("object_scan", 5000, 0.25),
    ("relevance", 3000, 0.80),
    ("serialize", 800, 2.20),
    ("enqueue", 800, 0.60),
]

rows = []
total_us = 0.0

for name, operations, us_per_op in stages:
    cost_us = operations * us_per_op
    rows.append((name, cost_us))
    total_us += cost_us

print(f"tick replication cost: {total_us / 1000:.2f} ms")
for name, cost_us in rows:
    print(f"{name:12} {cost_us / 1000:5.2f} ms  {cost_us / total_us:5.1%}")

tick_budget_ms = 1000 / 60
print(f"60 Hz budget share: {(total_us / 1000) / tick_budget_ms:.1%}")
预期输出
tick replication cost: 5.89 ms
object_scan   1.25 ms  21.2%
relevance     2.40 ms  40.7%
serialize     1.76 ms  29.9%
enqueue       0.48 ms   8.1%
60 Hz budget share: 35.3%
在这个例子里,单次最贵的是序列化,但总成本最高的是相关性判断,因为它执行得更多。对于 60 Hz 服务器,16.67 ms 左右就是一个 Tick 的总预算,复制阶段单独占 5.89 ms 已经很重;如果游戏逻辑、物理和 AI 也需要同一预算,Tick 超时会迅速出现。
优化时先缩小工作量
复制 CPU 优化通常应先减少“做多少次”,再优化“每次多快”。优先检查候选对象是否过多、每个客户端的相关集合是否过大、静止对象是否仍频繁检查、未变化对象是否过早进入序列化,以及昂贵字段是否能降低更新频率。
只有当工作量已经合理,才值得进一步优化单次相关性判断、序列化格式或内存分配。否则,把一次检查从 0.8 微秒降到 0.6 微秒,往往不如把 3000 次检查降到 1000 次有效。
CPU 高时怎样和带宽问题分开
如果服务器 CPU 高但每客户端发送字节数并不高,优先怀疑“检查很多、最后发送很少”的过滤链路;如果 CPU 和带宽都高,则对象数量、更新频率或相关集合可能同时失控。若带宽高而复制 CPU 并不突出,则应继续检查字段大小、压缩策略和发送频率,而不是把所有问题都归因于 Tick 计算。
最终要看的不是“复制系统是否昂贵”这个笼统结论,而是每个 Tick 中哪一类工作占用了多少毫秒,以及这部分成本是由对象数、客户端数、更新率还是单次序列化复杂度放大的。