
多人游戏与网络同步 / 系统课时
如何找出最贵的同步对象
如何找出最贵的同步对象
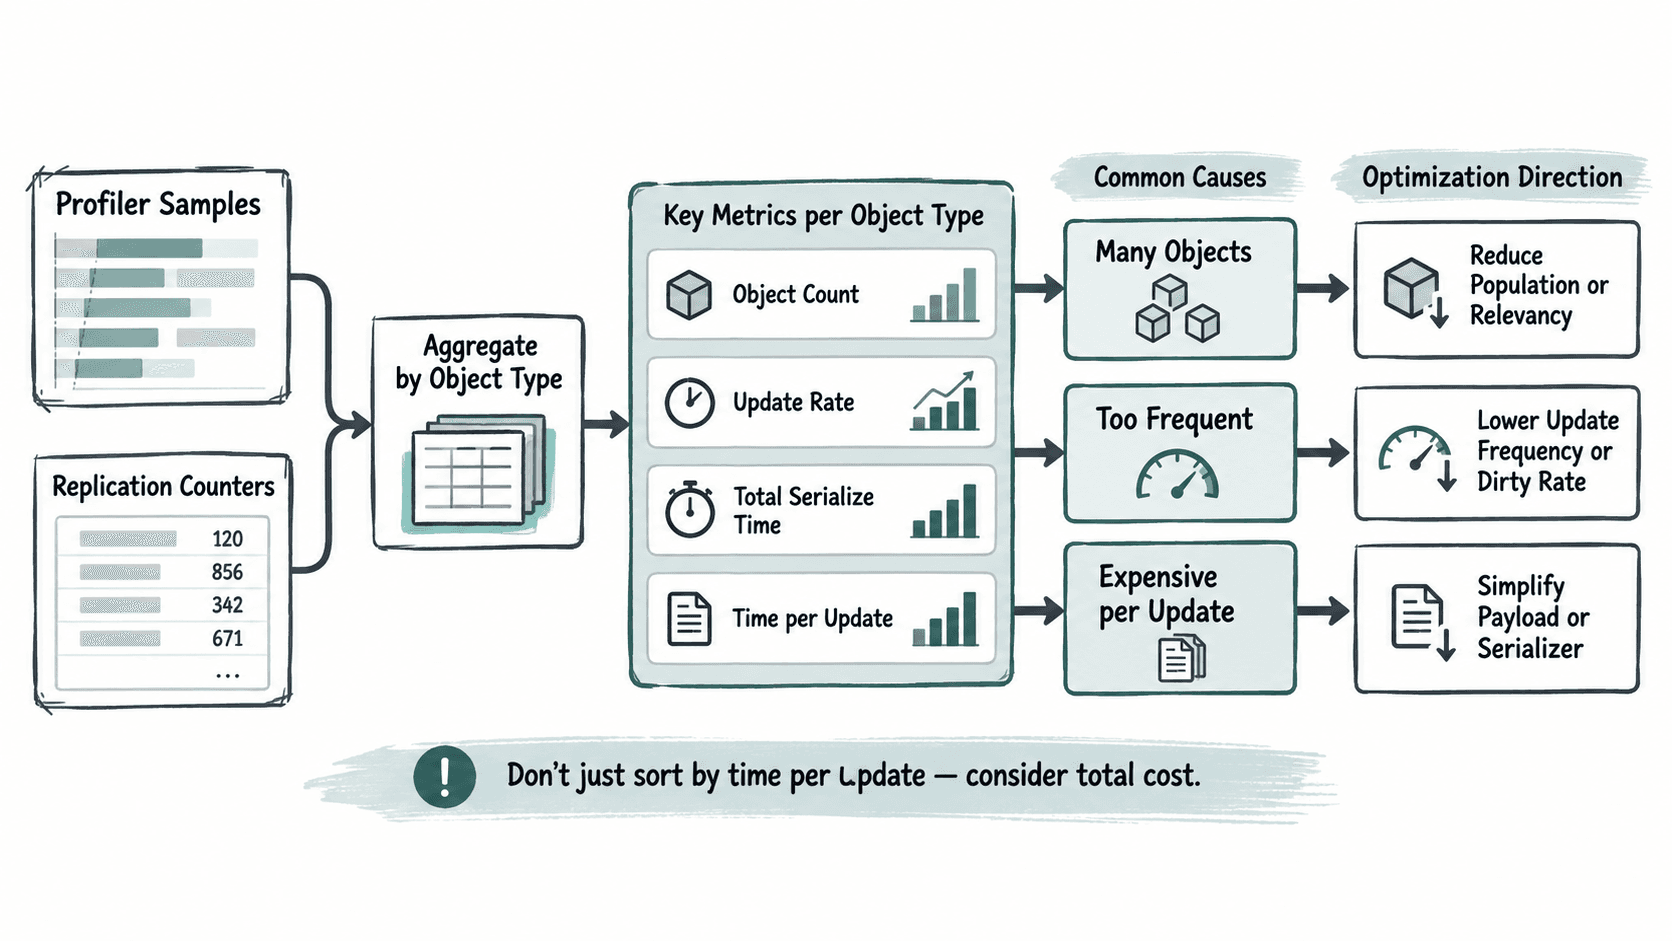
服务器复制变慢时,最有效的做法不是先猜“玩家对象太复杂”,而是把同步成本按对象类型统计出来。需要同时看对象数量、更新频率、累计序列化时间和单次更新成本,才能区分“数量多”“更新勤”和“单次特别贵”这几类根因。
学习目标
- 用采样与聚合数据定位复制成本最高的对象类型
- 区分对象数量、更新率、累计耗时和单次耗时代表的不同问题
- 建立从 Profiler 热点到具体优化动作的排查顺序
先采集能解释成本的数据
一次 Profiler 截图只能告诉你某个函数在某一时刻很热,却不一定能解释是哪类对象造成的。更有用的做法是在连续一段稳定负载中,按对象类型记录至少四项数据:参与检查的对象数、实际产生更新的次数、序列化累计耗时、样本对应的 Tick 数。
如果引擎已经能按类名、网络组件或复制节点打标签,优先使用现成标签;否则可在开发或压测构建中增加轻量统计。统计代码应放在复制主路径的边界上,避免为每个字段打印日志,因为日志本身会严重扰动结果。
用聚合结果排出第一嫌疑人
下面的 Python 示例模拟两个采样窗口,并按对象类型聚合。只使用标准库,直接运行即可观察三种典型对象:Projectile 数量多且更新多,NPC 单次序列化最贵,Player 更新率最高。
from collections import defaultdict

samples = [
    ("Player", 60, 55, 900),
    ("Projectile", 800, 620, 2480),
    ("NPC", 180, 70, 1540),
    ("Player", 60, 54, 880),
    ("Projectile", 820, 640, 2560),
    ("NPC", 182, 72, 1584),
]

totals = defaultdict(lambda: [0, 0, 0])

for object_type, objects, updates, serialize_us in samples:
    row = totals[object_type]
    row[0] += objects
    row[1] += updates
    row[2] += serialize_us

ranked = sorted(
    totals.items(),
    key=lambda item: item[1][2],
    reverse=True,
)

for object_type, (objects, updates, serialize_us) in ranked:
    print(
        f"{object_type:10} "
        f"objects={objects:4} "
        f"updates={updates:4} "
        f"update_rate={updates / objects:.1%} "
        f"serialize_ms={serialize_us / 1000:.3f} "
        f"us_per_update={serialize_us / updates:.2f}"
    )
预期输出
Projectile objects=1620 updates=1260 update_rate=77.8% serialize_ms=5.040 us_per_update=4.00
NPC        objects= 362 updates= 142 update_rate=39.2% serialize_ms=3.124 us_per_update=22.00
Player     objects= 120 updates= 109 update_rate=90.8% serialize_ms=1.780 us_per_update=16.33
如果只看单次耗时,会先优化 NPC;但按累计序列化时间看,Projectile 才是当前负载下最大的总成本来源。它每次只花 4 微秒,却因为对象多、更新次数多,在两个样本窗口里累计到 5.04 ms。
四个指标分别说明什么
objects 高说明候选对象基数大,适合检查对象生命周期、空间分区和兴趣区域。update_rate 高说明对象经常被判定为需要同步,应检查 dirty 标记、阈值和同步频率。serialize_ms 是对 CPU 预算最直接的累计贡献,适合用来做第一轮排序。us_per_update 高则表示单个对象的字段布局、容器、字符串或自定义编码可能过重。
这四个指标要联合解释。例如“对象很多但更新率很低”未必是序列化问题,却仍可能让前面的遍历和相关性判断昂贵;“对象很少但单次极贵”更像负载结构或序列化实现问题。只保留一个总耗时数字,会把这些根因混在一起。
从热点落到具体修复
对累计成本最高的类型,继续向下拆字段或复制组件,而不是立刻全局改协议。若 Projectile 主要因为数量和更新率高,应先减少无意义实例、缩小相关集合,或把远距离投射物降频;若 NPC 是单次成本高,则应查看是否发送大数组、字符串、嵌套状态或重复编码数据。
修复后重新采集同样窗口,至少比较总复制耗时、目标对象类型的累计耗时和 Tick 超时比例。真正有效的优化应让热点类型的累计成本下降,同时不把成本转移到别的阶段;如果只看到平均单次耗时下降,而总 Tick 时间没有变化,就还没有解决服务器真正的瓶颈。