
多人游戏与网络同步 / 系统课时
大地图为什么容易产生同步浪费
大地图为什么容易产生同步浪费
大地图本身不会直接让网络变慢,真正的问题是客户端通常只需要附近少量状态,而服务器却可能扫描、判定甚至发送整个世界的对象。本课用一个可量化模型拆开空间范围、对象密度和玩家移动带来的浪费,并给出优化前应先观测的指标。
学习目标
- 说明大地图中“对象很多”和“真正相关的对象很少”为什么会形成同步浪费。
- 用总对象数、相关对象数和切换频率量化浪费来源。
- 根据候选集、实际复制量和相关集抖动判断下一步优化方向。
同步浪费从哪里来
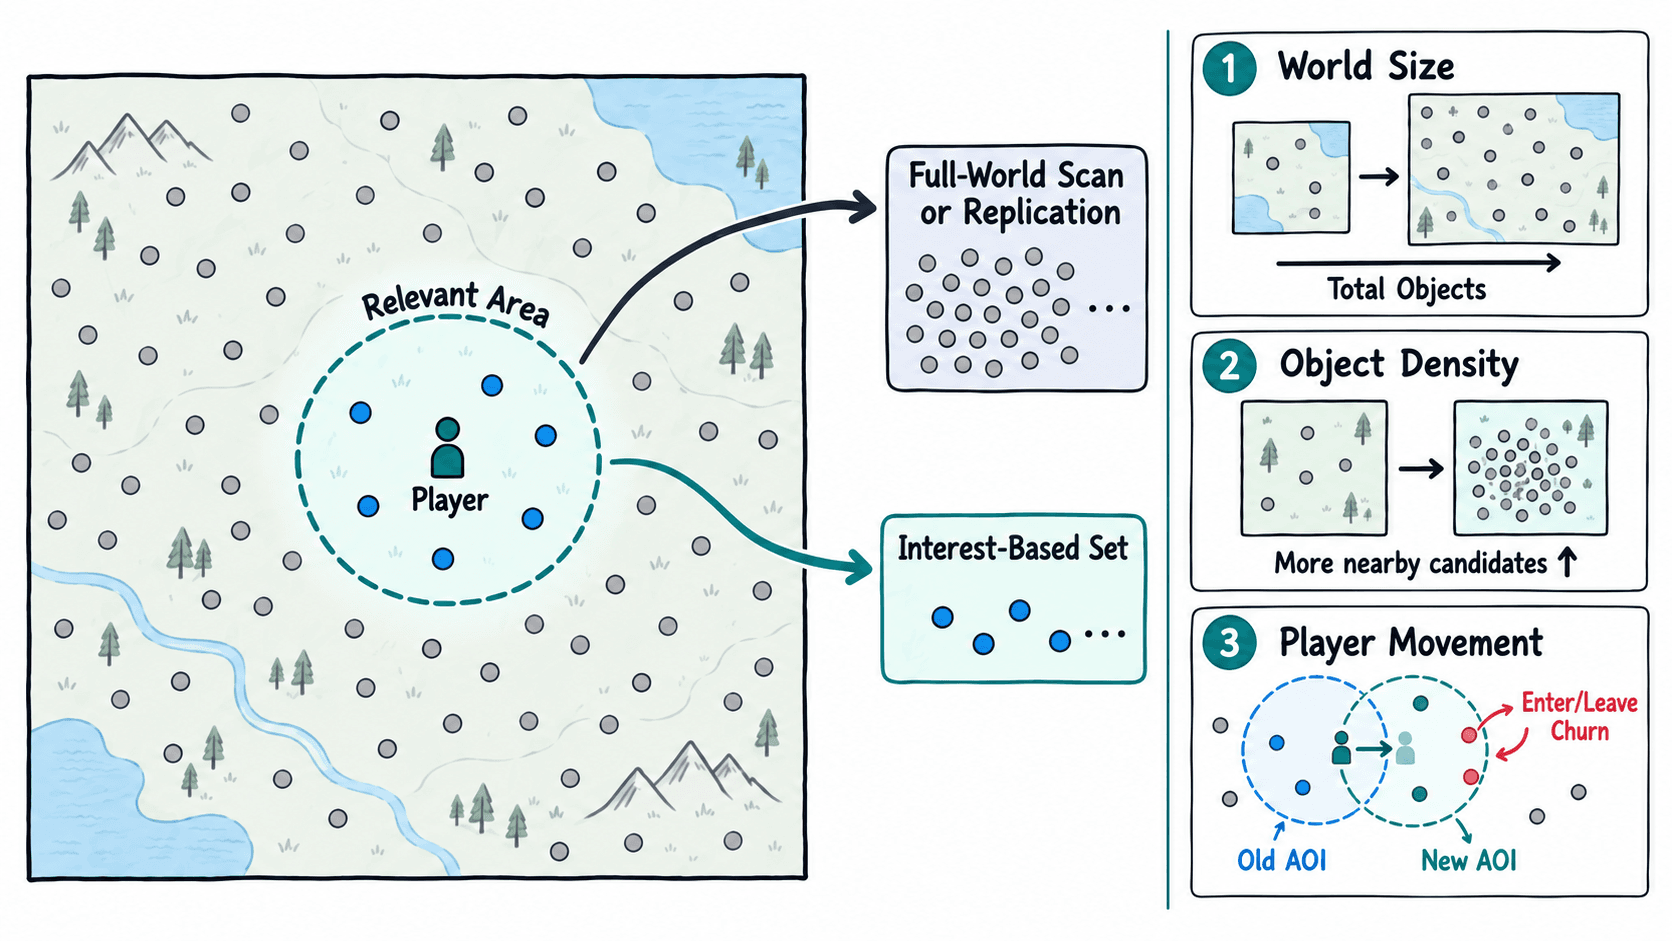
对某个客户端来说,世界中存在的对象集合并不等于需要同步的对象集合。假设地图里共有 个网络对象,而当前玩家真正需要的只有 个;如果服务器每个同步周期都从全部 个对象开始处理,那么即使最后只发送 个,也已经付出了大量候选扫描和相关性判断成本。
浪费通常出现在三个阶段:先遍历本来就不可能相关的对象,再对这些对象做脏状态、距离或权限判断,最后在缺少兴趣区域机制时还可能把无关状态序列化并发送。因而“没有发出去”并不代表没有成本。
空间、密度和移动怎样放大成本
地图范围扩大时,如果对象随世界规模一起增长,总对象数 会变大;对象密度提高时,玩家附近的相关集 也会增加。两者叠加会同时推高候选判断和实际复制量。
玩家移动还会带来第三种成本:相关集不断发生进入和离开。边界附近对象若频繁在“相关”和“不相关”之间切换,会触发创建、销毁或重新激活等额外消息。高速移动、载具和瞬移尤其容易造成这种抖动。
用最小模型量化浪费
下面的 Node.js 示例把一个 1000×1000 的世界按 10 单位间隔放置 10000 个对象,并假设玩家只需要半径 50 内的状态。它不是完整网络框架,而是用于量化“全量复制”和“实际需要”之间的差距。
const worldSize = 1000;
const step = 10;
const player = { x: 500, y: 500 };
const radius = 50;

const objects = [];
for (let x = 0; x < worldSize; x += step) {
  for (let y = 0; y < worldSize; y += step) {
    objects.push({ x, y });
  }
}

// 只有落在玩家兴趣半径内的对象才视为真正需要复制。
const relevant = objects.filter((obj) => {
  const dx = obj.x - player.x;
  const dy = obj.y - player.y;
  return dx * dx + dy * dy <= radius * radius;
});

const fullReplication = objects.length;
const wasted = fullReplication - relevant.length;
const wasteRatio = (wasted / fullReplication) * 100;

console.log(`total objects: ${fullReplication}`);
console.log(`relevant objects: ${relevant.length}`);
console.log(`unnecessary replicas: ${wasted}`);
console.log(`waste ratio: ${wasteRatio.toFixed(2)}%`);
预期输出
total objects: 10000
relevant objects: 81
unnecessary replicas: 9919
waste ratio: 99.19%
这个结果说明:如果客户端只需要 81 个对象,全量复制会让 9919 个对象成为无效网络负载。即使系统已经在发送前过滤,如果每个周期仍先扫描全部 10000 个对象,CPU 侧依然存在明显浪费。
优化前先看哪些指标
先把“候选太多”和“真正需要同步的对象太多”区分开,否则容易用错误手段优化。建议至少记录每个客户端的总对象数、进入相关性判断的候选数、最终相关对象数,以及单位时间内相关集的进入和离开次数。
候选数远大于相关数时,优先引入空间分区或更便宜的粗筛;相关数本身已经很大时,应继续缩小兴趣范围、降低发送频率或减少状态字段;进入和离开次数异常高时,则要检查边界滞回、预加载范围和高速移动策略。这样才能确定浪费发生在“找对象”“判对象”还是“发对象”这一层。