
多人游戏与网络同步 / 系统课时
可靠重传为什么会放大延迟
可靠重传为什么会放大延迟
可靠传输能避免消息永久丢失,却可能把一次普通丢包扩展成连续的延迟尖峰。问题不只发生在“重传那一包”:等待确认、顺序交付、拥塞控制和发送队列都会让后续数据一起变旧。本篇拆解这条延迟放大链路。
学习目标
- 解释丢包如何触发重传并增加消息完成时间
- 理解可靠有序通道中的队头阻塞与消息堆积
- 识别可靠流量与实时状态竞争带宽时的延迟风险
一次丢包不只损失一个包
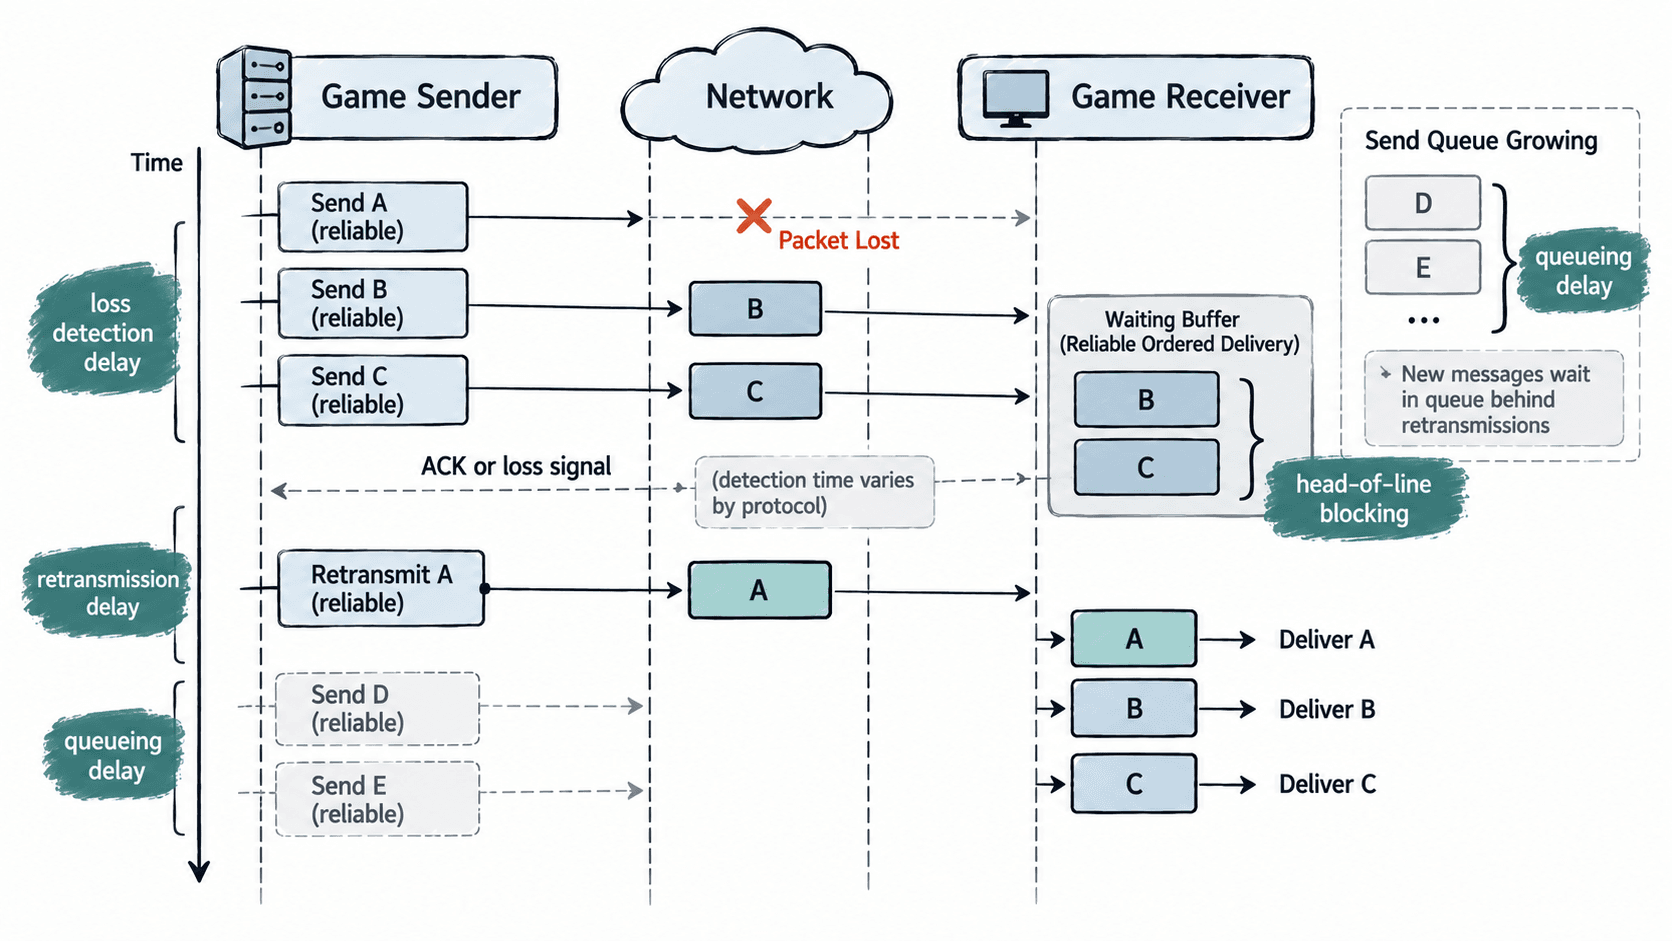
假设客户端连续发送可靠消息 A、B、C,其中承载 A 的数据包丢失。发送方必须根据确认机制发现缺口,再重新发送缺失数据。即使网络往返时间本来很低,A 的完成时间也至少多出一次“发现丢失并补发”的等待。
具体检测方式取决于传输协议:有的依靠重复 ACK 或选择确认较快发现缺口,有的还可能等待重传计时器。不能把所有协议都简化成固定增加一个 RTT,但共同点是:可靠性需要额外反馈和再次发送,因此丢包后的完成时间一定比无丢包路径更长。
有序可靠会产生队头阻塞
如果通道要求按发送顺序交付,那么问题会进一步扩大。A 丢失后,B 和 C 即使已经完整到达,也可能因为序号更靠后而不能立即交给游戏逻辑。接收端只能暂存它们,等待 A 被恢复。
这就是队头阻塞。真正受影响的已经不是 A 一条消息,而是 A 后方所有依赖同一有序交付序列的数据。假如 B 是聊天文本,C 是背包确认,这种等待可能可以接受;如果 C 恰好是需要立即显示的战斗状态,体验就会明显恶化。
需要注意,队头阻塞的范围取决于传输设计。TCP 的字节流会在连接内保持有序;自定义的 reliable ordered UDP 通道也常有类似行为。QUIC 可以把不同流之间的有序交付隔离开,因此一个流丢包不必阻塞另一个流,但丢失数据仍然需要重传,也仍可能受到拥塞与带宽限制。
重传还会和新数据抢带宽
丢包发生后,网络中不仅要继续发送当前 tick 的新数据,还要重新发送旧的可靠数据。如果可用上行或下行带宽已经接近上限,重传会占用原本可以交给新状态的容量。
此时容易形成连续反应:旧可靠消息重传,占用发送预算;新消息进入队列;排队时间增加;消息真正发出时已经更旧;若网络仍然拥塞,还可能继续丢包。最终看到的不是单次卡顿,而是一段持续数百毫秒甚至更久的高延迟区间。
混在一个可靠队列会让问题更明显
多人游戏常同时存在实时状态与必须最终送达的事务消息。如果它们全部进入同一个可靠有序队列,一条较大的低优先级消息就可能影响后续的小型高优先级消息。
例如,玩家进入场景时正在可靠传输一批较大的初始数据,同时又产生了装备切换确认。若两者严格共享同一顺序队列,后者可能只能排在大消息之后。即使装备确认本身只有几十字节,它的端到端延迟仍取决于前面排队的数据量。
更合理的设计通常包括:限制单次可靠消息大小,把大块数据拆分;区分实时与非实时发送预算;在传输能力允许时使用独立通道或独立流隔离不同类型的可靠数据;对于能被新状态覆盖的数据,则避免加入可靠重传队列。
排查时观察四段延迟
看到“Ping 不高,但可靠消息偶尔很慢”时,不应只查看平均 RTT。至少要分别观察丢包检测时间、重传完成时间、接收端等待顺序交付的时间,以及发送队列中的排队时间。
如果网络丢包率上升后发送队列长度同步增加,并且消息年龄持续增长,说明瓶颈已经从一次丢包演化成队列堆积。如果只有某个有序通道停顿,而其他独立通道仍正常,则应优先检查该通道的缺失序号和队头阻塞。
可靠传输真正的成本因此不是“多发一次包”,而是一次丢包可能同时触发重传等待、顺序阻塞和带宽竞争。把必须可靠的消息范围缩小,并隔离不同实时性要求的数据,往往比单纯增加重试次数更能改善多人游戏的尾延迟。