
C / C++ / 系统课时
用哈希表快速查找任务
用哈希表快速查找任务
任务数量增长后,每次按编号从头遍历都会让查找成本随记录数增加。本节为已有任务建立“任务编号 → Task *”哈希索引,并用拉链法处理冲突,使常见查找不必扫描全部任务,同时明确索引与任务对象之间的所有权边界。
学习目标
- 理解哈希表为何适合按唯一任务编号建立索引
- 用拉链法实现插入、查找与冲突处理
- 正确维护哈希节点与
Task对象的生命周期,避免悬空指针
索引只保存任务引用
任务本体仍由任务管理器拥有,哈希表只保存编号和 Task *。查找时先把编号映射到桶,再沿桶内链表比较键;如果多个编号落到同一个桶,它们通过链表共存,而不是互相覆盖。
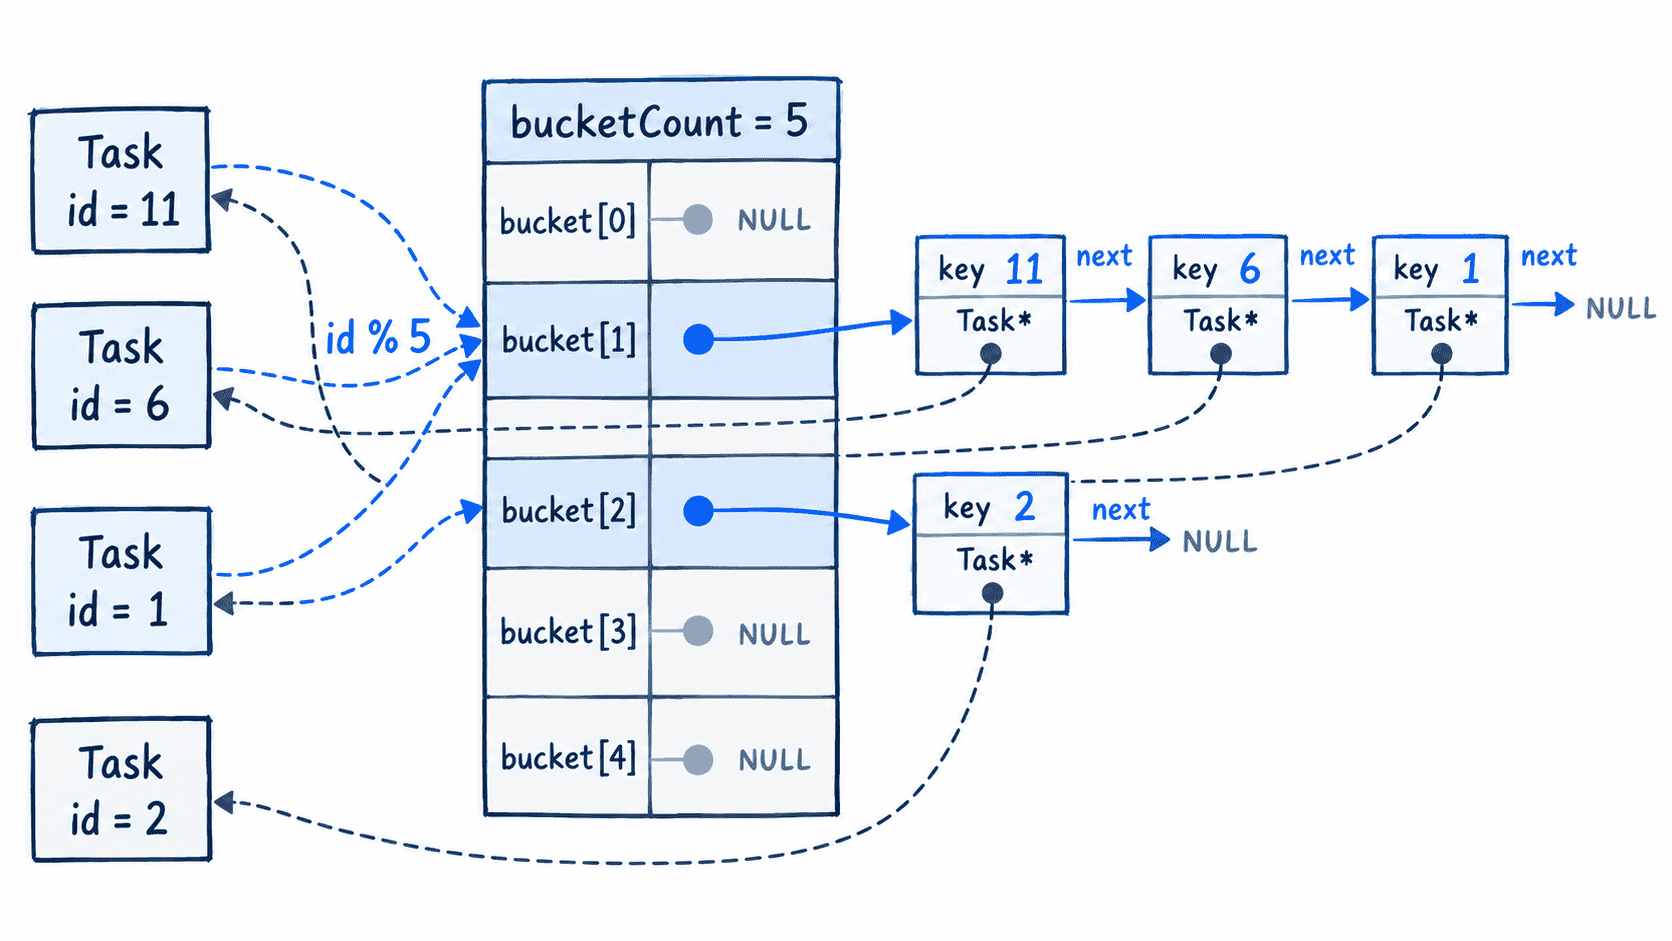
桶数组中的节点属于哈希表,Task 不属于哈希表。销毁索引时只能释放哈希节点和桶数组,不能顺手释放 Task,否则管理器里仍保存的任务指针会变成悬空指针。
实现拉链法哈希表
下面程序用 5 个桶故意制造冲突:编号 1、6、11 都映射到 bucket[1]。插入时先拒绝重复编号,再把新节点挂到链表头部;查找时只遍历目标桶。
#include <stdio.h>
#include <stdlib.h>

typedef struct {
    unsigned long id;
    const char *title;
} Task;

typedef struct HashNode {
    unsigned long key;
    Task *task;
    struct HashNode *next;
} HashNode;

typedef struct {
    HashNode **buckets;
    size_t bucket_count;
} HashTable;

static size_t hash_id(const HashTable *table, unsigned long key) {
    return key % table->bucket_count;
}

static int hash_table_init(HashTable *table, size_t bucket_count) {
    table->buckets = calloc(bucket_count, sizeof(HashNode *));
    if (table->buckets == NULL) {
        return 0;
    }
    table->bucket_count = bucket_count;
    return 1;
}

static Task *hash_table_find(const HashTable *table, unsigned long key) {
    size_t index = hash_id(table, key);
    for (HashNode *node = table->buckets[index];
         node != NULL;
         node = node->next) {
        if (node->key == key) {
            return node->task;
        }
    }
    return NULL;
}

static int hash_table_insert(HashTable *table, Task *task) {
    if (hash_table_find(table, task->id) != NULL) {
        return 0;
    }

    size_t index = hash_id(table, task->id);
    HashNode *node = malloc(sizeof(HashNode));
    if (node == NULL) {
        return 0;
    }

    node->key = task->id;
    node->task = task;
    node->next = table->buckets[index];
    table->buckets[index] = node;
    return 1;
}

static Task *linear_find(Task *tasks, size_t count, unsigned long id) {
    for (size_t i = 0; i < count; i++) {
        if (tasks[i].id == id) {
            return &tasks[i];
        }
    }
    return NULL;
}

static void hash_table_destroy(HashTable *table) {
    for (size_t i = 0; i < table->bucket_count; i++) {
        HashNode *node = table->buckets[i];
        while (node != NULL) {
            HashNode *next = node->next;
            free(node);
            node = next;
        }
    }
    free(table->buckets);
}

int main(void) {
    Task tasks[] = {
        {1, "write parser"},
        {6, "add tests"},
        {11, "write docs"},
        {2, "review memory"}
    };
    const size_t task_count = sizeof(tasks) / sizeof(tasks[0]);

    HashTable table;
    if (!hash_table_init(&table, 5)) {
        fprintf(stderr, "hash init failed\n");
        return 1;
    }

    for (size_t i = 0; i < task_count; i++) {
        if (!hash_table_insert(&table, &tasks[i])) {
            fprintf(stderr, "hash insert failed\n");
            hash_table_destroy(&table);
            return 1;
        }
    }

    Task *by_hash = hash_table_find(&table, 11);
    Task *by_scan = linear_find(tasks, task_count, 11);
    Task *missing = hash_table_find(&table, 99);

    printf("hash find id=11: %s\n", by_hash->title);
    printf("linear find id=11: %s\n", by_scan->title);
    printf("missing id=99: %s\n", missing == NULL ? "not found" : "found");

    hash_table_destroy(&table);
    return 0;
}
预期输出
hash find id=11: write docs
linear find id=11: write docs
missing id=99: not found
两个查找方法得到同一任务,但路径不同。线性查找最多检查全部任务;哈希查找先定位一个桶,平均情况下只需要检查少量节点。
冲突与复杂度边界
哈希表的优势来自桶分布,而不是“永远一步命中”。若键分布均匀且桶数量合适,插入和查找的平均复杂度通常接近 ;如果大量键都落入同一个桶,链表会变长,最坏情况仍可能退化到 。
示例直接使用 id % bucket_count,因为任务编号是无符号整数,足够展示索引机制。实际任务量持续增长时,应在负载因子过高时扩容桶数组并重新散列现有节点,否则冲突会越来越集中。
保持索引与任务一致
哈希索引是派生结构,必须和任务存储同步。新增任务时,先成功创建任务,再插入索引;如果索引插入因内存不足失败,应回滚刚创建的任务,或者明确把本次新增判为失败,不能让“列表里有任务、哈希表里却查不到”长期存在。
删除顺序也很重要:应先从哈希表移除对应节点,再释放 Task。如果先释放任务,哈希节点中的 Task * 仍指向已经失效的内存,后续查找可能触发未定义行为。
采用“任务管理器拥有对象,哈希表只做索引”的规则后,存储和查找职责就被清晰分开:动态数组适合顺序遍历全部任务,哈希表负责按唯一编号快速定位同一个任务对象。