
C / C++ / 系统课时
实现一个字符串哈希表
实现一个字符串哈希表
这一节把字符串哈希函数、桶数组和链表真正组合起来,做出一个可插入、更新、查询和释放的基础哈希表。重点不是追求工业级性能,而是看清键如何从字符串变成桶下标,以及发生哈希冲突后如何沿链表继续查找。
学习目标
- 理解字符串哈希值如何映射到固定数量的桶。
- 使用链地址法处理不同字符串落入同一桶的冲突。
- 完成插入、更新、查询和内存释放,并用输出验证结果。
哈希表由哪几部分组成
以字符串为键时,哈希表至少需要三部分:哈希函数负责把字符串变成整数;桶数组负责根据下标快速定位候选区域;桶中的链表负责保存真正的键值对,并处理哈希冲突。
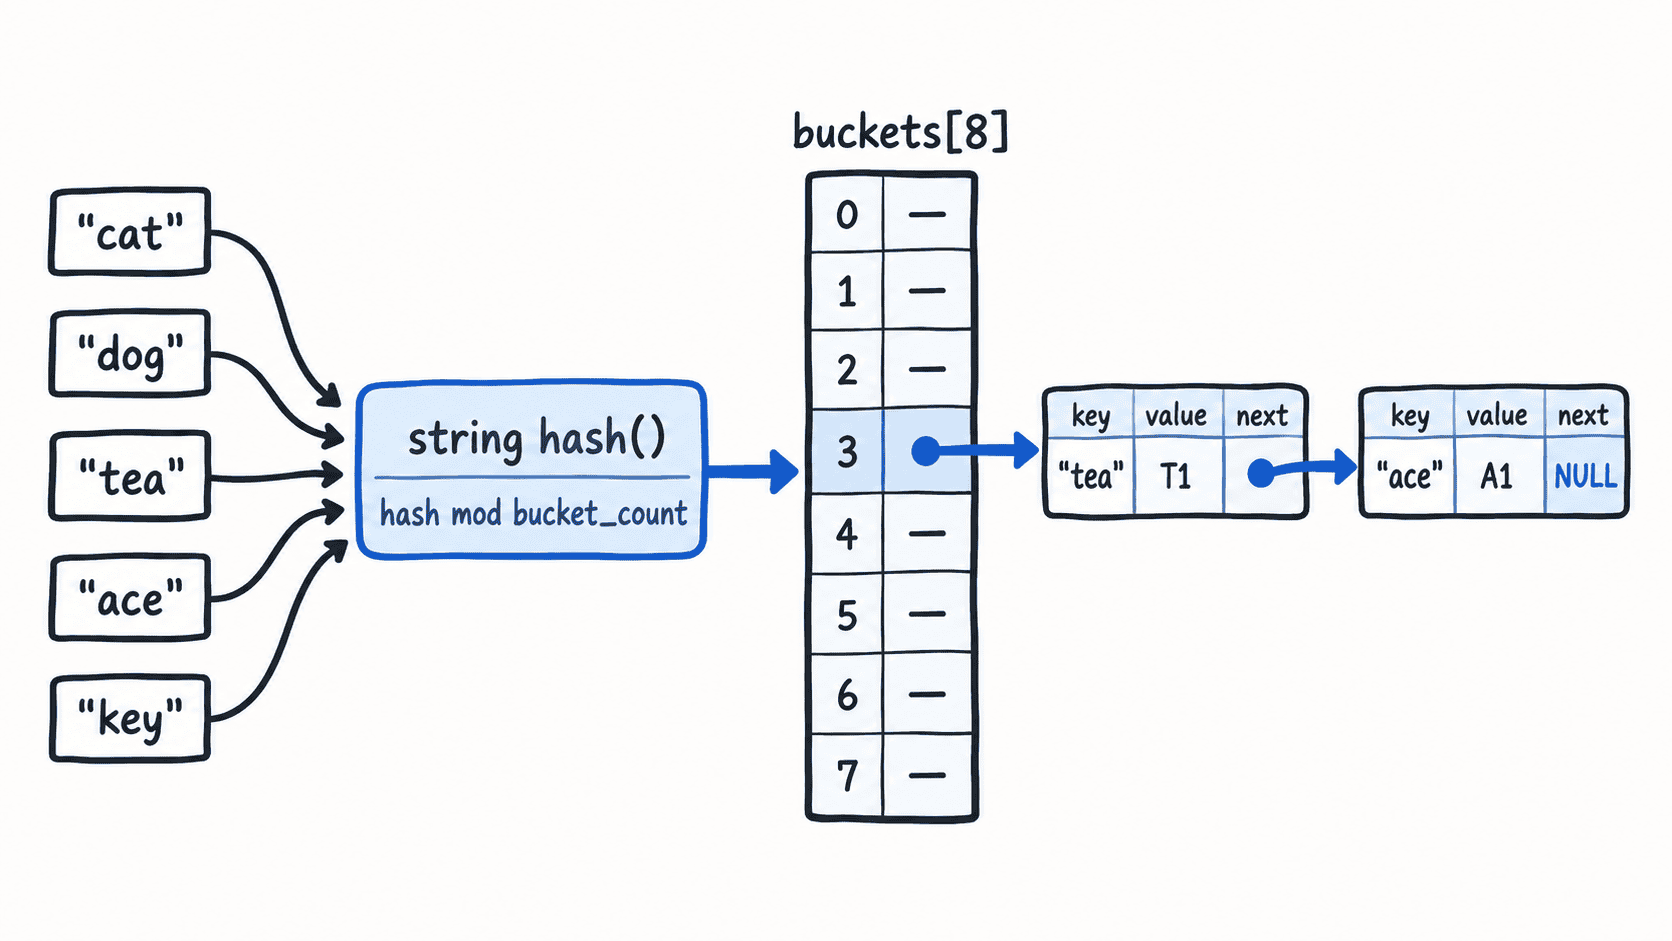
链地址法的关键是:桶数组只保存链表头指针。查询时先用同一个哈希函数找到桶,再逐个比较字符串;只有 strcmp 返回 0 才表示命中真实键,因此哈希值相同并不会把两个键混为一谈。
完整实现
下面使用固定 8 个桶实现最小可运行版本。字符串复制函数自行分配内存,避免依赖非标准的 strdup。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

#define BUCKET_COUNT 8

typedef struct Entry {
    char *key;
    int value;
    struct Entry *next;
} Entry;

typedef struct {
    Entry *buckets[BUCKET_COUNT];
} HashTable;

static unsigned long hash_string(const char *s) {
    unsigned long hash = 5381;
    unsigned char c;

    while ((c = (unsigned char)*s++) != 0) {
        hash = ((hash << 5) + hash) + c;
    }
    return hash;
}

static char *dup_string(const char *s) {
    size_t len = strlen(s) + 1;
    char *copy = malloc(len);

    if (copy != NULL) {
        memcpy(copy, s, len);
    }
    return copy;
}

static void table_init(HashTable *table) {
    for (size_t i = 0; i < BUCKET_COUNT; ++i) {
        table->buckets[i] = NULL;
    }
}

static int table_put(HashTable *table, const char *key, int value) {
    size_t index = hash_string(key) % BUCKET_COUNT;

    for (Entry *p = table->buckets[index]; p != NULL; p = p->next) {
        if (strcmp(p->key, key) == 0) {
            p->value = value;
            return 1;
        }
    }

    Entry *entry = malloc(sizeof(*entry));
    if (entry == NULL) {
        return 0;
    }

    entry->key = dup_string(key);
    if (entry->key == NULL) {
        free(entry);
        return 0;
    }

    entry->value = value;
    entry->next = table->buckets[index];
    table->buckets[index] = entry;
    return 1;
}

static int table_get(const HashTable *table, const char *key, int *out_value) {
    size_t index = hash_string(key) % BUCKET_COUNT;

    for (Entry *p = table->buckets[index]; p != NULL; p = p->next) {
        if (strcmp(p->key, key) == 0) {
            *out_value = p->value;
            return 1;
        }
    }
    return 0;
}

static void table_free(HashTable *table) {
    for (size_t i = 0; i < BUCKET_COUNT; ++i) {
        Entry *p = table->buckets[i];

        while (p != NULL) {
            Entry *next = p->next;
            free(p->key);
            free(p);
            p = next;
        }
        table->buckets[i] = NULL;
    }
}

int main(void) {
    HashTable table;
    int value;

    table_init(&table);

    if (!table_put(&table, "apple", 3) ||
        !table_put(&table, "banana", 5) ||
        !table_put(&table, "name", 42) ||
        !table_put(&table, "orange", 7) ||
        !table_put(&table, "banana", 9)) {
        fprintf(stderr, "memory allocation failed\n");
        table_free(&table);
        return 1;
    }

    if (table_get(&table, "banana", &value)) {
        printf("banana=%d\n", value);
    }
    if (table_get(&table, "name", &value)) {
        printf("name=%d\n", value);
    }

    printf("pear found=%s\n",
           table_get(&table, "pear", &value) ? "yes" : "no");

    table_free(&table);
    return 0;
}
预期输出
banana=9
name=42
pear found=no
在这个 8 桶示例中,banana 与 name 会落入同一桶,但两者仍能分别查到正确值,说明链表冲突处理生效。banana 第二次写入时不会创建重复节点,而是找到已有键并更新为 9;pear 不存在,因此查询返回失败。
冲突为什么不会破坏查询
两个不同字符串可能得到同一个桶下标,这就是哈希冲突。插入新键时,代码先扫描当前桶:若找到同名键就更新;否则把新节点挂到链表头。查询也执行同样的“定位桶,再比较键”流程,所以冲突只会增加桶内比较次数,不会直接产生错误结果。
当键分布均匀、装载因子合理时,插入和查询的平均时间通常接近 ;如果大量键都挤进同一桶,链表会变长,最坏情况下会退化为 。实际哈希表通常会在元素增多时扩容并重新散列。
实现时最容易漏掉的边界
这个版本最值得检查的是内存所有权。表内不能只保存调用者传入的字符串指针,否则原字符串离开作用域或被修改后,键就会失效。因此插入新键时复制字符串,释放表时同时释放键和节点。
另一个边界是空指针约定:当前接口假设 table、key 和 out_value 都是有效指针。若要把它升级为公共库,应明确参数检查策略,并增加删除操作、动态扩容以及更稳定的哈希函数。基础版本先把“哈希定位 + 桶内链表 + 键比较 + 生命周期管理”做对,就已经形成了完整的字符串哈希表索引。