
C / C++ / 系统课时
用大 O 表示算法增长速度
用大 O 表示算法增长速度
比较算法时,单次运行耗时很容易受到 CPU、编译器和输入内容影响。大 O 关注的是数据规模不断增大时,操作数量如何增长,因此更适合判断算法在小数据与大数据下是否仍然可接受。
学习目标
- 理解大 O 描述的是随数据规模变化的增长趋势
- 区分 O(1)、O(log n)、O(n) 和 O(n²) 的增长差异
- 能根据数据规模判断复杂度差异何时开始产生明显影响
大 O 关注增长趋势
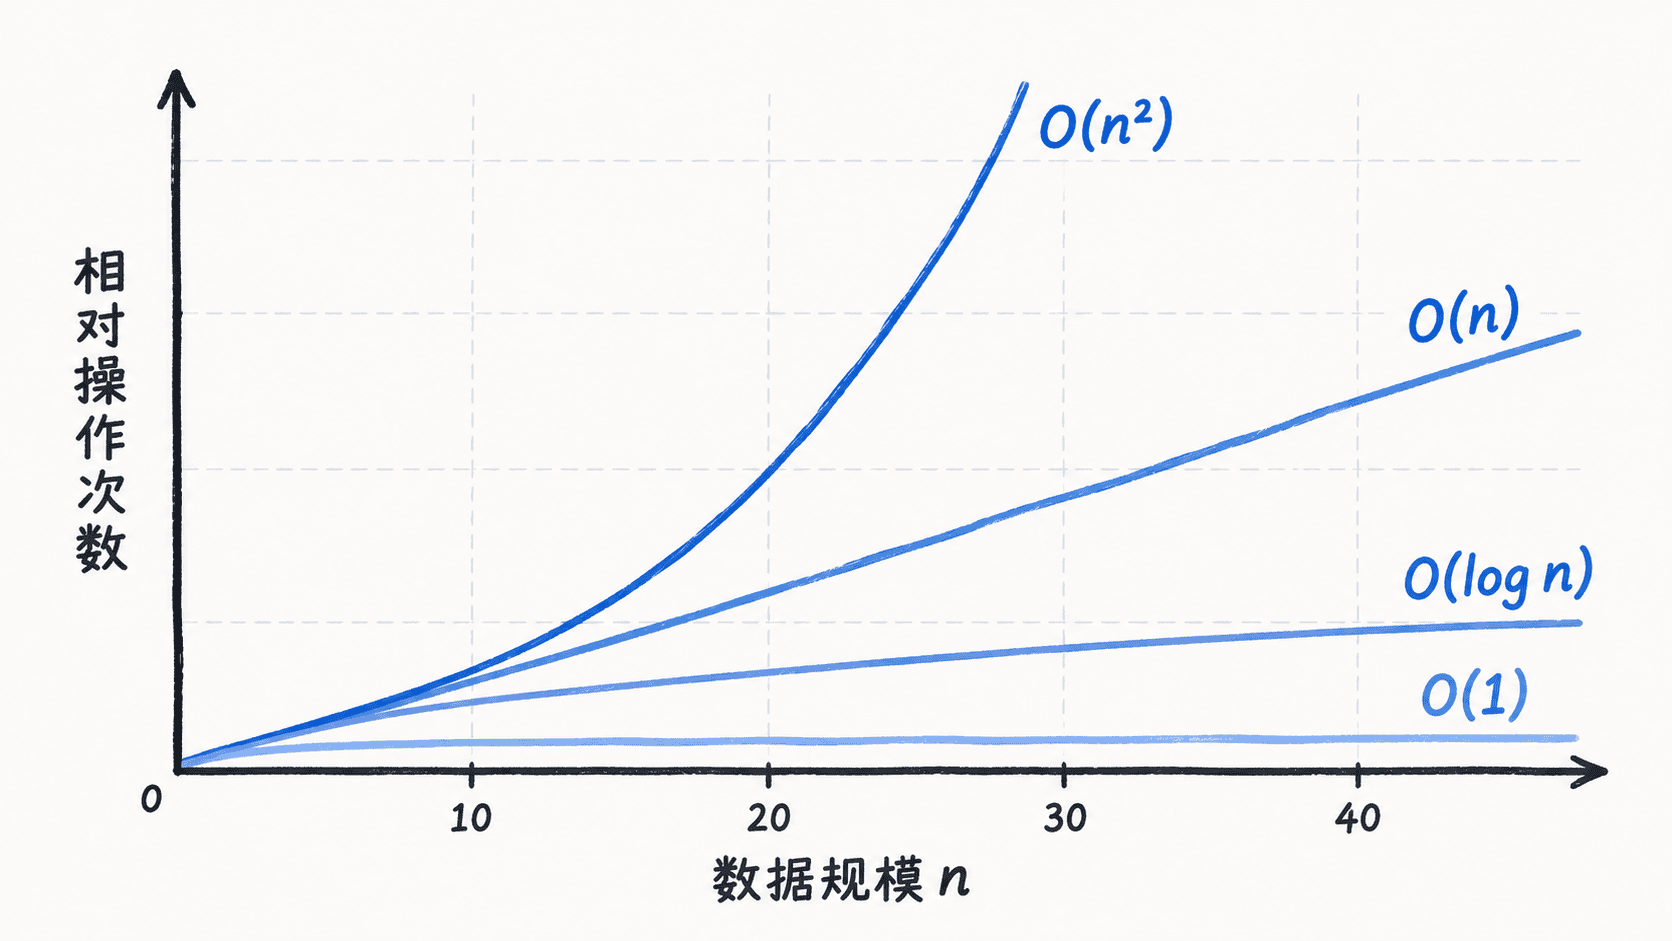
设输入规模为 n。一次固定次数的操作,无论 n 多大都不明显增加工作量,可以记为 O(1);如果工作量与 n 大致成正比,就是 O(n);如果每次操作都能把待处理范围缩小一大部分,常见 O(log n);如果需要对大量元素两两组合处理,则经常出现 O(n²)。
大 O 会忽略常数和低阶项。例如执行次数为 3n + 20,当 n 足够大时,增长主要由 n 决定,因此通常记为 O(n),而不是把固定的 3 和 20 保留下来。
常见复杂度增长有多大差异
下面用近似操作次数观察几种增长速度。O(log n) 一列按以 2 为底的对数向上取整,只用于帮助建立直觉;在大 O 分析中,对数底数通常不会改变复杂度类别。
| 数据规模 n | O(1) | O(log n) | O(n) | O(n²) |
|---|---|---|---|---|
| 10 | 1 | 4 | 10 | 100 |
| 100 | 1 | 7 | 100 | 10000 |
| 1000 | 1 | 10 | 1000 | 1000000 |
当 n 从 100 增加到 1000 时,O(n) 的操作量大约扩大 10 倍,而 O(n²) 会扩大约 100 倍。O(log n) 的增长则非常缓慢,这也是很多搜索与树结构算法努力缩小问题范围的原因。
不要把复杂度当成精确耗时
O(n) 并不表示处理 n 个元素一定执行恰好 n 条机器指令,O(1) 也不表示只执行一条指令。它描述的是规模变化后工作量的数量级趋势,而不是秒数或精确指令数。
因此,一个常数很大的 O(n) 算法在小数据上可能暂时比某个 O(n²) 算法慢。但随着 n 持续增加,增长更快的复杂度通常会逐渐成为主要问题。分析复杂度的价值,正是在运行程序之前预判这种扩展风险。
判断复杂度先找重复规模
阅读算法时,可以先观察最主要的重复工作。固定次数的操作通常是 O(1);一次遍历 n 个元素通常是 O(n);两个都遍历 n 次的嵌套循环经常形成 O(n²);若每轮都把问题规模减半,则常见 O(log n)。
大 O 的作用不是替代性能测试,而是在还没有具体机器和真实数据时先判断算法的增长趋势。数据规模较小时,多种方案可能差异不明显;当规模扩大后,增长阶数往往比某次测试中几毫秒的差距更值得关注。