
C / C++ / 系统课时
循环链表怎样判断遍历结束
循环链表怎样判断遍历结束
普通链表可以靠遇到 NULL 结束遍历,但循环链表的尾节点会重新指向头节点,因此永远不会自然走到空指针。本节用一个可运行的 C 示例说明如何识别“回到起点”,并避开死循环和漏访问尾节点这两个常见错误。
学习目标
- 理解循环链表为什么不能用
NULL作为正常遍历的结束条件 - 掌握从头节点出发并以“再次回到头节点”为结束条件的写法
- 能处理空链表、单节点循环链表以及多节点循环链表
循环结构改变了结束标志
普通单链表的最后一个节点通常满足 tail->next == NULL,所以指针不断后移后,最终会变成 NULL。循环链表则把尾节点的 next 指回头节点,形成一个闭环。
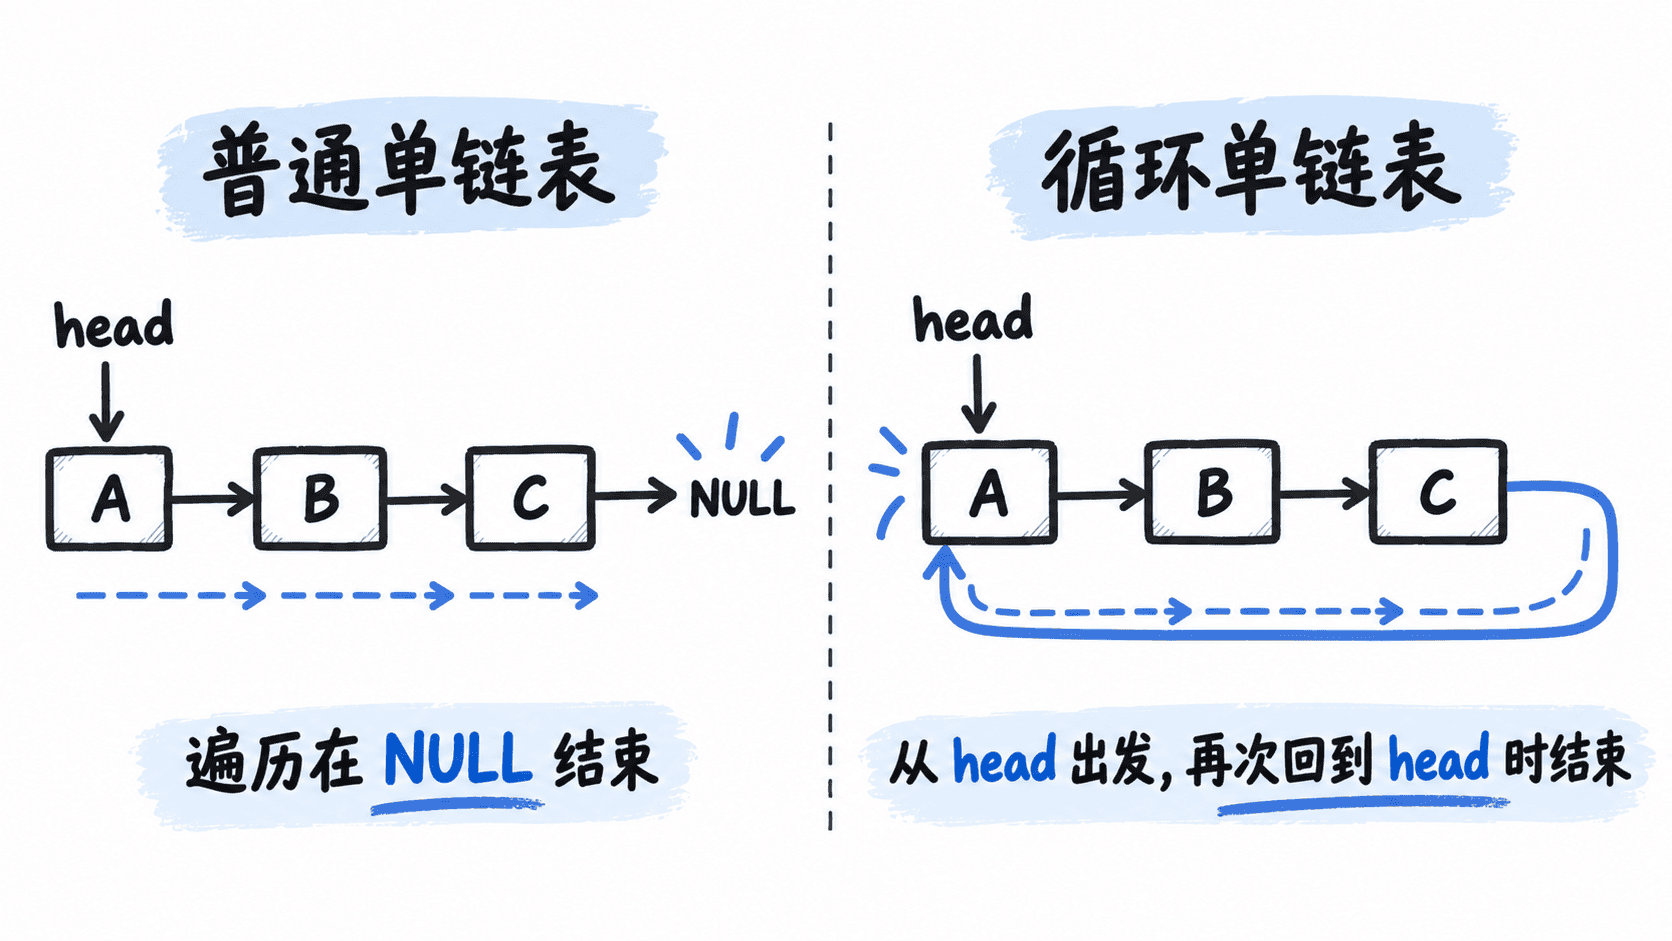
因此,如果仍然写 while (p != NULL),只要链表结构没有损坏,p 就会在这些节点之间不断循环,程序无法正常退出。循环链表需要把“访问了一整圈”作为结束依据,而不是等待空指针出现。
用回到头节点判断一整圈结束
最直接的策略是保存头指针 head。第一次访问 head 后不断执行 p = p->next,当 p 再次等于 head 时,说明所有节点已经访问一遍。
由于第一次检查条件时 p 本来就等于 head,这里很适合使用 do...while:先处理当前节点,再判断移动后的指针是否回到起点。
下面程序构造一个包含三个节点的循环链表,并完整遍历一圈:
#include <stdio.h>

typedef struct Node {
    int value;
    struct Node *next;
} Node;

void print_cycle(Node *head) {
    if (head == NULL) {
        return;
    }

    Node *p = head;
    do {
        printf("%d ", p->value);
        p = p->next;  // 每次访问后再向前移动
    } while (p != head);  // 再次回到起点时结束

    printf("\n");
}

int main(void) {
    Node n1 = {10, NULL};
    Node n2 = {20, NULL};
    Node n3 = {30, NULL};

    n1.next = &n2;
    n2.next = &n3;
    n3.next = &n1;

    print_cycle(&n1);
    return 0;
}
预期输出
10 20 30 这里的节点使用局部变量构造,因此示例不涉及动态内存释放,重点只放在循环遍历条件上。
空链表和单节点链表也要成立
do...while 不能直接对空指针解引用,所以遍历前必须先判断 head == NULL。如果链表为空,函数直接返回即可。
单节点循环链表则满足 head->next == head。第一次处理这个节点后,p = p->next 会立刻回到 head,循环恰好执行一次,因此同一套逻辑无需特殊分支。
两种容易出错的结束条件
把条件写成 p != NULL 会导致正常的循环链表永远无法结束,因为它本来就不存在作为终点的空指针。
另一种常见写法是从 head 开始,却用 p->next != head 控制循环。如果代码在条件成立后才处理 p,当 p 到达尾节点时条件已经为假,尾节点便可能被漏掉。相比之下,“先访问当前节点,再移动,移动后判断是否回到 head”的语义更直接,也更容易验证。
如果遍历不是从头节点开始,同样可以保存实际起点,例如 start = p,并在再次回到 start 时结束。核心原则始终相同:循环链表没有天然的 NULL 终点,遍历一圈必须依靠一个明确保存的起始节点来识别完成状态。