
C / C++ / 系统课时
哈希函数怎样定位数据位置
哈希函数怎样定位数据位置
哈希表查找的关键不是“遍历得更快”,而是先用哈希函数把关键字直接换算成数组下标,再访问对应位置。本节用整数关键字和 C 代码走完一次映射、写入与查找,并说明为什么理想情况下查找可接近 O(1)。
学习目标
- 理解“关键字 → 哈希值 → 桶下标 → 数组访问”的定位过程
- 能写出一个简单整数哈希函数,并用它完成写入和查找
- 能解释 O(1) 成立的前提,以及冲突会怎样影响查找
从关键字得到桶下标
设哈希表有 11 个桶,最简单的整数哈希函数可以取模:index = key % 11。关键字 12、25、38 会分别得到下标 1、3、5。数组下标一旦确定,就不需要从第 0 个元素开始逐个比较。
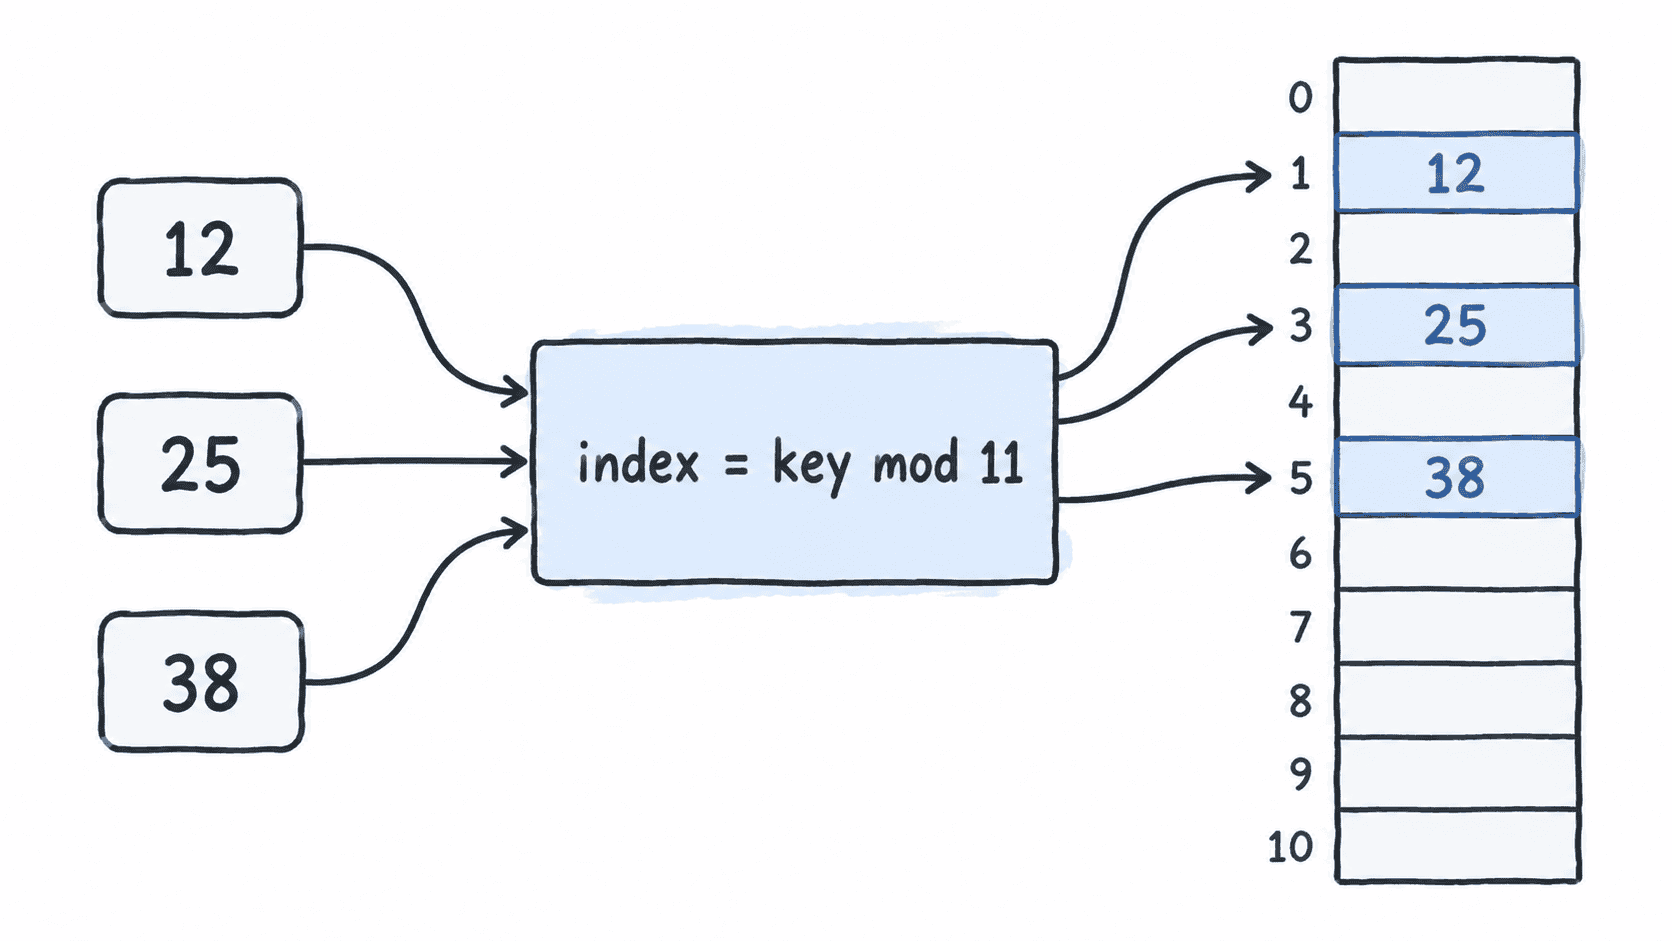
这里的“位置”不是关键字本身,而是哈希函数计算出的桶下标。只要插入和查找使用完全相同的哈希函数,同一个关键字就会先到达同一个桶。
用 C 验证一次定位
下面用一个极简哈希表保存三个没有发生冲突的键值对。示例通过 used 标记桶是否已经存放数据,并在查找时再次计算下标。
c
#include <stdio.h>
#include <stddef.h>

#define TABLE_SIZE 11

typedef struct {
    int used;
    int key;
    int value;
} Entry;

static size_t hash_int(int key) {
    int r = key % TABLE_SIZE;
    return (size_t)(r < 0 ? r + TABLE_SIZE : r);
}

static void put(Entry table[], int key, int value) {
    size_t index = hash_int(key);
    table[index].used = 1;
    table[index].key = key;
    table[index].value = value;
}

static int get(const Entry table[], int key, int *value) {
    size_t index = hash_int(key);

    if (table[index].used && table[index].key == key) {
        *value = table[index].value;
        return 1;
    }
    return 0;
}

int main(void) {
    Entry table[TABLE_SIZE] = {0};
    int keys[] = {12, 25, 38};

    for (size_t i = 0; i < sizeof(keys) / sizeof(keys[0]); ++i) {
        printf("key=%d -> index=%zu\n", keys[i], hash_int(keys[i]));
    }

    put(table, 12, 120);
    put(table, 25, 250);
    put(table, 38, 380);

    int value;
    if (get(table, 25, &value)) {
        printf("find key=25, value=%d\n", value);
    }

    return 0;
}
预期输出
text
key=12 -> index=1
key=25 -> index=3
key=38 -> index=5
find key=25, value=250
这个例子特意选择了不会互相冲突的关键字,因此每次 get 都只需计算一次哈希值,再检查一个数组位置。
为什么理想情况下接近 O(1)
对固定大小的整数关键字,取模和一次数组访问都可以视为常数时间,所以一次成功查找不需要随着表中元素数量增长而扫描更多位置。此时查找过程近似为“计算下标 + 访问桶”,因此常写作平均 O(1)。
但 O(1) 不是“哈希表永远只访问一次”。如果两个关键字得到同一下标,就发生哈希冲突;如果桶分布很不均匀,查找还需要在冲突结构中继续比较。实际性能取决于哈希函数质量、桶数量和装载因子。
使用哈希定位时要守住的边界
插入、查找和删除必须使用同一套哈希规则;修改桶数量后,旧元素通常也要重新计算位置。示例中的 put 没有处理冲突,所以它只适合解释“如何定位”,不能直接作为完整哈希表实现。
理解哈希表时,最重要的是把“查找”拆成两步:先由关键字计算桶位置,再在桶中确认目标。第一步负责快速缩小范围,冲突处理则决定第二步还要做多少工作。
按自己的节奏,确认真正理解。