
C / C++ / 系统课时
设计任务记录和数据结构
设计任务记录和数据结构
一个内存版任务管理器同时要支持按 ID 查找、删除任务,以及快速取得最高优先级任务。只选一种结构很难兼顾这些访问方式,本节从操作需求反推结构体、哈希表和最大堆的职责,并先把跨结构一致性设计清楚。
学习目标
- 把新增、查找、删除和最高优先级获取转换成明确的数据访问模式。
- 设计只保存一份任务实体、由哈希表和最大堆共同索引的内存结构。
- 识别删除和堆交换时必须同步维护的状态,避免悬空指针与索引失效。
从操作需求反推结构
任务至少需要稳定的唯一 ID、名称和优先级。按 ID 查找希望接近 O(1),适合哈希表;获取最高优先级希望是 O(1),删除最高优先级希望是 O(log n),适合最大堆。真正麻烦的是“按 ID 删除”:找到任务后,还必须快速知道它在堆中的位置。
因此可以让任务记录保存 heapIndex。哈希表负责从 ID 定位 Task *,最大堆保存同一个 Task *,而任务自身记录当前堆下标。这样按 ID 删除时无需线性扫描整个堆。
| 操作 | 主要结构 | 目标复杂度 |
|---|---|---|
| 新增任务 | 哈希表 + 最大堆 | 平均 O(1) + O(log n) |
| 按 ID 查找 | 哈希表 | 平均 O(1) |
| 获取最高优先级 | 最大堆堆顶 | O(1) |
| 按 ID 删除 | 哈希表定位 + 堆按下标删除 | 平均 O(1) + O(log n) |
让一条任务只保留一份实体
不要在哈希表和堆里各复制一份完整任务,否则名称、优先级或状态更新后容易出现两份数据不一致。更稳妥的做法是动态分配一个 Task,两个索引结构都只保存它的指针;真正的任务内容只有一份。
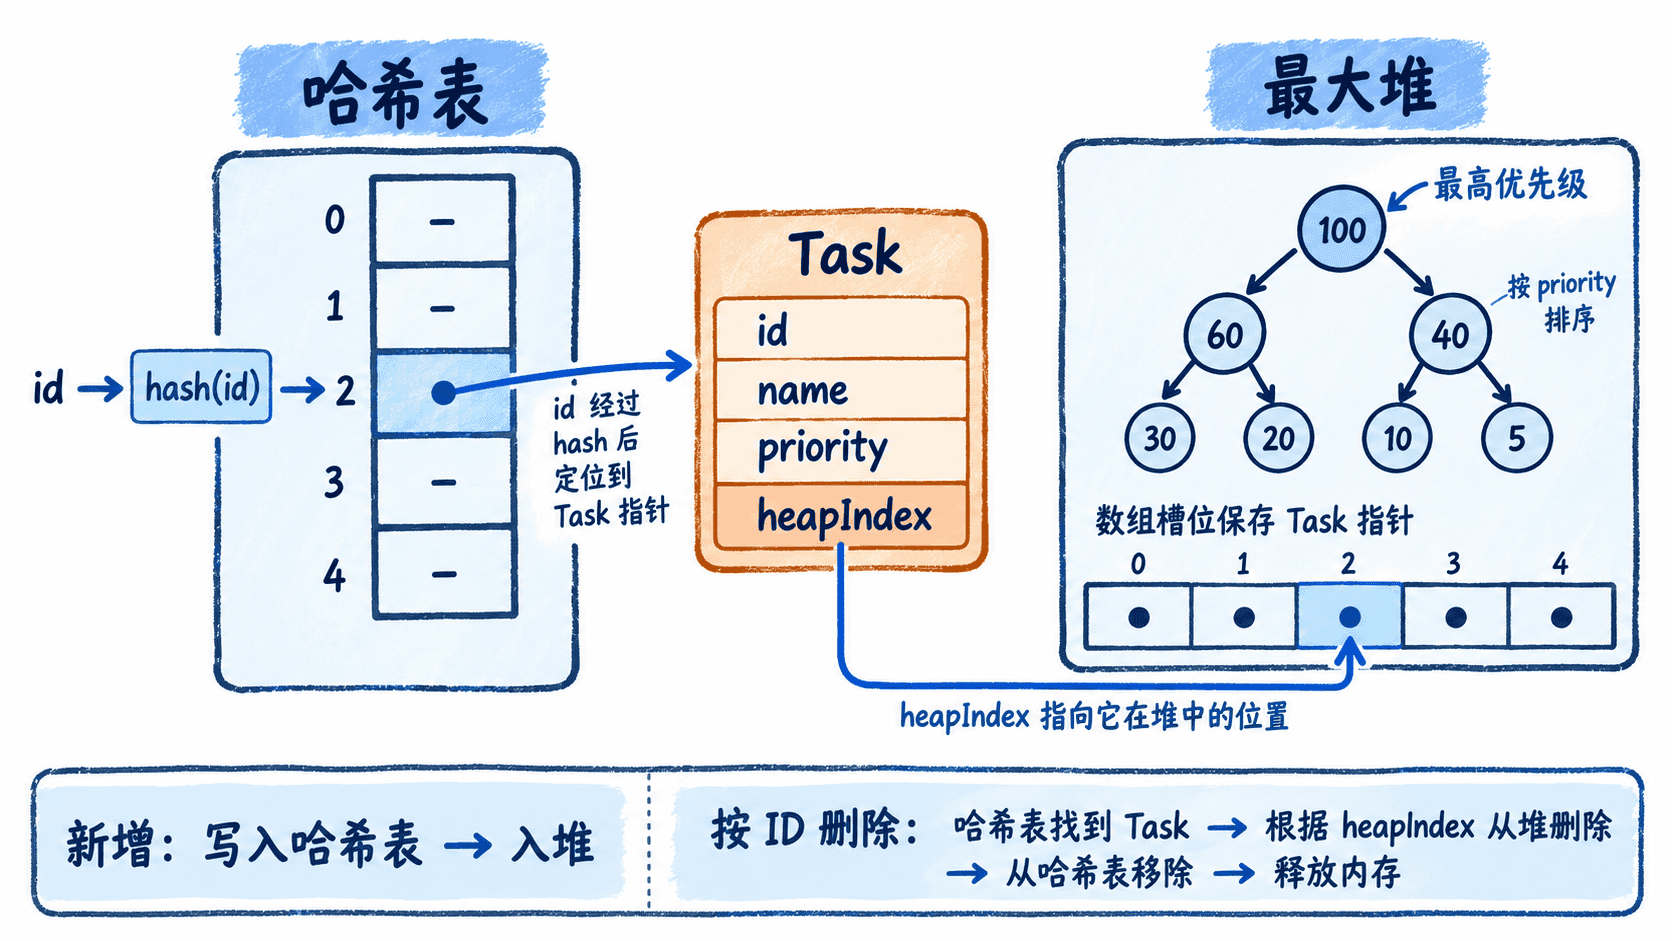
这套设计还明确了所有权:TaskStore 负责创建和释放任务;哈希表与堆只是索引,不拥有独立副本。删除时必须先让两个索引都不再引用该任务,最后才能 free。
定义任务和容器骨架
下面是片段示例,只定义后续实现会依赖的数据结构和接口,不包含哈希插入、堆上浮等函数体。假设哈希冲突采用拉链法,最大堆内部保存 Task *。
#include <stdbool.h>
#include <stddef.h>

#define TASK_NAME_LEN 64
#define HASH_BUCKETS 127
#define MAX_TASKS 128

typedef struct Task {
    int id;
    char name[TASK_NAME_LEN];
    int priority;
    unsigned long long sequence;
    size_t heapIndex;
    struct Task *nextHash;
} Task;

typedef struct {
    Task *buckets[HASH_BUCKETS];
    Task *heap[MAX_TASKS];
    size_t heapSize;
    unsigned long long nextSequence;
} TaskStore;

bool task_store_add(TaskStore *store, int id, const char *name, int priority);
Task *task_store_find(TaskStore *store, int id);
bool task_store_remove(TaskStore *store, int id);
const Task *task_store_peek_highest(const TaskStore *store);
这段定义本身不产生控制台输出。验证它是否设计合理,应检查后续实现能否始终满足三条不变量:同一 ID 只有一个任务对象;堆中每个指针都能在哈希表中找到;每次堆元素交换后,对应任务的 heapIndex 都立即更新。
sequence 用于处理相同优先级:比较时先看 priority,相同再让更早的 sequence 优先。若业务不要求同优先级保持先来先服务,可以删除该字段并简化比较规则。
一致性是设计核心
新增任务时,先检查 ID 是否已存在,再创建任务并依次加入哈希表和堆;任何一步失败,都要撤销已经完成的修改,避免只进入一个索引。按 ID 删除时,应先通过哈希表拿到 Task * 和 heapIndex,从堆移除并修复堆,再从哈希链中摘除,最后释放任务。
堆在上浮、下沉或“用末尾元素覆盖被删位置”时都会交换指针。每发生一次交换,两个任务的 heapIndex 都必须同步改写,否则下一次按 ID 删除可能访问错误位置,严重时会造成越界或释放错误对象。
用复杂度检查选择
哈希表与最大堆组合的代价是维护两套索引,但它直接对应任务管理器的主要访问模式:按 ID 的操作交给哈希表,按优先级的操作交给堆。只用链表会让查找和最高优先级获取都退化为 O(n);只用堆则无法高效按任意 ID 定位任务。
这个设计适合内存规模可控、单进程管理的练习项目。后续真正实现新增和删除时,重点不是再选择新结构,而是把“哈希表、堆、heapIndex、内存释放”作为一次原子更新来维护。