
C / C++ / 系统课时
快速排序怎样划分数组
快速排序怎样划分数组
快速排序的核心不是递归本身,而是一次分区怎样围绕基准值重排数组。本节采用容易实现的 Lomuto 分区法:把末尾元素作为基准,将不大于基准的元素移到左侧,再让基准落到最终位置,并继续递归处理两边。
学习目标
- 理解分区函数如何确定基准值的最终位置
- 能用 C 语言实现快速排序及其递归边界
- 能解释基准选择为什么会影响递归深度和性能
分区到底做了什么
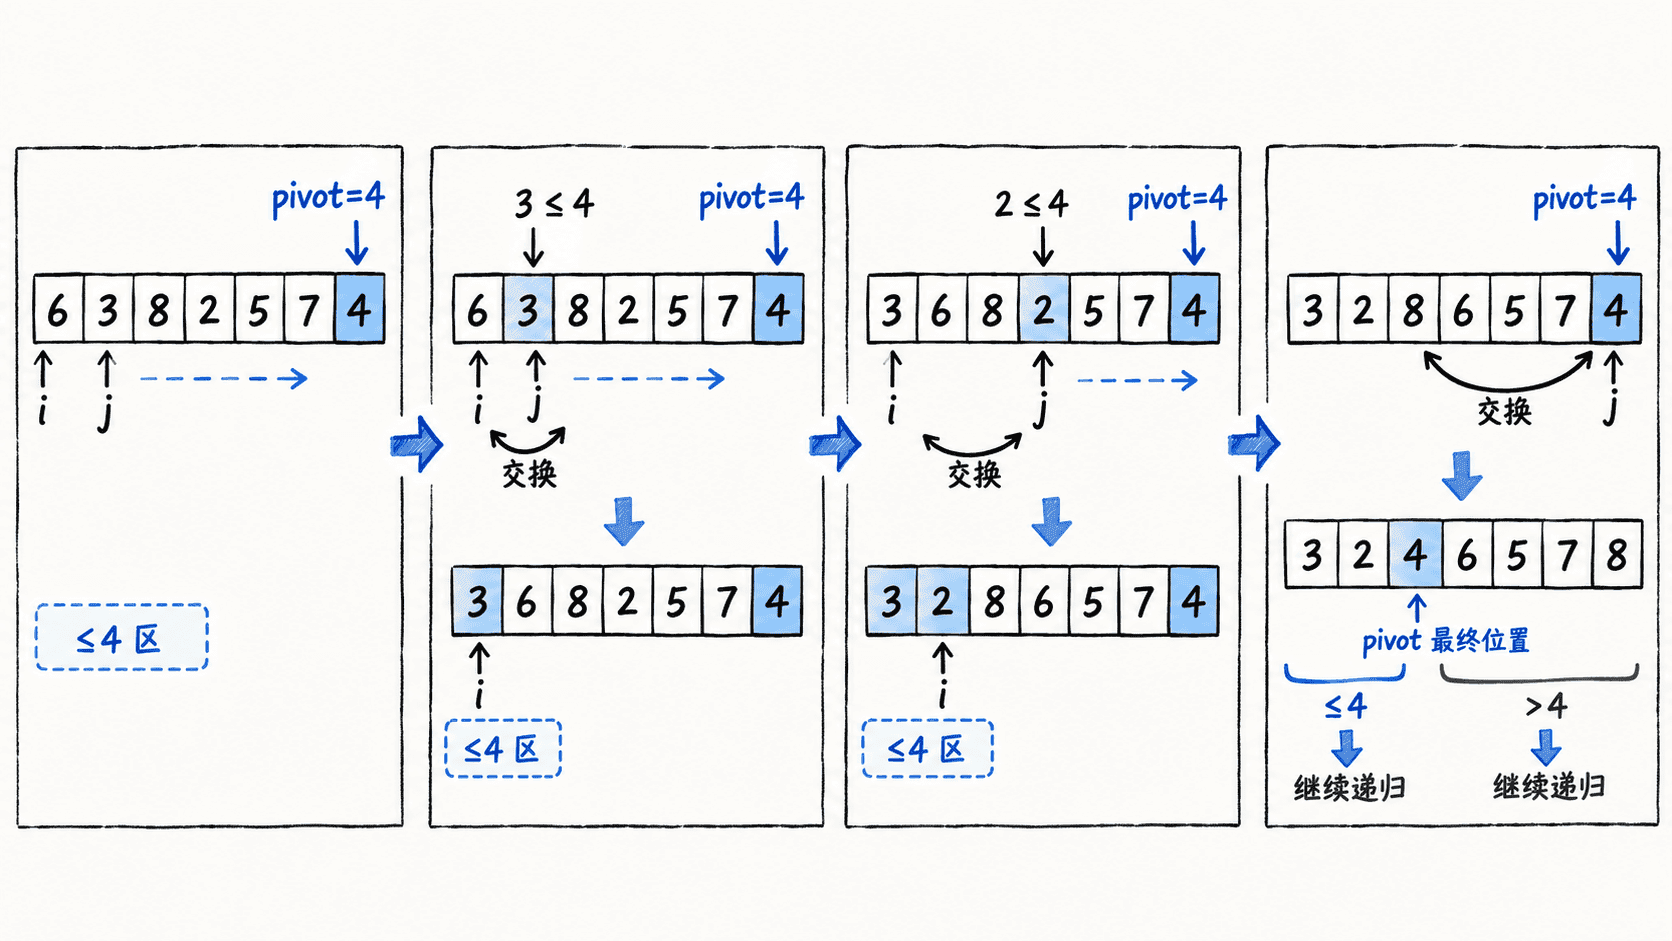
设当前区间为 left..right,并选择 a[right] 作为基准值 pivot。变量 i 表示“已确认不大于基准值区域”的末尾位置,j 从左到右扫描待处理元素。
当 a[j] <= pivot 时,先扩展左侧区域,再交换 a[i] 与 a[j]。扫描结束后,把基准值交换到 i + 1。此时基准左侧元素都不大于它,右侧元素都大于它,基准所在下标已经是最终排序位置。
完整实现
下面程序使用数组最后一个元素作为基准。分区函数返回基准最终下标,快速排序只递归处理基准两边,不再包含基准本身。
#include <stdio.h>

void swap(int *x, int *y) {
    int temp = *x;
    *x = *y;
    *y = temp;
}

int partition(int a[], int left, int right) {
    int pivot = a[right];
    int i = left - 1;

    for (int j = left; j < right; ++j) {
        if (a[j] <= pivot) {
            ++i;
            swap(&a[i], &a[j]);
        }
    }

    swap(&a[i + 1], &a[right]);
    return i + 1;
}

void quick_sort(int a[], int left, int right) {
    if (left >= right) {
        return;
    }

    int pivot_index = partition(a, left, right);
    quick_sort(a, left, pivot_index - 1);
    quick_sort(a, pivot_index + 1, right);
}

int main(void) {
    int a[] = {6, 3, 8, 2, 5, 7, 4};
    int n = (int)(sizeof(a) / sizeof(a[0]));

    quick_sort(a, 0, n - 1);

    for (int i = 0; i < n; ++i) {
        printf("%d%s", a[i], i == n - 1 ? "\n" : " ");
    }

    return 0;
}
预期输出
2 3 4 5 6 7 8基准选择为什么重要
如果每次分区都接近均匀,例如基准把区间分成规模大致相近的两部分,递归深度约为 log n,每层分区总处理量约为 n,平均时间复杂度为 O(n log n)。
如果输入已经有序,而实现始终选最后一个元素作为基准,基准会反复落在区间一端,递归规模变成 n-1、n-2、n-3。这种极端情况下时间复杂度退化为 O(n^2),递归栈也可能达到 O(n)。
实际工程中常通过随机选择基准、三数取中,或直接使用成熟标准库排序实现来降低持续出现坏分区的概率。教学实现选择末尾元素,是为了把分区逻辑看清,而不是因为它在所有数据上都更快。
检查递归边界
分区完成后,基准已经位于最终位置,所以左侧应递归 left..pivot_index-1,右侧应递归 pivot_index+1..right。若再次把 pivot_index 包含进去,可能造成重复处理,边界写错时甚至出现无法收敛的递归。
快速排序的额外空间主要来自递归栈。平均分区较均衡时约为 O(log n);最坏情况下可增长到 O(n)。因此,判断快速排序性能不能只看“比较次数少不少”,还要同时观察分区是否长期失衡。