
C / C++ / 系统课时
分治算法怎样拆分问题
分治算法怎样拆分问题
分治不是“多写几次递归”,而是把一个规模较大的问题切成若干彼此独立、结构相同的子问题,分别求解后再合并结果。本节用数组求和展示完整过程,重点看清拆分边界、递归终止条件和合并结果之间的关系。
学习目标
- 说清分治算法“拆分、求解、合并”的基本模式
- 能为数组问题设计子问题边界与递归终止条件
- 能分析分治递归的执行过程和时间复杂度
分治真正拆的是什么
分治法的关键不是把代码分成几段,而是把原问题的输入规模缩小。假设要计算数组区间 data[left..right] 的元素总和,可以在中点 mid 处分成左右两个区间:data[left..mid] 与 data[mid+1..right]。
只要两个子区间互不重叠、合起来又覆盖原区间,就可以分别计算它们的和,最后把两个结果相加。子问题与原问题具有相同形式,因此可以重复使用同一个函数。
用区间边界建立递归
下面用 C 语言实现分治求和。递归函数每次处理一个闭区间 [left, right];当区间中只剩一个元素时,不再继续拆分,直接返回该元素,这就是终止条件。
#include <stdio.h>

int divide_sum(const int data[], int left, int right) {
    if (left == right) {
        return data[left];
    }

    // 用中点把当前区间拆成两个不重叠子区间。
    int mid = left + (right - left) / 2;
    int left_sum = divide_sum(data, left, mid);
    int right_sum = divide_sum(data, mid + 1, right);

    // 当前问题的答案由两个子问题结果合并得到。
    return left_sum + right_sum;
}

int main(void) {
    int data[] = {2, 4, 6, 8, 10, 12, 14, 16};
    int n = (int)(sizeof(data) / sizeof(data[0]));

    int total = divide_sum(data, 0, n - 1);
    printf("sum = %d\n", total);
    return 0;
}
预期输出
sum = 72如果数组为空,就不能直接调用 divide_sum(data, 0, -1),因为这个实现假设传入的区间至少包含一个元素。实际程序应在外层先判断 n > 0,再进入递归。
执行过程为什么不是一直向下
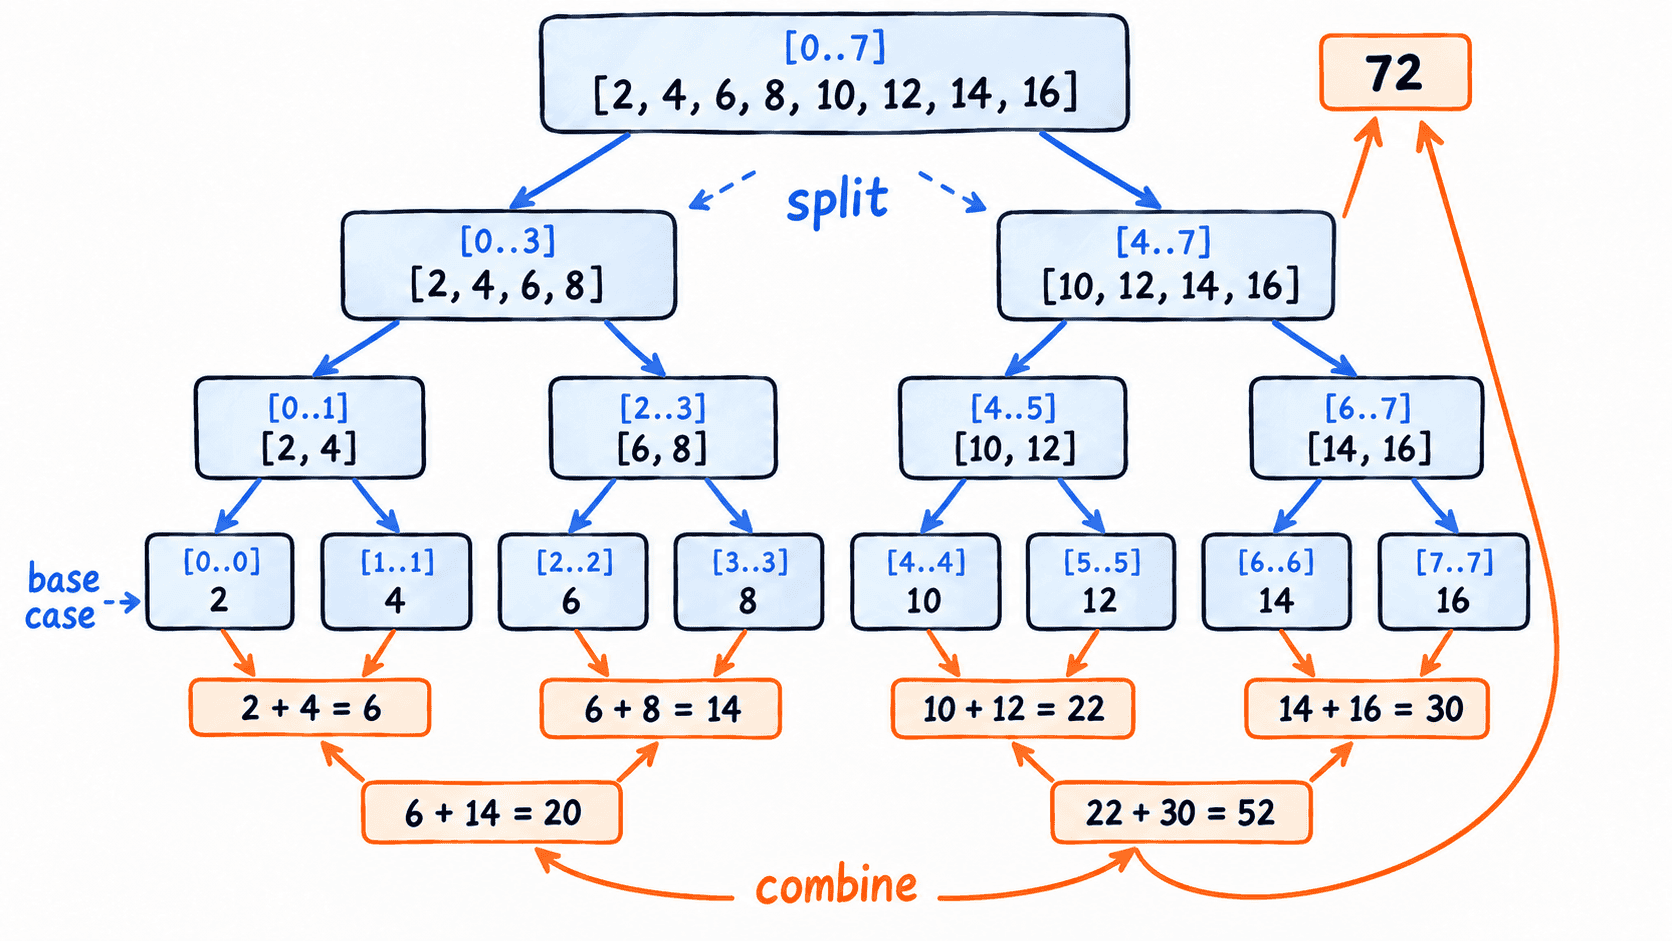
以 8 个元素为例,第一次调用处理 [0,7],拆成 [0,3] 和 [4,7]。左侧继续拆成 [0,1]、[2,3],直到出现 [0,0] 这样的单元素区间。到达终止条件后,递归开始返回,结果才逐层向上合并。
因此一次分治递归同时包含两种方向:调用阶段不断缩小问题,返回阶段不断合并答案。只看“函数调用自己”会忽略一半过程;真正决定算法正确性的,是每层拆分都能覆盖原问题,并且合并操作能还原当前层答案。
怎样判断拆分是否正确
设计分治算法时,可以依次检查三个条件:
- 子问题规模必须变小。 否则递归可能永远无法到达终止条件。
- 子问题要覆盖原问题。 本例中
[left, mid]与[mid+1, right]合起来必须恰好等于[left, right]。 - 合并规则必须正确。 求和用加法;如果处理的是最大值,则应合并两个子区间的最大值;不同问题的合并操作并不相同。
分治的代价
数组求和本身必须访问每个元素一次,因此总工作量仍是 。分治并没有让这个问题比简单循环更快;它的价值在于展示一种可复用的拆解方式,并为归并排序、快速排序、二分相关算法等建立执行模型。
对当前实现而言,递归树高度约为 ,每个元素最终都会成为一个叶子节点,所有层合计完成线性数量的工作。选择分治时,不应只问“能不能递归”,还要看子问题是否独立、合并是否清晰,以及递归开销是否值得。