
C / C++ / 系统课时
冒泡排序为什么不断交换
冒泡排序为什么不断交换
冒泡排序最直观的现象是不断比较相邻元素并交换逆序对。真正需要理解的是:每一轮结束后,当前未排序区间里的最大值一定被推到最右侧,因此下一轮可以少比较一个元素;这些重复比较也正是 的来源。
学习目标
- 通过完整程序观察每一轮比较后的数组变化。
- 理解相邻交换为什么能逐步确定右侧有序区。
- 从比较次数推导最坏时间复杂度,并识别提前结束条件。
一轮交换到底做了什么
假设数组是 5 1 4 2 3。第一轮从左向右比较相邻元素,只要左边更大就交换。5 会先后越过 1、4、2 和 3,最终移动到最右端。虽然中间发生多次交换,但这一轮真正保证的是:未排序区间的最大值已经到达最右端。
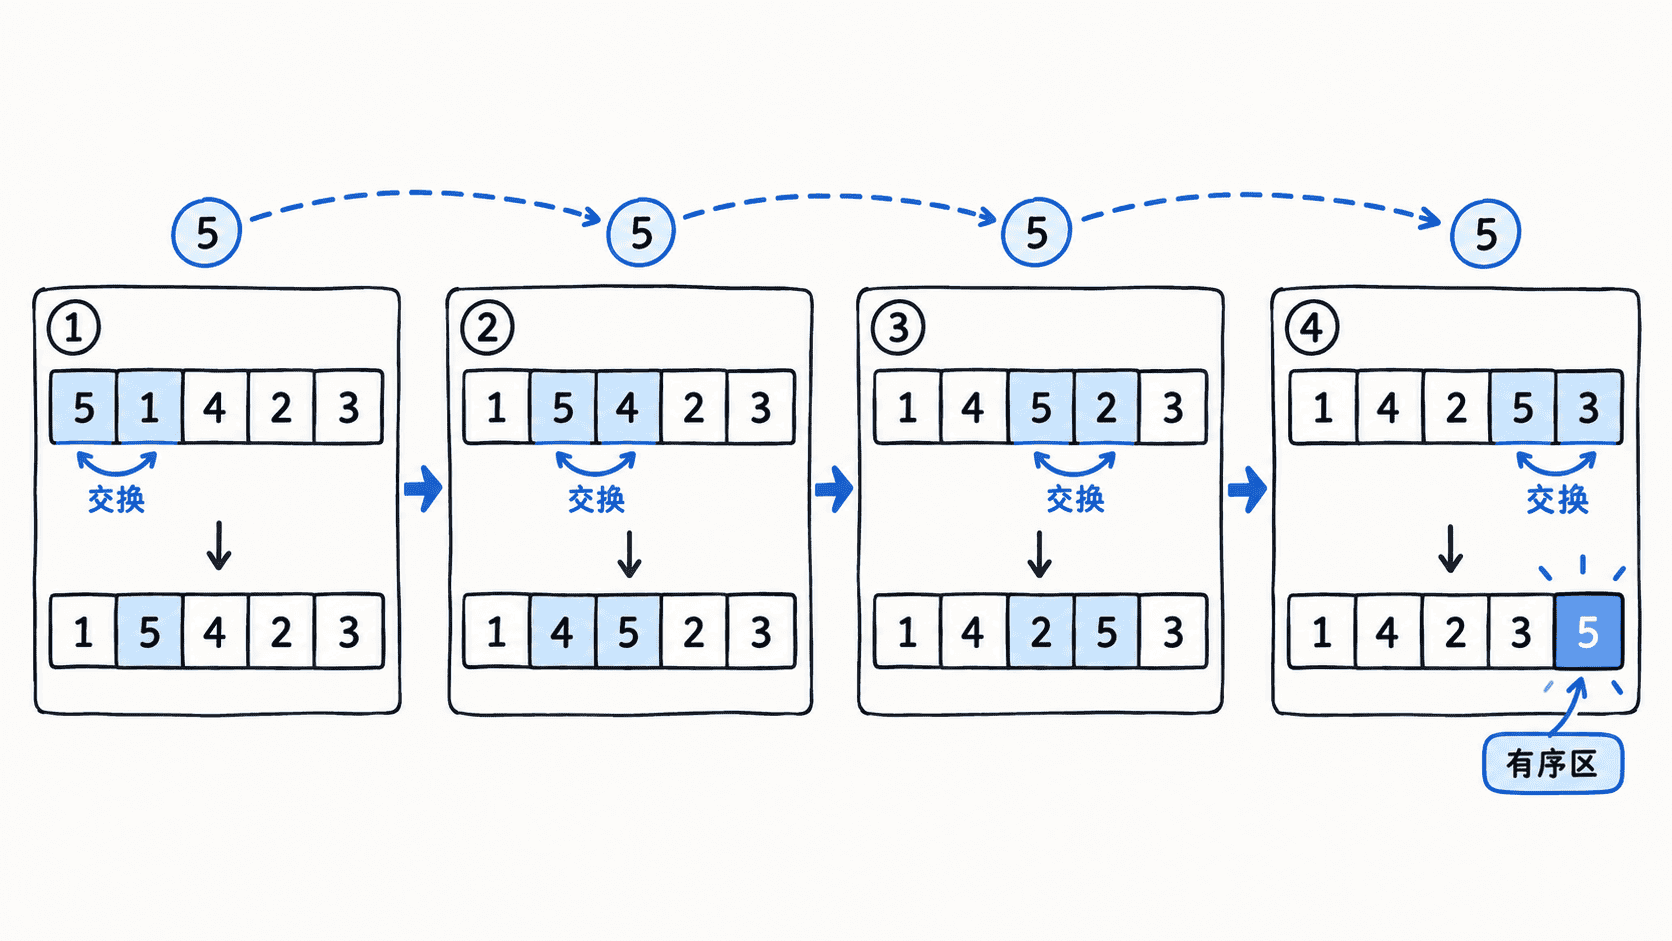
因此,第 pass 轮只需要比较到 n - 1 - pass。右侧已经确定的元素不必再参与比较,这也是标准实现里内层循环逐轮缩短的原因。
用程序观察每一轮
下面的程序记录每轮交换次数。若某一轮一次交换都没有发生,说明当前数组已经有序,可以直接结束。
c
#include <stdio.h>

static void print_array(const int a[], int n) {
    for (int i = 0; i < n; ++i) {
        printf("%d%s", a[i], i == n - 1 ? "\n" : " ");
    }
}

static void bubble_sort(int a[], int n) {
    for (int pass = 0; pass < n - 1; ++pass) {
        int swaps = 0;

        for (int i = 0; i < n - 1 - pass; ++i) {
            if (a[i] > a[i + 1]) {
                int temp = a[i];
                a[i] = a[i + 1];
                a[i + 1] = temp;
                ++swaps;
            }
        }

        printf("pass %d, swaps=%d: ", pass + 1, swaps);
        print_array(a, n);

        if (swaps == 0) {
            break;
        }
    }
}

int main(void) {
    int a[] = {5, 1, 4, 2, 3};
    int n = (int)(sizeof(a) / sizeof(a[0]));

    printf("before: ");
    print_array(a, n);

    bubble_sort(a, n);

    printf("after:  ");
    print_array(a, n);
    return 0;
}
预期输出
text
before: 5 1 4 2 3
pass 1, swaps=4: 1 4 2 3 5
pass 2, swaps=2: 1 2 3 4 5
pass 3, swaps=0: 1 2 3 4 5
after:  1 2 3 4 5
第三轮没有交换,因此程序提前停止。这个判断不会改变最终结果,只是避免已经有序时继续做无意义比较。
为什么复杂度是 O(n²)
最坏情况下,例如数组完全逆序,第一轮最多比较 n - 1 次,第二轮比较 n - 2 次,直到最后只比较 1 次。总比较次数是
最高次项与 成正比,所以最坏时间复杂度是 。空间上只使用一个临时变量交换元素,因此额外空间复杂度是 。
加入“本轮无交换则退出”后,已经有序的数组只需扫描一轮,最好时间复杂度可达到 。但这不会改变最坏情况下仍为 的事实。
相邻交换还有两个重要性质
冒泡排序只在 a[i] > a[i + 1] 时交换,因此相等元素不会互换先后顺序,这使它天然具有稳定性。如果把条件误写成 >=,相等元素也可能被交换,稳定性就会被破坏。
冒泡排序实现简单、过程容易观察,适合教学和处理很小的数据集;当数据规模增大时,平方级比较会迅速变慢。理解它的价值主要在于建立“局部比较如何逐步形成有序区”以及“循环次数如何决定复杂度”的直觉。
按自己的节奏,确认真正理解。