
C / C++ / 系统课时
双向链表为什么多一个指针
双向链表为什么多一个指针
单链表节点只保存后继地址,因此天然适合向后走;如果已经拿到某个节点,却想直接找到它的前驱,就必须额外从链表前面查找。双向链表在每个节点中增加 prev,用额外指针空间换取反向遍历和更直接的节点摘除操作。
学习目标
- 理解
prev与next分别保存什么关系 - 能说明双向链表为何可以从两个方向遍历
- 理解已知节点位置时删除操作为什么更直接
一个节点同时记住前后邻居
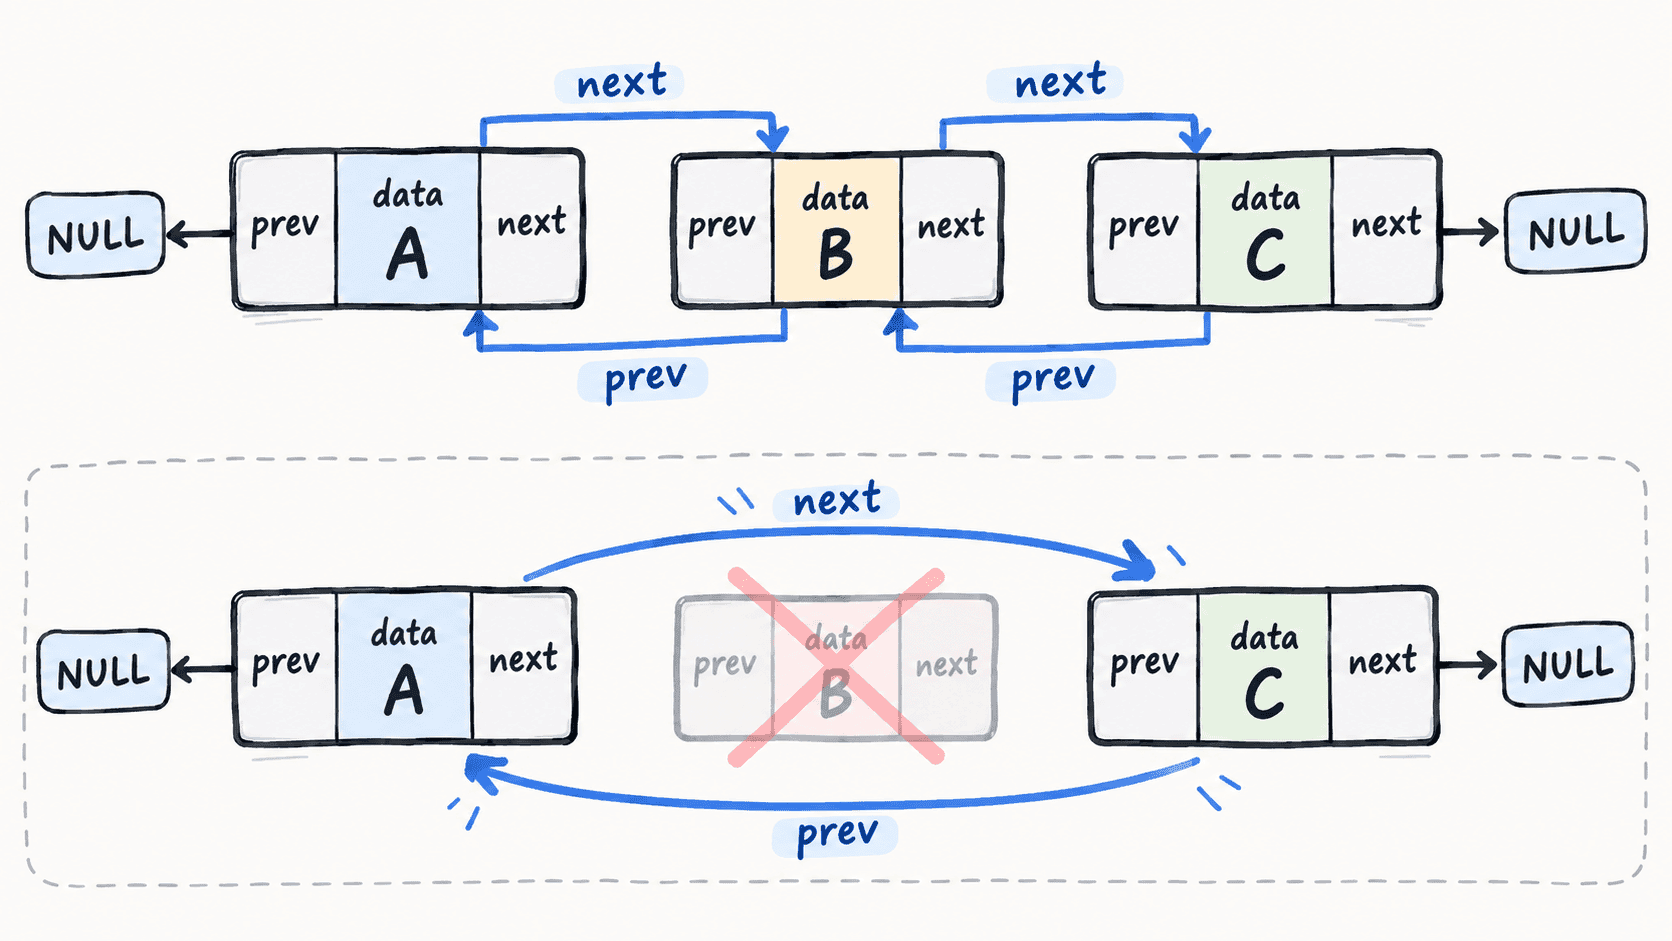
双向链表节点通常同时保存数据、前驱指针 prev 和后继指针 next。对于中间节点 B,如果 A 在它前面、C 在它后面,那么应同时满足 B.prev == &A、B.next == &C、A.next == &B 和 C.prev == &B。
首节点没有前驱,所以它的 prev 为 NULL;尾节点没有后继,所以它的 next 为 NULL。这两个空指针分别标记链表的两个边界。
多一个指针换来了什么
最直接的收益是可以双向遍历。只要保存尾节点地址,就能沿 prev 从尾部一路走回头部,而不需要每次重新从头查找前一个节点。
另一个重要收益出现在删除操作中。如果已经拿到待删除节点的指针,节点自身就能告诉程序它的前驱和后继。对于一个非首尾节点,只需让前驱的 next 越过它,再让后继的 prev 越过它,就可以把该节点从链表中摘除。
代价也很明确:每个节点要多保存一个指针,并且插入、删除时必须维护两个方向的连接。如果只更新 next 而忘记更新 prev,链表可能正向遍历正常,反向遍历却已经损坏。
用代码观察双向遍历和摘除
下面的程序使用三个节点演示正向遍历、反向遍历,以及已知中间节点地址时的摘除操作。节点放在 main 的栈帧中,因此示例只演示链接关系,不涉及动态内存释放。
#include <stdio.h>

typedef struct Node {
    int value;
    struct Node *prev;
    struct Node *next;
} Node;

void print_forward(const Node *head) {
    for (const Node *p = head; p != NULL; p = p->next) {
        printf("%d ", p->value);
    }
    putchar('\n');
}

void print_backward(const Node *tail) {
    for (const Node *p = tail; p != NULL; p = p->prev) {
        printf("%d ", p->value);
    }
    putchar('\n');
}

int main(void) {
    Node a = {10, NULL, NULL};
    Node b = {20, NULL, NULL};
    Node c = {30, NULL, NULL};

    a.next = &b;
    b.prev = &a;
    b.next = &c;
    c.prev = &b;

    printf("forward: ");
    print_forward(&a);

    printf("backward: ");
    print_backward(&c);

    /* 已知 b 的地址时,可直接通过它找到左右邻居。 */
    b.prev->next = b.next;
    b.next->prev = b.prev;
    b.prev = NULL;
    b.next = NULL;

    printf("after unlink 20: ");
    print_forward(&a);

    return 0;
}
预期输出
forward: 10 20 30
backward: 30 20 10
after unlink 20: 10 30
这里摘除 B 时没有寻找它的前驱,因为 b.prev 已经直接保存了 A 的地址。若节点由 malloc 创建,完成这些链接调整后还需要对被删除节点调用 free。
什么时候值得付出额外空间
当程序需要频繁向前移动、维护首尾两端,或经常在已经获得节点地址的情况下执行删除时,双向链表通常比单链表更方便。相反,如果数据规模很大、每个节点都很小,而且操作始终只从头向后进行,那么额外的 prev 指针会带来实际内存成本,此时单链表可能更合适。