
C / C++ / 系统课时
数组为什么能随机访问
数组为什么能随机访问
数组能在已知下标时直接定位元素,而不必从头逐个查找。关键不在于下标本身,而在于数组元素连续存放且大小固定,因此程序可以由首地址、元素大小和下标一次算出目标位置。
学习目标
- 理解数组连续存储与随机访问之间的关系
- 掌握数组元素地址的计算规则
- 区分按下标访问的 O(1) 与按值查找的 O(n)
随机访问依赖连续存储
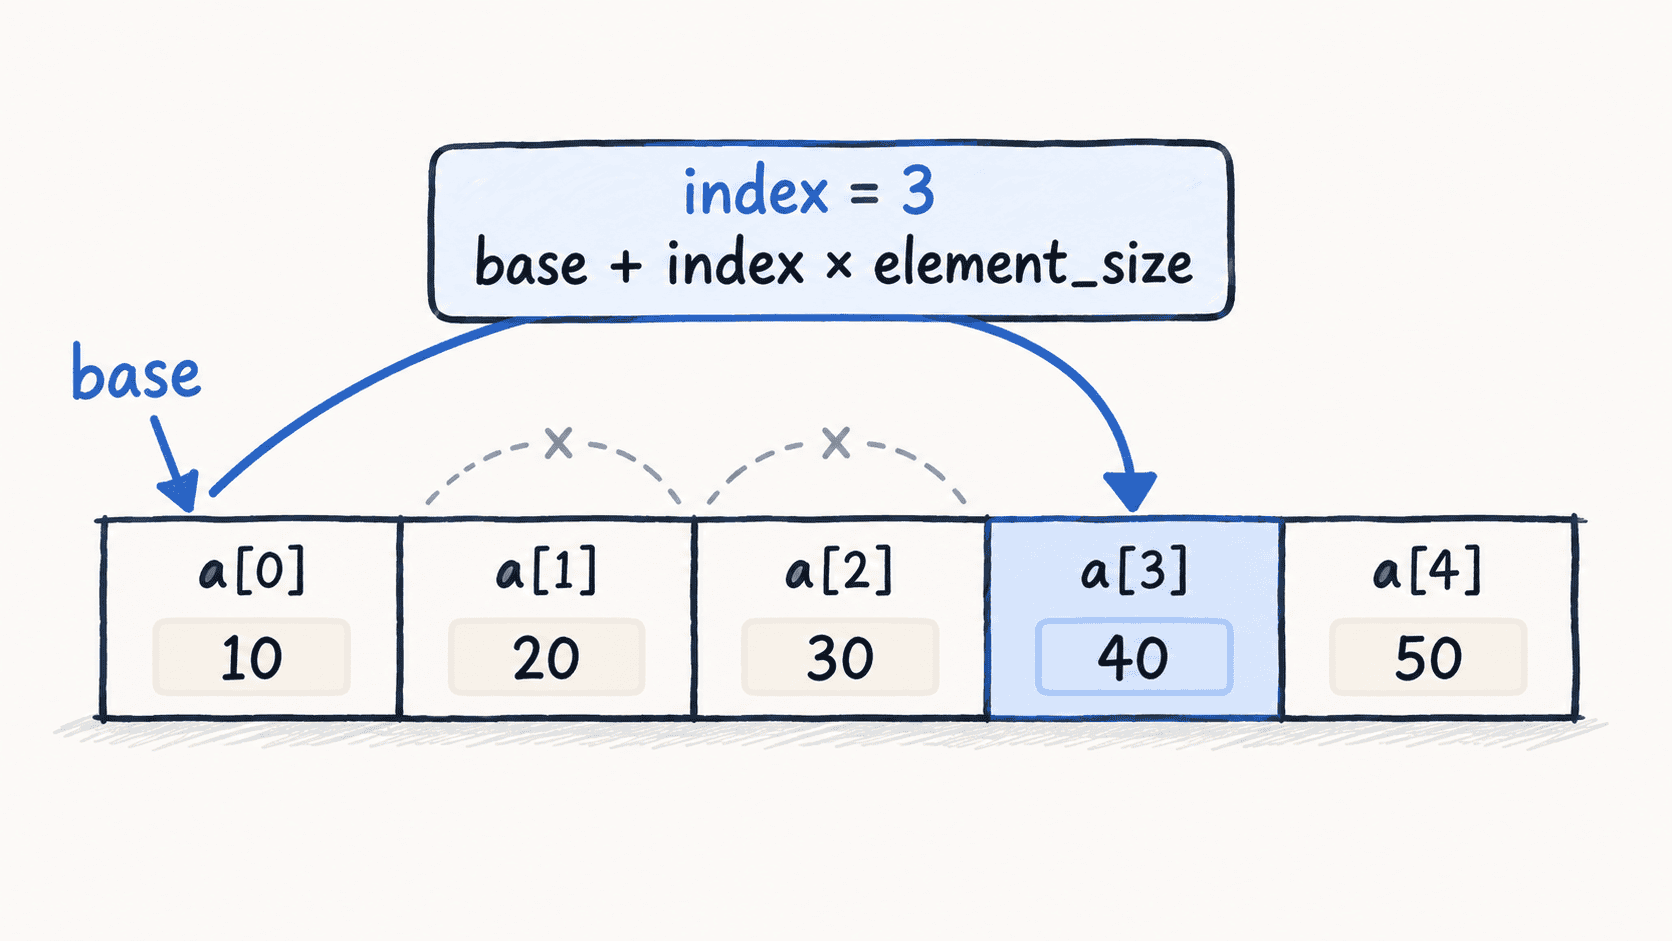
假设数组 a 的首元素地址已经确定,并且每个元素占用相同的字节数。访问 a[index] 时,不需要先读取 a[0]、a[1] 再前进到目标,而是可以直接计算目标元素的位置。
概念上的地址计算可以写成 base + index * element_size。在 C 语言中,指针算术已经自动考虑元素大小,因此 a + index 就表示向后移动 index 个数组元素,而不是简单增加 index 个字节。
用 C 指针验证定位关系
下面的程序分别使用数组下标和指针算术定位第 4 个元素,并比较两者得到的地址。
#include <stddef.h>
#include <stdio.h>

int main(void) {
    int a[] = {10, 20, 30, 40, 50};
    size_t index = 3;

    /* 指针加 index 时,会按 int 的大小自动缩放。 */
    int *target = a + index;

    printf("same address: %s\n", target == &a[index] ? "yes" : "no");
    printf("value: %d\n", *target);
    return 0;
}
预期输出
same address: yes
value: 40
a + 3 与 &a[3] 指向同一个元素,这正是数组下标访问能够直接定位的基础。表达式 a[index] 在语义上等价于 *(a + index)。
为什么复杂度是 O(1)
无论目标是 a[1] 还是 a[100000],只要下标合法,定位过程执行的地址计算步骤数量不会随着数组长度增长,因此按下标访问记为 O(1)。这里的常数时间描述的是算法步骤规模,而不是承诺所有硬件访问都具有完全相同的实际耗时。
需要注意,随机访问不等于快速查值。如果问题是“值 40 在哪个下标”,而数组没有额外索引或排序条件,通常仍要从前向后比较,最坏需要检查全部元素,因此是 O(n)。
下标必须落在数组范围内
C 语言不会自动检查数组边界。对于长度为 5 的数组,合法下标只有 0 到 4;读取 a[5] 或负下标对应的位置都会越界,并产生未定义行为。
因此,数组能 O(1) 随机访问的前提可以概括为:元素连续存放、元素大小固定、下标已知且合法。改变其中任何一个条件,都不能直接套用数组的地址计算方式。