
C / C++ / 系统课时
二叉搜索树怎样快速查找
二叉搜索树怎样快速查找
二叉搜索树把“比较大小”变成了“选择左子树还是右子树”。每访问一个节点,都能依据目标值与当前值的关系排除另一侧子树,因此查找只沿一条路径向下,而不必像普通二叉树那样遍历所有节点。
学习目标
- 理解二叉搜索树查找时如何利用左小右大的约束缩小范围。
- 用 C 语言实现迭代式查找并正确处理未找到的情况。
- 区分平衡树与退化树对查找复杂度的影响。
查找为什么只需要走一条路径
对不包含重复键的二叉搜索树,任一节点都满足:左子树中的键小于当前键,右子树中的键大于当前键。查找目标值时,如果目标更小,只可能出现在左子树;如果更大,只可能出现在右子树。
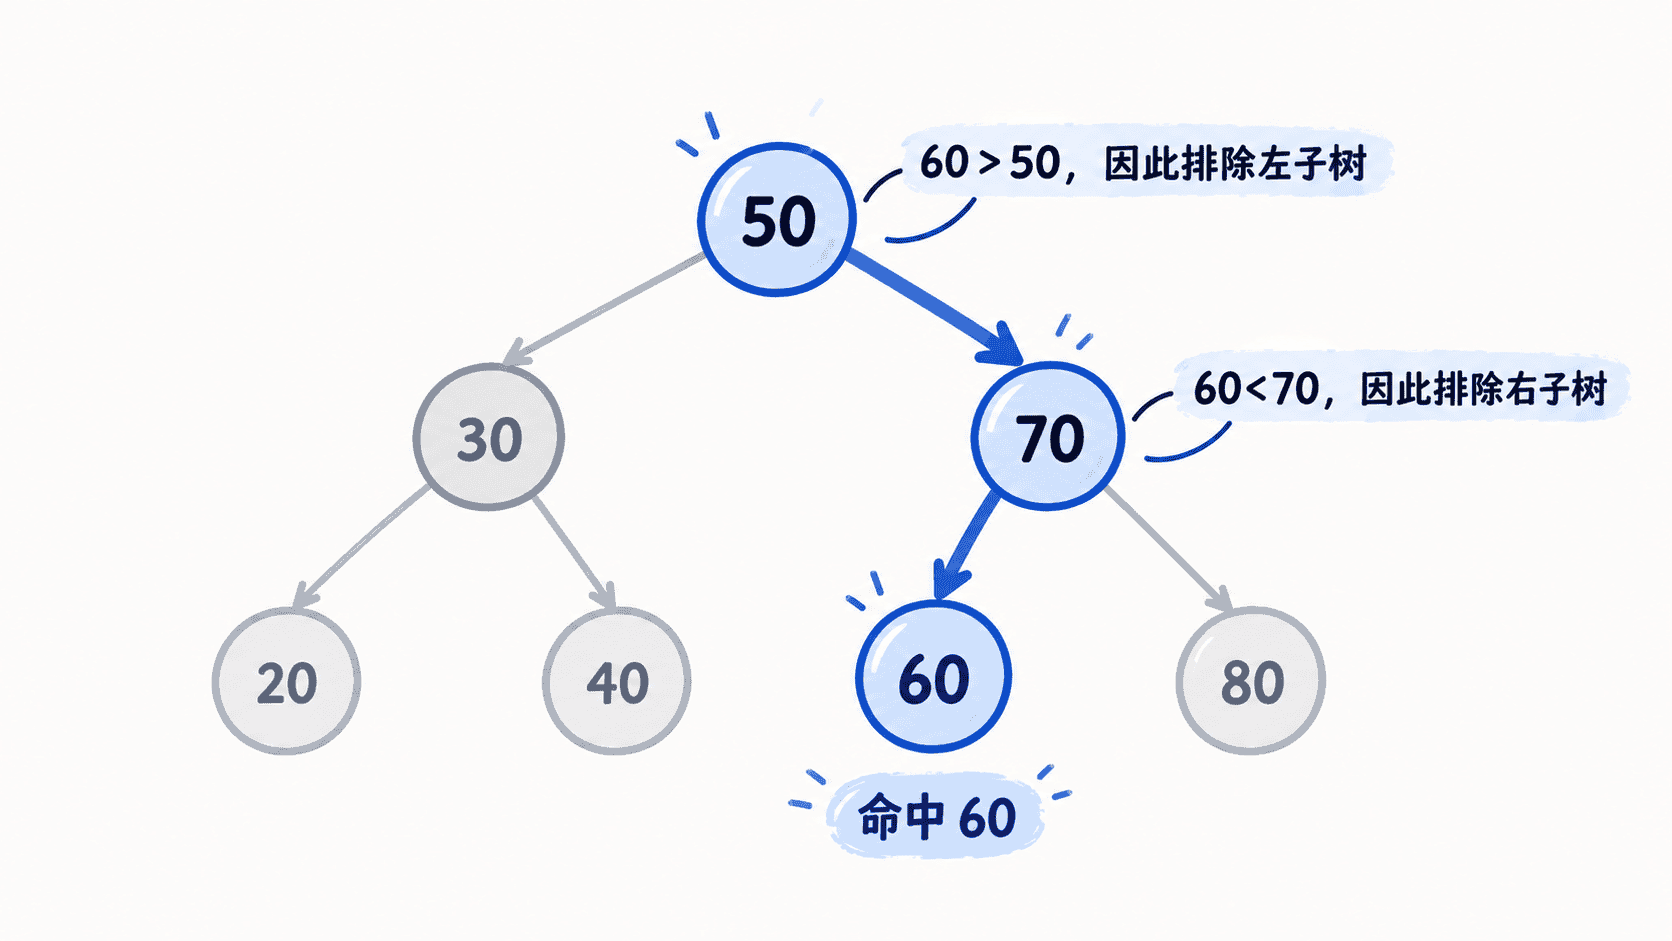
例如查找 60,从 50 开始,因为 60 > 50 转向右子树;到达 70 后,因为 60 < 70 转向左子树;随后命中 60。每次比较都排除一整棵不可能包含目标值的子树。
迭代式查找规则
查找循环只有三种情况:
target == node->value,立即返回当前节点。target < node->value,移动到左孩子。target > node->value,移动到右孩子。
如果指针最终变成 NULL,说明沿着唯一可能的搜索路径仍未命中,目标值不在树中。这种写法不依赖递归栈,控制流程也很直接。
完整实现
下面构造一棵固定的二叉搜索树,并分别查找存在的 60 与不存在的 25。示例假设所有键互不重复。
#include <stdio.h>

typedef struct TreeNode {
    int value;
    struct TreeNode *left;
    struct TreeNode *right;
} TreeNode;

TreeNode *bstSearch(TreeNode *root, int target) {
    TreeNode *current = root;

    while (current != NULL) {
        if (target == current->value) {
            return current;
        }

        // 比当前值小只可能在左侧,否则只可能在右侧。
        current = target < current->value
            ? current->left
            : current->right;
    }

    return NULL;
}

void printResult(TreeNode *root, int target) {
    TreeNode *found = bstSearch(root, target);
    if (found != NULL) {
        printf("%d: found\n", target);
    } else {
        printf("%d: not found\n", target);
    }
}

int main(void) {
    TreeNode n20 = {20, NULL, NULL};
    TreeNode n40 = {40, NULL, NULL};
    TreeNode n60 = {60, NULL, NULL};
    TreeNode n80 = {80, NULL, NULL};
    TreeNode n30 = {30, &n20, &n40};
    TreeNode n70 = {70, &n60, &n80};
    TreeNode n50 = {50, &n30, &n70};

    printResult(&n50, 60);
    printResult(&n50, 25);
    return 0;
}
预期输出
60: found
25: not found
60 能沿 50 → 70 → 60 的路径命中;查找 25 时会沿 50 → 30 → 20 继续走向空指针,因此返回未找到。
快速取决于树高
设树高为 ,查找最多比较一条从根到叶方向的路径,因此时间复杂度是 。当树较平衡时, 约为 ,查找会明显少于逐个扫描全部节点。
二叉搜索树并不会自动保持平衡。如果按递增顺序插入 10、20、30、40,普通 BST 可能退化成类似链表的形状,此时 接近 ,最坏查找复杂度也会退化为 。所以“快速查找”来自有序分支加上合理树高,而不是只要使用 BST 就必然是对数复杂度。
查找前必须保证树仍然有序
查找算法正确的前提是整棵树持续满足同一套键顺序规则。如果插入、删除时破坏了左小右大的约束,查找可能错误地排除实际包含目标值的子树。
若业务允许重复键,还需要在数据结构设计阶段明确重复值统一放左侧、统一放右侧,或在节点中保存计数。规则必须与插入、删除、查找保持一致,否则搜索路径就不再可靠。