
C / C++ / 系统课时
不同排序算法该怎么选
不同排序算法该怎么选
面对同一组数据,能完成排序的算法很多,但“能排好”不等于“适合当前场景”。本节把冒泡、选择、插入、归并和快速排序放在同一组条件下比较,最后给出可直接用于选择的判断思路。
学习目标
- 能从数据规模、稳定性和额外空间三个维度比较排序算法
- 能根据数据是否近乎有序、是否要求稳定排序选择合适算法
- 能识别“快速排序一定最快”等常见误区
先看三个选择条件
选择排序算法时,最值得先问的不是“哪个算法名气最大”,而是当前数据有什么约束。通常先看数据规模和有序程度,再看稳定性要求,最后确认是否允许分配额外内存。
这里的“稳定”指相等关键字的元素排序后仍保持原有相对顺序。例如先按姓名排序,再按部门做稳定排序,同部门中的姓名顺序仍能保留下来。
| 算法 | 典型时间复杂度 | 稳定性 | 典型额外空间 | 更适合的情况 |
|---|---|---|---|---|
| 冒泡排序 | 稳定 | 数据很小、教学或需要极简实现 | ||
| 选择排序 | 不稳定 | 数据很小,且希望减少元素交换次数 | ||
| 插入排序 | 最坏 ,近乎有序时接近 | 稳定 | 小规模或近乎有序的数据 | |
| 归并排序 | 稳定 | 数组实现通常为 | 规模较大且必须稳定 | |
| 快速排序 | 平均 ,最坏 | 通常不稳定 | 递归栈平均约 | 通用内存数组、追求较好平均性能 |
按场景做决策
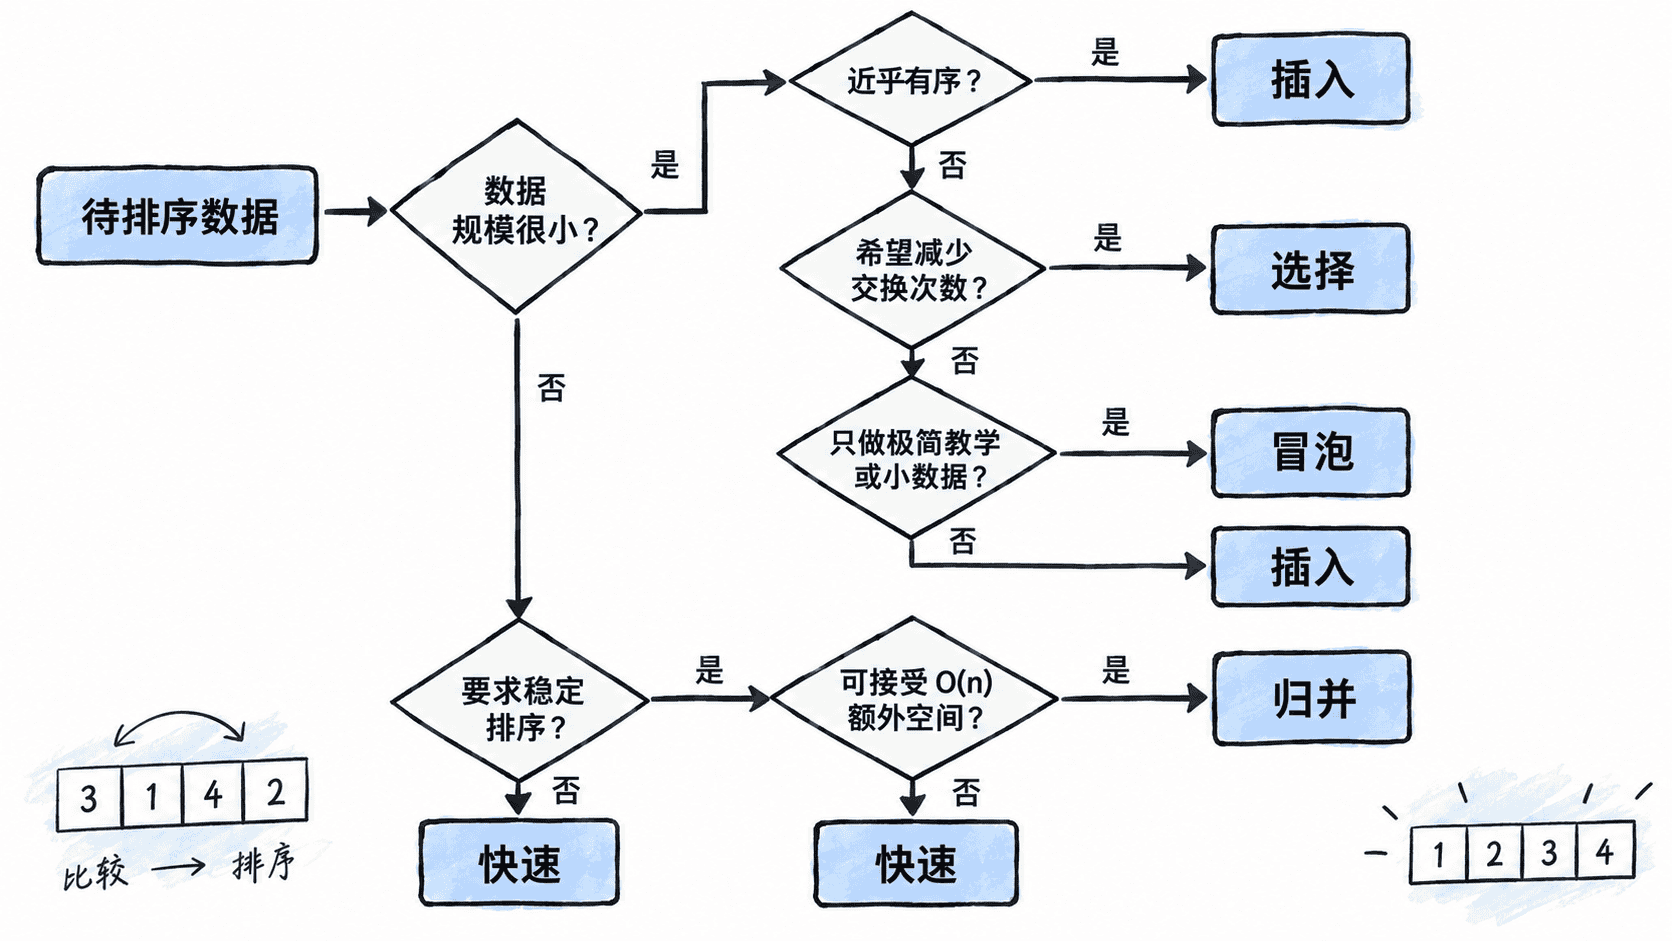
如果数据量只有几十个元素,算法常数和实现成本往往比渐进复杂度更重要,插入排序通常比维护复杂的归并流程更划算。数据接近有序时,插入排序尤其有优势。
如果必须保持相等元素的原有顺序,先排除典型的选择排序和快速排序。小规模数据可优先考虑插入排序;数据规模较大时,归并排序能提供稳定的 时间上界,但需要额外数组空间。
如果稳定性不是要求,数据规模又较大,快速排序常作为内存数组的通用选择。它平均性能好、局部性通常也不错,但必须认识到最坏情况会退化;实际工程中通常通过更好的基准选择或混合策略降低风险。
容易选错的地方
“快速排序一定最快”是最常见的误解。复杂度描述的是增长趋势,不等于每次运行时间;输入分布、数据规模、缓存局部性和实现方式都会影响结果。对非常小的数组,简单的插入排序可能更快。
另一个误区是只看时间复杂度。若业务依赖稳定性,使用不稳定排序可能直接改变结果语义;若内存紧张,归并排序的额外数组也可能成为主要限制。排序算法的选择本质上是约束之间的权衡,而不是背一张“速度排名表”。
因此可以把选择原则压缩成一句话:小而近乎有序时看插入,稳定且规模大时看归并,不要求稳定且追求通用平均性能时看快速;冒泡和选择更多用于小规模、教学或特定写入成本场景。