
C / C++ / 系统课时
插入排序为什么适合近乎有序数据
插入排序为什么适合近乎有序数据
插入排序会把数组左侧维护成有序区,再把下一个元素插入正确位置。数据越接近有序,需要向右移动的元素就越少。本课用 C 语言统计移动次数,对比近乎有序数组和逆序数组,解释它为什么具有明显的自适应性。
学习目标
- 实现插入排序,理解“有序区 + 待插入元素”的处理方式。
- 观察近乎有序数据中元素移动次数为什么显著减少。
- 掌握插入排序的最好、最坏复杂度及适用边界。
插入动作的本质
第 i 轮把 arr[i] 暂存为 key,然后从 i - 1 向左检查已经排好序的区间。只要左侧元素比 key 大,就把它向右移动一格;找到不大于 key 的位置后,再把 key 写入空位。
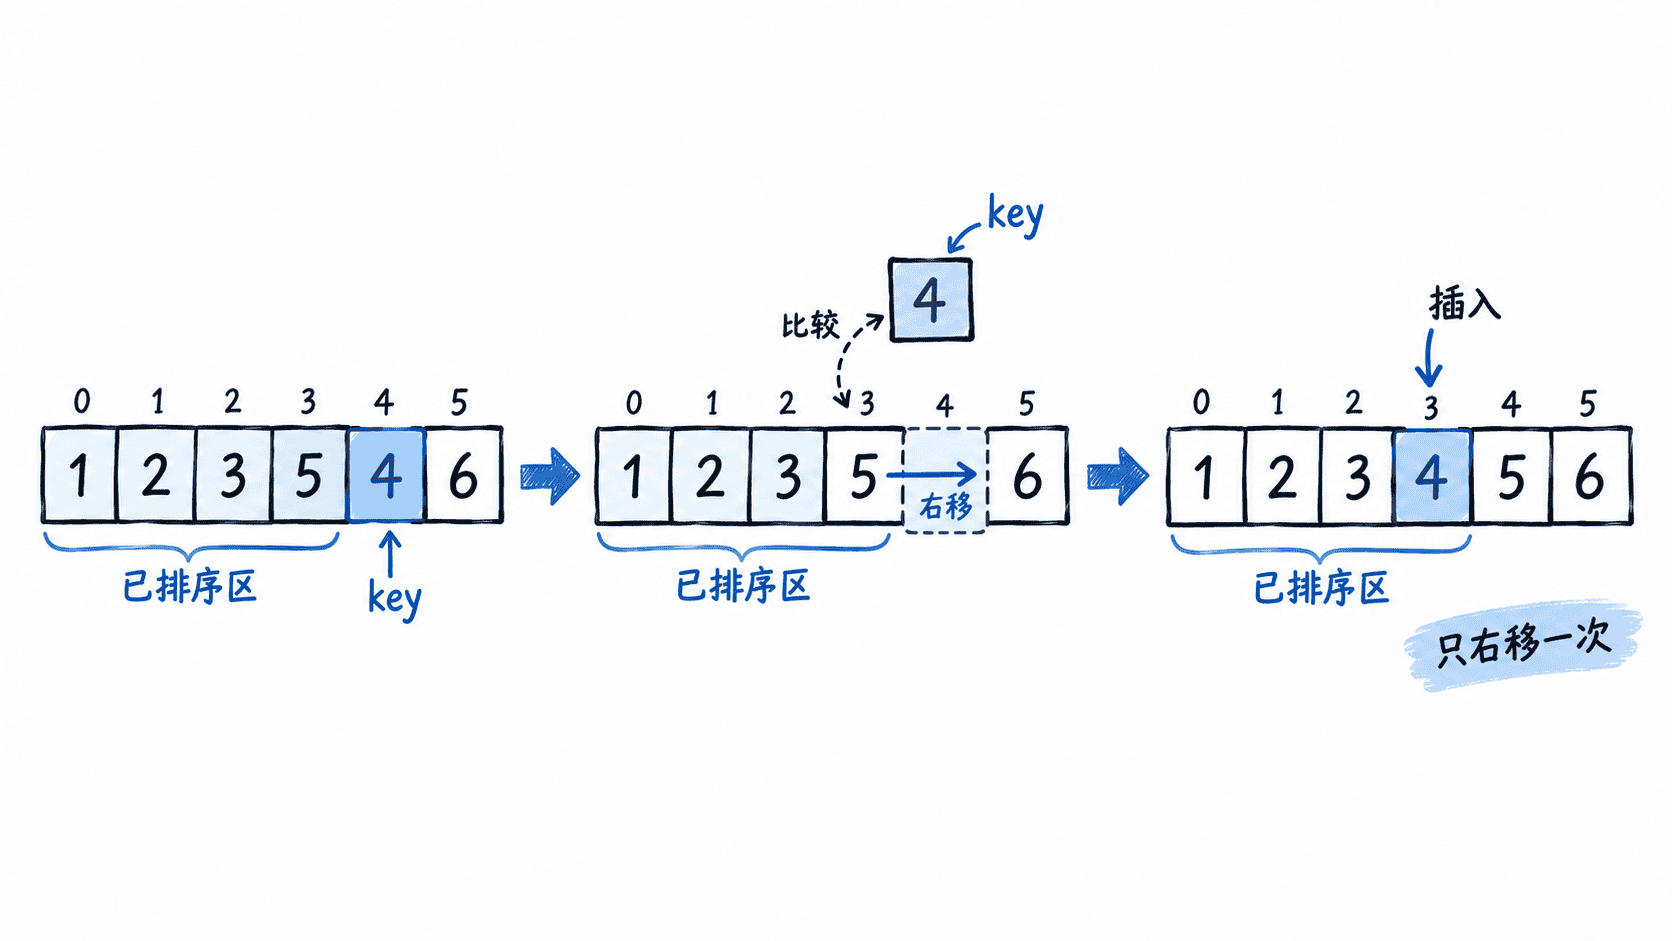
近乎有序时,key 往往已经接近最终位置,向左检查很快就停止。因此内层循环不会每轮都跑到底,这一点与选择排序“无论是否有序都要扫描剩余区间”不同。
用移动次数观察差异
下面的程序对两组长度相同的数据执行同一个插入排序函数,并统计“较大元素向右移动”的次数。为了让指标含义清晰,最后把 key 写回数组的动作不计入 moves。
#include <stdio.h>
#include <stddef.h>

static int insertion_sort(int arr[], size_t n) {
    int moves = 0;

    for (size_t i = 1; i < n; ++i) {
        /* [0, i) 已有序,先保存本轮待插入值。 */
        int key = arr[i];
        size_t j = i;

        /* 只移动真正挡住 key 的较大元素。 */
        while (j > 0 && arr[j - 1] > key) {
            arr[j] = arr[j - 1];
            --j;
            ++moves;
        }

        arr[j] = key;
    }

    return moves;
}

static void print_array(const int arr[], size_t n) {
    for (size_t i = 0; i < n; ++i) {
        printf("%d%s", arr[i], i + 1 == n ? "\n" : " ");
    }
}

int main(void) {
    int nearly_sorted[] = {1, 2, 3, 5, 4, 6};
    int reversed[] = {6, 5, 4, 3, 2, 1};
    size_t n = sizeof(nearly_sorted) / sizeof(nearly_sorted[0]);

    /* 使用同一实现比较不同初始有序程度。 */
    int near_moves = insertion_sort(nearly_sorted, n);
    int reverse_moves = insertion_sort(reversed, n);

    printf("nearly sorted: ");
    print_array(nearly_sorted, n);
    printf("moves=%d\n", near_moves);

    printf("reversed:      ");
    print_array(reversed, n);
    printf("moves=%d\n", reverse_moves);

    return 0;
}
预期输出
nearly sorted: 1 2 3 4 5 6
moves=1
reversed:      1 2 3 4 5 6
moves=15
第一组数据只有 5 和 4 的相对次序错误,因此只需要把 5 右移一次。第二组完全逆序,每个新元素都要一路移动到当前有序区最左端,所以总移动次数达到 5 + 4 + 3 + 2 + 1 = 15。
近乎有序为什么更快
插入排序的移动次数与数组中的逆序关系密切:每存在一个“前面的值大于后面的值”的逆序关系,排序过程中就需要通过移动逐步消除它。逆序越少,总移动量越小。
对于已经有序的数组,每轮第一次比较就能停止,整体接近线性工作量,最好时间复杂度为 O(n)。对于完全逆序数组,第 i 个元素几乎要跨过整个已排序区,最坏时间复杂度为 O(n^2)。
这种“输入越接近目标状态,实际工作越少”的特性称为自适应性。它也是插入排序在小数组、局部有序数据和某些混合排序算法的小区间处理阶段仍然常见的重要原因。
使用时要注意什么
插入排序是原地排序,只需要常数级额外空间,并且在比较条件使用 arr[j - 1] > key 时是稳定排序:相等元素不会跨越彼此。
判断是否适合插入排序时,可以先看数据规模和逆序程度:小规模或基本有序时,它简单且常常高效;如果数据随机且规模较大,应优先考虑平均或最坏复杂度更低的排序方案。