
游戏 AI / 系统课时
控制 Service 与 Tick 频率
控制 Service 与 Tick 频率
当场景里只有几名敌人时,逐帧检查目标距离似乎没有问题;增加到一百名 AI 后,同一帧集中执行 Service、EQS 和自定义 Task Tick 就可能造成 Game Thread 峰值。本课把更新工作拆成事件响应、低频轮询和必要的连续执行,并用可运行脚本估算错峰带来的收益。
学习目标
- 区分 Service 周期更新、Task Tick 与 Blackboard 事件驱动。
- 按行为时效性设置
Interval、Random Deviation和挂载范围。 - 用调用次数、单帧峰值与运行时性能数据验证优化。
确认真正消耗 CPU 的更新源
UE5 行为树并不是每帧从 Root 完整扫描。Service 挂在 Composite 或 Task 上,且其分支活跃时才按设定频率运行;Blackboard Decorator 可以在键变化时驱动分支切换。不要把行为树本身、Service 和 Actor Tick 当成同一套调度。
在有固定数量 AI 的同一测试场景中,记录以下三类开销:
- Service:
Receive Tick AI或原生 Service 的周期回调,特别是其中的距离计算、遍历 Actor 和 EQS 请求。 - Task Tick:自定义 Task 的
Receive Tick AI或原生 Tick 逻辑。只需要等待事件完成的 Task 不必自行每帧轮询。 - Actor/Component Tick:即使 Service 频率降低,角色或组件内部的 Tick 仍可能持续发生。
先用 stat game 观察 Game Thread 开销,再用 Unreal Insights 对照同等敌人数量、路径与战斗负载下的热点调用。只看到帧率下降不足以证明 Service 是根因;还要核对实际调用次数和每次耗时。
按实时性和计算量分配频率
假定同时活跃 100 名 AI,每名每 0.1 秒运行一次距离 Service,理论上约有每秒 1000 次检查;改为每 0.5 秒一次则约为 200 次。这个估算不包括激活时额外 Tick、随机偏差和分支停用,也不等于实际 CPU 耗时必定降低五倍。
可从下表开始试配,数值是调优起点而不是 UE 默认值:
| 工作内容 | 初始策略 | 判断依据 |
|---|---|---|
| 受击、看到目标或目标失效 | 优先事件驱动 | 需要尽快反应,不能等慢速轮询 |
| 追击中的距离及攻击范围 | 活跃追击分支下每 0.1~0.3 秒 | 根据攻击窗口与允许延迟调整 |
| 非紧急战术位置重新评估 | 每 0.5~2 秒或事件触发 | EQS 通常比读取缓存键更重 |
| 远处待机环境检查 | 低频,或进入相关状态时运行 | 不需要每帧更新 |
把昂贵的 Service 挂在真正需要它的 Chase/Combat 分支,而不是长期活跃的上层 Composite。读取已有 TargetActor 和 Blackboard 事实,避免每次调用都全场搜索;写回前比较新旧值,减少不必要的条件观察通知。已有 Move To 指向 Actor 时,也不要额外每帧重新发起同一移动请求。
把集中更新分散到多个帧
即使每个 AI 的 Interval 都是 0.5 秒,若一百名敌人同一刻激活,更新仍可能集中。Service 的 Random Deviation 可加入间隔变化,帮助打散同时触发;Call Tick on Search Start 会增加进入搜索时的即时调用,Restart Timer on Each Activation 影响重新激活后的计时。要根据响应要求逐一决定,而非机械开启。实际操作是选中 Behavior Tree 中的 Service 节点,在 Details 中设置 Interval 和 Random Deviation;例如先试 0.5 秒和 0.1 秒,再用运行时数据校正。官方 Service 参考 列出了这些选项。
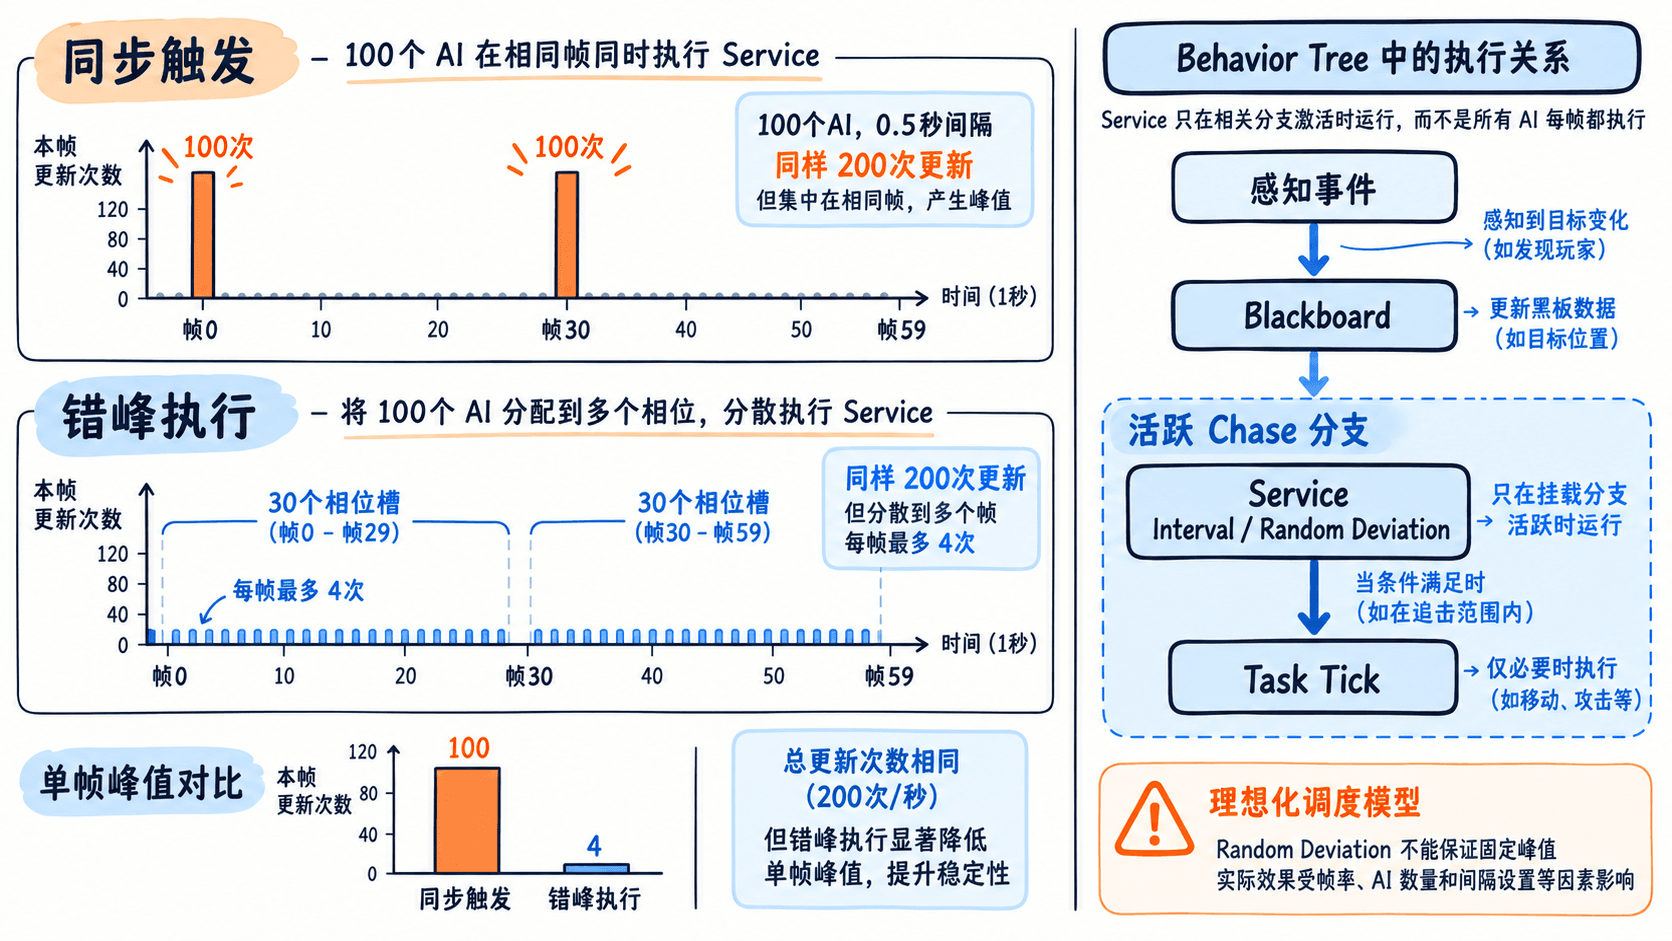
下面使用 Python 3 模拟理想化的两种调度。设 60 FPS、观察 60 帧、100 个 AI 每 30 帧更新一次:第一种在帧 0 与帧 30 集中执行,第二种将首次执行分散到 30 个相位槽。它不是 UE 的 Service API,也不代表 Random Deviation 可以保证相同峰值。
from collections import Counter

AI_COUNT = 100
FRAMES = 60
PERIOD = 30  # 60 FPS 下,30 帧约为 0.5 秒

def measure(offset_for_ai):
    per_frame = Counter()
    for ai in range(AI_COUNT):
        # 每个 AI 保持 30 帧周期,只改变初始相位。
        # 统计每帧的调用数,比较瞬时峰值而非平均值。
        for frame in range(offset_for_ai(ai), FRAMES, PERIOD):
            per_frame[frame] += 1
    return sum(per_frame.values()), max(per_frame.values())

for name, offset in [
    ("集中执行", lambda ai: 0),
    ("错峰执行", lambda ai: ai % PERIOD),
]:
    total, peak = measure(offset)
    print(f"{name}: 总次数={total}, 单帧峰值={peak}")
预期输出:
集中执行: 总次数=200, 单帧峰值=100
错峰执行: 总次数=200, 单帧峰值=4
这里总次数不变,改善的是负载分布;若同时增加 Interval,才会进一步减少平均查询次数。真实场景还有行为分支进入、离开和各节点执行耗时差异,不能直接把模拟峰值当成 UE 的性能指标。
用事件替代无意义的每帧轮询
感知变化由 AI Perception 的目标感知更新事件处理,再将结果写入 Blackboard;Decorator 监听条件变化后按配置中断分支。定时 Service 更适合更新无法从事件直接获得的慢变量,例如战术评分或非紧急距离检查。对于自定义 Task,完成、失败和 Abort 可以由异步操作回调收尾时,就不要为等待结果持续执行 Tick。
优化时同时考虑准确性:比如攻击判定允许 0.1 秒更新,不意味着受击或死亡也应该延迟 0.1 秒。应把紧急事件与非紧急计算拆开,而不是统一把所有 Tick 改成 1 秒。
用同场景基准验收
固定 20、50、100 名 AI 三组规模,在相同地图和行为脚本下,对照修改前后的 Service 调用总数、Game Thread 帧时间分布和行为响应延迟。重点观察最慢帧与连续峰值,而不只看平均 FPS。使用 Unreal Insights 检查重计算是否真的减少,并验证敌人发现目标、追击、攻击和脱战都仍满足设计时限。
最后逐个恢复此前关闭的 Service 或 Tick,以确认哪个节点真正贡献了开销;如果降频后计算峰值变小却导致目标更新迟缓,应优先采用事件触发、缓存结果和缩小运行范围,而非继续降低所有行为的响应频率。