
游戏 AI / 系统课时
定位行为反复切换
定位行为反复切换
敌人靠近玩家时在攻击与追击之间快速跳转,或刚丢失视线就来回切换巡逻,通常不是 Selector 自身出错,而是 Blackboard 条件短时间翻转并触发任务中断。本课从运行时记录入手,逐层找到抖动来源,再用双阈值和正确的观察策略稳定行为。
学习目标
- 记录 Blackboard 键、活动分支与 Abort 的对应时序。
- 分辨目标引用抖动、距离阈值抖动和 Decorator 抢占配置问题。
- 用可复现的距离样本验证双阈值修复效果。
先记录切换发生的瞬间
在 PIE 中让玩家反复经过敌人攻击边界,例如距敌人约 200 厘米的位置,观察攻击动画是否刚开始就被追击打断。打开 Behavior Tree 资产,选择正在运行的 AI 调试实例;配合 AI Debugger(运行时默认按单引号键开启),查看当前 Task 与 Blackboard 值。
每次发生切换时,至少记录时间、TargetActor、目标距离、InAttackRange、活动 Task。如果 Blackboard 的某个键一直改变,还应通过对应 Service、感知回调中的断点或临时日志查出写入者;调试器能显示值,却不会自动告诉你哪个逻辑最后写入了它。
按下列证据逐项缩小范围:
| 观察到的现象 | 优先检查 |
|---|---|
TargetActor 在 Actor 与空值间跳变 |
Sight 丢失事件、记忆时长、重复清空逻辑 |
| 距离在 198~205 cm 波动,攻击反复进出 | 进入和退出共用 200 cm 阈值 |
| Blackboard 键不变,却持续重新进入 Task | Task 返回状态、循环结构、Service 激活逻辑 |
目标有效但 Move To 频繁停止重启 |
Decorator Abort 配置、外部移动命令与 Task 中断 |
把键值变化和 Abort 连成因果链
行为树的高优先级 Attack 分支可能挂有 InAttackRange == true 的 Blackboard Decorator。Notify Observer = On Value Change 观察键的任何变化,On Result Change 只在条件判断结果变化时触发重评估。后者能减少无意义重评估,但如果布尔条件真的在 true/false 间跳动,仍会造成中断。
Observer Aborts = Self 允许条件不满足时中断当前分支;Lower Priority 允许条件满足时抢占右侧低优先级分支;Both 同时具备这两类作用。使用 Both 前,要先确认该分支确实需要双向抢占,不能靠关掉所有 Abort 掩盖错误数据。设置说明可查阅 官方 Decorator 参考。
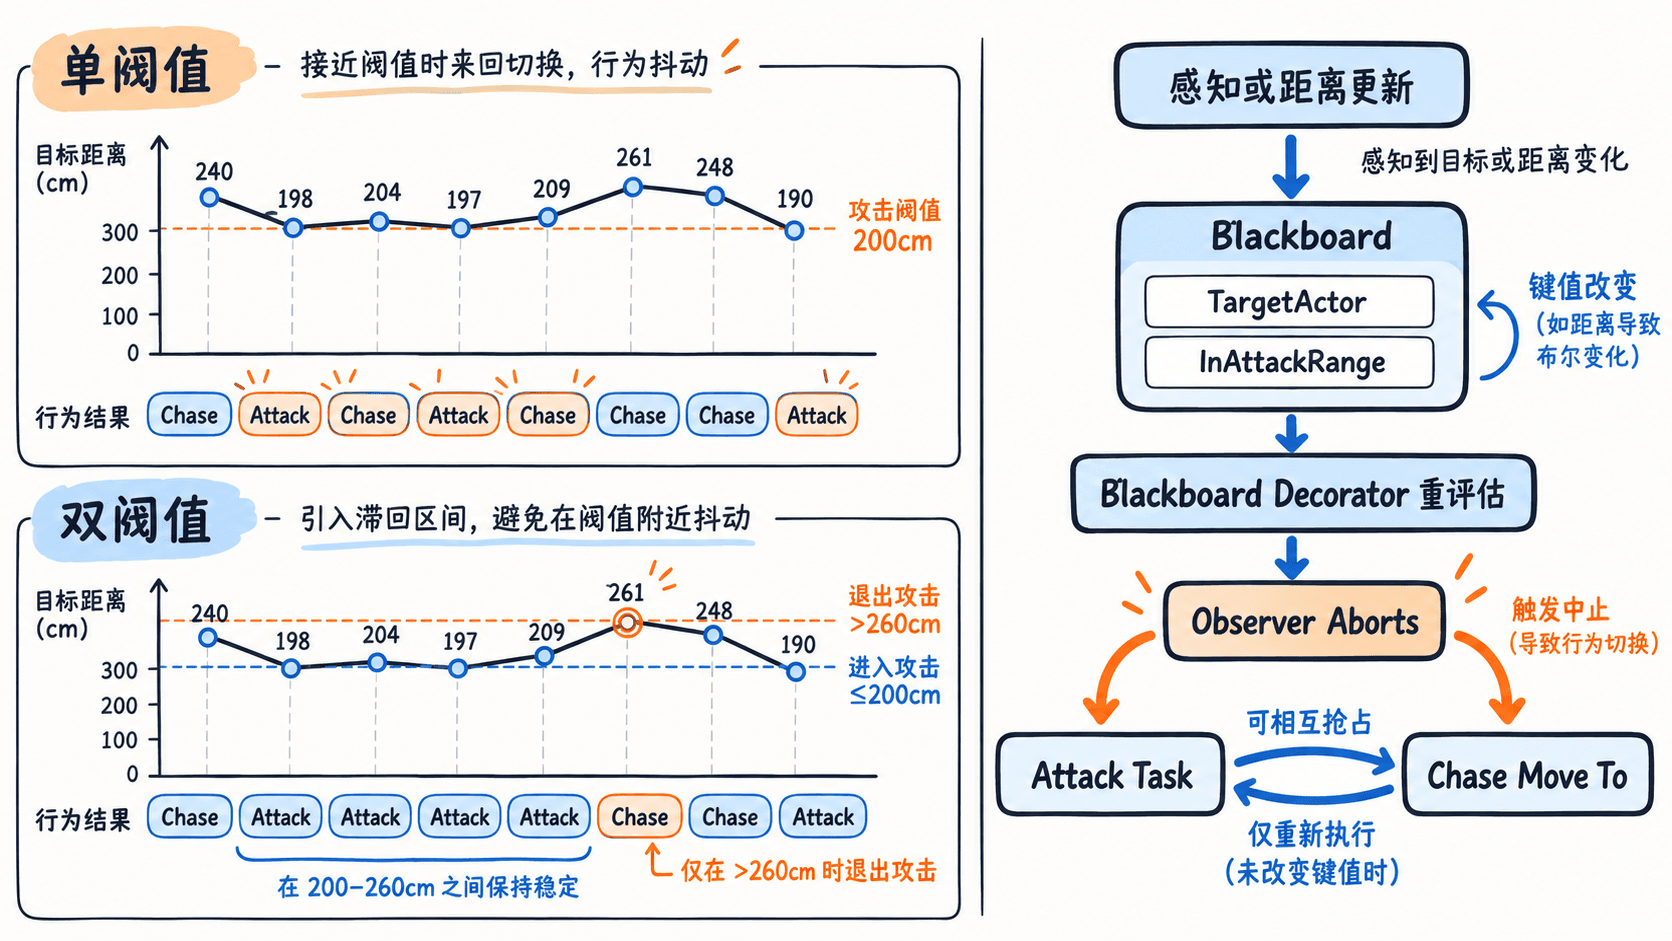
图中最重要的区分是:数据产生抖动与抖动被放大为 Task 重启是两个不同环节。比如距离测量每次更新虽有波动,但只要判断结果不变,就不应造成攻击与追击互相抢占。
用双阈值消除边界翻转
不要让进入攻击和退出攻击共用同一个半径。可设进入攻击距离 200 cm、退出攻击距离 260 cm:未攻击时只有距离 ≤200 才进入;正在攻击时只有距离 >260 才退出。中间 200~260 cm 区域保留上一次状态。
下面是可独立运行的 Python 3 距离回放脚本,模拟同一组采样在两种策略下的切换次数;它用于验证判定逻辑,不是 Unreal API。
samples = [(0.0, 240), (0.1, 198), (0.2, 204), (0.3, 197),
           (0.4, 209), (0.5, 261), (0.6, 248), (0.7, 190)]

def replay(enter_cm, exit_cm):
    attacking = False
    changes = []
    for t, distance in samples:
        previous = attacking
        # 退出阈值大于进入阈值,保留中间区间的旧状态。
        # 已进入攻击的 AI 不能直接复用进入阈值判断。
        if attacking:
            attacking = distance <= exit_cm
        else:
            attacking = distance <= enter_cm
        if attacking != previous:
            state = "Attack" if attacking else "Chase"
            changes.append(f"{t:.1f}s:{state}")
    return ", ".join(changes)

print("单阈值:", replay(200, 200))
print("双阈值:", replay(200, 260))
预期输出:
单阈值: 0.1s:Attack, 0.2s:Chase, 0.3s:Attack, 0.4s:Chase, 0.7s:Attack
双阈值: 0.1s:Attack, 0.5s:Chase, 0.7s:Attack
在 UE5 中,先为敌人 Blackboard 创建 Bool 键 InAttackRange;再由负责战斗距离的 Service 或组件读取该 AI 上一次的值,按两个半径计算新状态,只有状态变化时才写回 Blackboard。攻击分支用该键作 Decorator 条件。状态须按 AI 实例分别保存,不能用所有敌人共享的全局变量。滞回保持的是战斗意图,技能实际命中范围仍需独立校验。TargetActor 已销毁或敌人死亡时,应优先执行明确的失效处理,不能因为滞回而保留无效目标。
消除多写入者和抢占后的残留
若同一键由感知回调和 Service 同时写入,先确定唯一权威写入位置。例如感知负责 TargetActor 与 HasLineOfSight,距离 Service 只计算 InAttackRange。短暂丢失视线可以保留 LastKnownLocation 用于搜索,但不能把“暂时看不见”直接等同于“目标无效”。
如果自定义 Task 使用计时器、异步请求或委托,在收到 Abort 时还应停止自身未完成的工作,并防止旧回调在新分支启动后覆写 Blackboard。否则即使阈值稳定,也可能出现延迟写入引发的第二轮切换。
修复后用相同路线重复测试,分别验证距离在 200 cm 附近来回波动、越过 260 cm、目标真正失效三种情况。期望前者不反复抢占,后两者能够及时转入正确分支;调试时应以可观察的键变化和 Task 状态为准,而不是只看角色动画是否平顺。