
FPGA 与数字 IC 设计 / 系统课时
依照综合与时序报告修正瓶颈
依照综合与时序报告修正瓶颈
双时钟流式统计模块通过功能仿真后,仍可能存在寄存器数量偏高、组合逻辑过深或目标频率无法满足的问题。本课使用综合资源报告和静态时序分析(STA)报告定位瓶颈,完成一次可验证的 RTL 优化,并通过回归测试确认功能没有退化。
学习目标
- 从综合资源统计和 STA 路径中判断面积与时序瓶颈。
- 针对统计流水线的长组合路径实施一次 RTL 优化。
- 对比优化前后报告,并用等价性检查与回归测试防止功能回退。
固定优化基线和验收条件
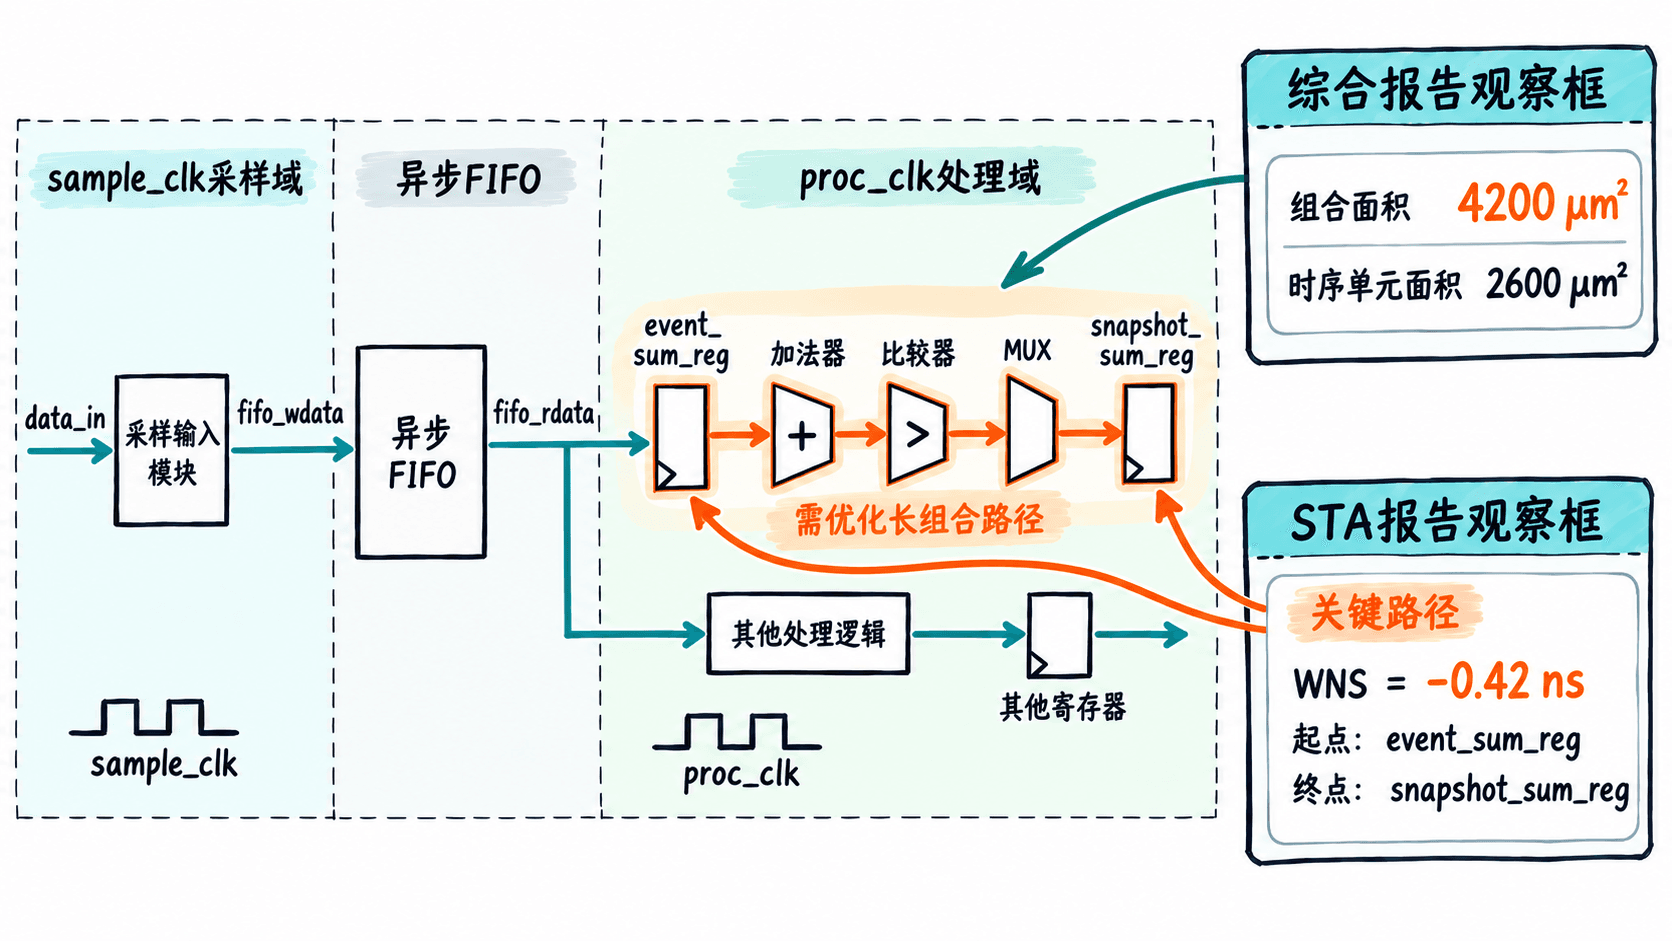
假设双时钟统计模块包含采样时钟域 sample_clk、异步 FIFO 和处理时钟域 proc_clk。处理域从 FIFO 接收 8 位事件数据,对事件数量和累加值进行统计,再通过 ready-valid 接口输出快照。
本课使用以下示例约束,数值是实验目标,不代表特定 FPGA 或 ASIC 工艺的实际性能。
| 检查项目 | 示例目标 | 验收条件 |
|---|---|---|
| sample_clk | 100 MHz | 周期 10 ns |
| proc_clk | 125 MHz | 周期 8 ns |
| proc_clk 建立时间余量 | 不小于 0 ns | 全部有效约束路径通过 |
| 逻辑面积 | 不高于基线 | 不增加明显冗余资源 |
| 统计功能 | 与基线一致 | 事件不丢失、不重复 |
| 快照协议 | ready-valid | 背压期间数据保持稳定 |
先固定 RTL 版本、顶层参数、时序约束、综合工具版本、目标器件或标准单元库以及测试随机种子。不同约束下的 WNS(最差负裕量)、面积和功耗不能直接视作同条件比较。
如果使用 ASIC 流程,需明确面积来自映射后还是布局布线后;如果使用 FPGA 流程,应分别记录 LUT、FF、BRAM 和 DSP 等资源,而不是将它们混合为单一门数。
联合阅读综合与时序报告
报告分析采用三个步骤:先找超标指标,再定位具体路径,最后回到 RTL 确认形成该路径的表达式。
在 Synopsys Design Compiler 的综合会话中,可以使用以下命令查看已完成映射和约束分析的设计。片段示例依赖已经加载的目标库、RTL、时序约束以及完成的 compile_ultra,不包含工程专属的库路径和顶层名称。
# 汇总映射资源和组合逻辑面积
report_area -hierarchy
report_reference

# 查看最差建立时间路径及逐级延迟
report_timing -delay_type max -max_paths 10 -path_type full
report_constraint -all_violators预期结果:report_area 列出层级面积,report_reference 列出已映射单元及实例数量;report_timing 展示起点、终点、单元增量延迟、累计到达时间及 slack;report_constraint 显示违反的约束。具体数值取决于目标库、工作条件与约束。
阅读一条路径时,至少记录起点寄存器、终点寄存器、经过的组合单元、逻辑深度、单元延迟、网络延迟和 slack。WNS 为负意味着至少存在一条未满足建立时间约束的路径;WNS 为正也不能证明保持时间、CDC 或其他约束全部正确。
以一次假设的综合分析为例:
| 指标 | 基线测量值 | 观察 |
|---|---|---|
| proc_clk WNS | -0.42 ns | 建立时间未通过 |
| 最差路径 | event_sum_reg → snapshot_sum_reg | 统计累加与快照选择路径 |
| 路径组合逻辑 | 加法器、比较器、MUX | 逻辑级联较深 |
| 映射组合面积 | 4200 µm² | 作为优化对照基线 |
| 映射时序单元面积 | 2600 µm² | 检查新增流水寄存器代价 |
这些数据只演示定位过程,不是工具运行的真实报告。路径延迟必须结合时钟偏斜、建立时间、时钟不确定性及实际路径组共同分析,不能只用 8 ns 减去组合逻辑延迟得到 slack。
修改长组合路径而不改变协议
假设最差路径与事件累加有关,原实现把数据加法和附加条件选择串接在同一个时钟周期内。优化前先确认 STA 报告确实经过这些单元,不能仅凭 RTL 看起来复杂就决定修改。
下面演示将 8 位事件数据先扩展到 32 位寄存器,再送入累加寄存器。输入端 in_valid 代表已经从 FIFO 成功取出的事件;这里仅展示处理域流水线,不是完整双时钟顶层。
module event_accumulator (
    input  logic        clk,
    input  logic        rst_n,
    input  logic        in_valid,
    input  logic [7:0]  in_data,
    output logic        out_valid,
    output logic [31:0] out_sum
);
    logic        stage_valid;
    logic [31:0] stage_data;
    logic [31:0] sum_reg;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            stage_valid <= 1'b0;
            stage_data  <= '0;
            sum_reg     <= '0;
            out_valid   <= 1'b0;
            out_sum     <= '0;
        end else begin
            // 第一级缓存已被接受的事件,不自行读取FIFO
            stage_valid <= in_valid;
            if (in_valid)
                stage_data <= {24'b0, in_data};

            // 第二级仅在前级有效时更新累计值
            out_valid <= stage_valid;
            if (stage_valid) begin
                sum_reg <= sum_reg + stage_data;
                out_sum <= sum_reg + stage_data;
            end
        end
    end
endmodule
预期结果:复位后的 out_sum 为零。若连续两个时钟上升沿分别接收十进制事件 3 和 5,则相应累计输出依次为 3 和 8;out_valid 相对输入有效事件延后一拍采样。在输入持续有效时,输出可连续有效。
本例展示了加法输入寄存器化,但没有把最终的加法器进一步切成多拍。因此是否缩短关键路径要以重新综合后的报告为准;如果最差路径位于累加器反馈环,单纯增加输入寄存器通常不会消除该瓶颈。应进一步评估加法器结构、数据宽度、快照读取路径或额外延迟允许情况。
新增流水级会改变输出可见周期。若接口合同规定固定延迟,应同步修改所有关联数据、有效位和快照标识的流水位置;若不能改变延迟,应优先选择不改变周期行为的逻辑优化,或使用形式等价性工具证明改动合法。
复跑报告并判断优化是否有效
再次综合时必须保持相同的目标库、时钟约束、优化选项和报告阶段。以下是一组假设复测数据,用来说明如何形成结论。
| 指标 | 优化前 | 优化后 | 结论 |
|---|---|---|---|
| proc_clk WNS | -0.42 ns | +0.11 ns | 建立时间通过 |
| 映射组合面积 | 4200 µm² | 4050 µm² | 减少约 3.6% |
| 映射时序单元面积 | 2600 µm² | 2750 µm² | 增加约 5.8% |
| 总单元面积 | 6800 µm² | 6800 µm² | 无净面积收益 |
| 输入到结果延迟 | 原接口基线 | 增加一拍 | 需要合同审查 |
这里的数值为教学算例,不能当作前述 RTL 一定能够达到的优化效果。组合面积下降并不代表总面积下降;同样,WNS 改善也不意味着吞吐率和端到端延迟一定改善。
若目标是 proc_clk 125 MHz,则还要检查全部相应路径组,以及最大转换时间、最大电容、最大扇出和保持时间违例。最差路径修好后,新的次差路径可能成为瓶颈。
报告对比建议固定保存为 baseline/ 和 optimized/ 两组记录,各自包含 RTL 版本标识、约束文件、面积报告、最大及最小延迟报告和测试结果。不要仅保存一张 WNS 截图,因为后续无法核实约束是否发生变化。
用功能回归和跨域检查守住边界
综合通过只说明实现满足对应的逻辑与时序检查,不证明双时钟事务一定正确。必须在优化版本上重新运行仿真,并通过参考模型比较有效输出序列。
最少覆盖以下场景:
- FIFO 连续输入 1000 个事件,核对累计值及事件数量。
- 处理时钟快于和慢于采样时钟各运行一组随机测试,确认没有丢失、重复或乱序。
- 下游连续拉低
m_ready至少 20 个处理时钟周期,检查有效数据保持不变。 - 分别复位两个时钟域,按模块规定的恢复协议重新开始传输,检查非法输出和残留事件。
- 对累加值接近
32'hFFFF_FFFF的边界执行测试,明确回绕、饱和或扩宽策略。
可以将背压稳定性写成 SVA。下面是片段示例,依赖完整模块中已有的 proc_clk、proc_rst_n、m_valid、m_ready 和 m_data 信号。
// 被阻塞的输出必须在下一个采样周期仍保持有效且数据不变
ap_stable_on_stall: assert property (
    @(posedge proc_clk) disable iff (!proc_rst_n)
    (m_valid && !m_ready) |=>
        (m_valid && $stable(m_data))
);
预期结果:正常仿真不触发断言失败;如果输出在背压期间撤销有效位或改变数据,仿真器应报告对应断言失败。该属性只检查背压稳定性,不负责证明无丢包或双时钟复位恢复正确。
最后使用参考队列在输入握手成功时入队、输出握手成功时出队,并逐笔核对数据。如果改动允许固定延迟变化,可以按事务顺序比较;如果要求逐周期等价,则必须同时比较握手、有效位和所有可观察输出的具体周期。
只有在约束完整、时序满足、面积代价可接受、协议边界通过并且回归测试无失败时,才能把优化版本作为交付候选。若时序变好但固定延迟合同被破坏,应判定本轮优化未通过功能验收,而不是只凭正的 WNS 接受修改。