
FPGA 与数字 IC 设计 / 系统课时
比较不同 RTL 写法的面积时序代价
比较不同 RTL 写法的面积时序代价
同一个功能可以用流水线、资源共享或组合逻辑重构实现,但综合后的面积和时序可能相差很大。本课通过一个双加法运算模块,建立可重复的综合实验,比较逻辑单元数量、最差时序余量和执行周期,最终选出符合设计约束的 RTL 实现。
学习目标
- 能在相同综合约束下比较不同 RTL 实现的面积、时序和延迟。
- 能理解流水化、资源共享与组合逻辑重构各自的代价。
- 能通过综合统计与关键路径报告判断优化是否真正有效。
建立可比较的实验基线
假设模块需要计算两个独立的 8 位无符号加法结果:y0 = a + b、y1 = c + d。输出宽度为 9 位,以保留进位。输入在有效时钟沿采样,输出需要按明确的协议标记有效。
先定义比较约束:目标时钟周期为 2.00 ns,输入输出时序约束保持一致,使用同一标准单元库、综合工具版本、工艺角和优化设置。比较时不仅看是否达到目标频率,还要记录运算吞吐率、输入到输出的周期延迟及寄存器数量。
| 指标 | 统一定义 | 本例目标 |
|---|---|---|
| 时钟周期 | 相邻有效时钟沿间隔 | 2.00 ns |
| 目标频率 | 时钟周期的倒数 | 500 MHz |
| 组合逻辑面积 | 映射后组合单元面积之和 | 越小越好 |
| 总单元面积 | 组合单元与时序单元面积之和 | 不超过面积预算 |
| WNS | 最差时序余量 | 不小于 0 ns |
| 吞吐率 | 每周期完成的运算对数 | 1 对/周期 |
WNS(Worst Negative Slack,最差时序余量)通常取分析路径中的最小 slack。对于 setup 检查,负值表示至少一条受检查路径未满足时序要求;正值表示被分析路径具有相应余量。它不能单独证明设计满足所有 hold、跨时钟域或未约束路径要求。
比较流水化和资源共享的结构差异
先考虑三种实现,明确它们改变了什么,再比较综合结果。
并行基线使用两个独立加法器,每个周期同时计算一对结果,并在时钟沿写入输出寄存器。它只需要一级计算路径,适合要求每周期接受新输入的接口。
流水化实现将加法拆分为低 4 位和高 4 位两段。第一段寄存低位结果、进位和高位操作数,第二段完成高位加法。这样缩短了单级组合路径,但增加寄存器与有效标志的流水级,输出延迟也增加一个周期。
资源共享实现用一个加法器分时完成两次运算。若每周期最多执行一次 9 位加法,则一对结果至少需要两个计算周期,通常还要保存中间结果与输入操作数,因此不能直接满足每周期一对结果的吞吐率要求。
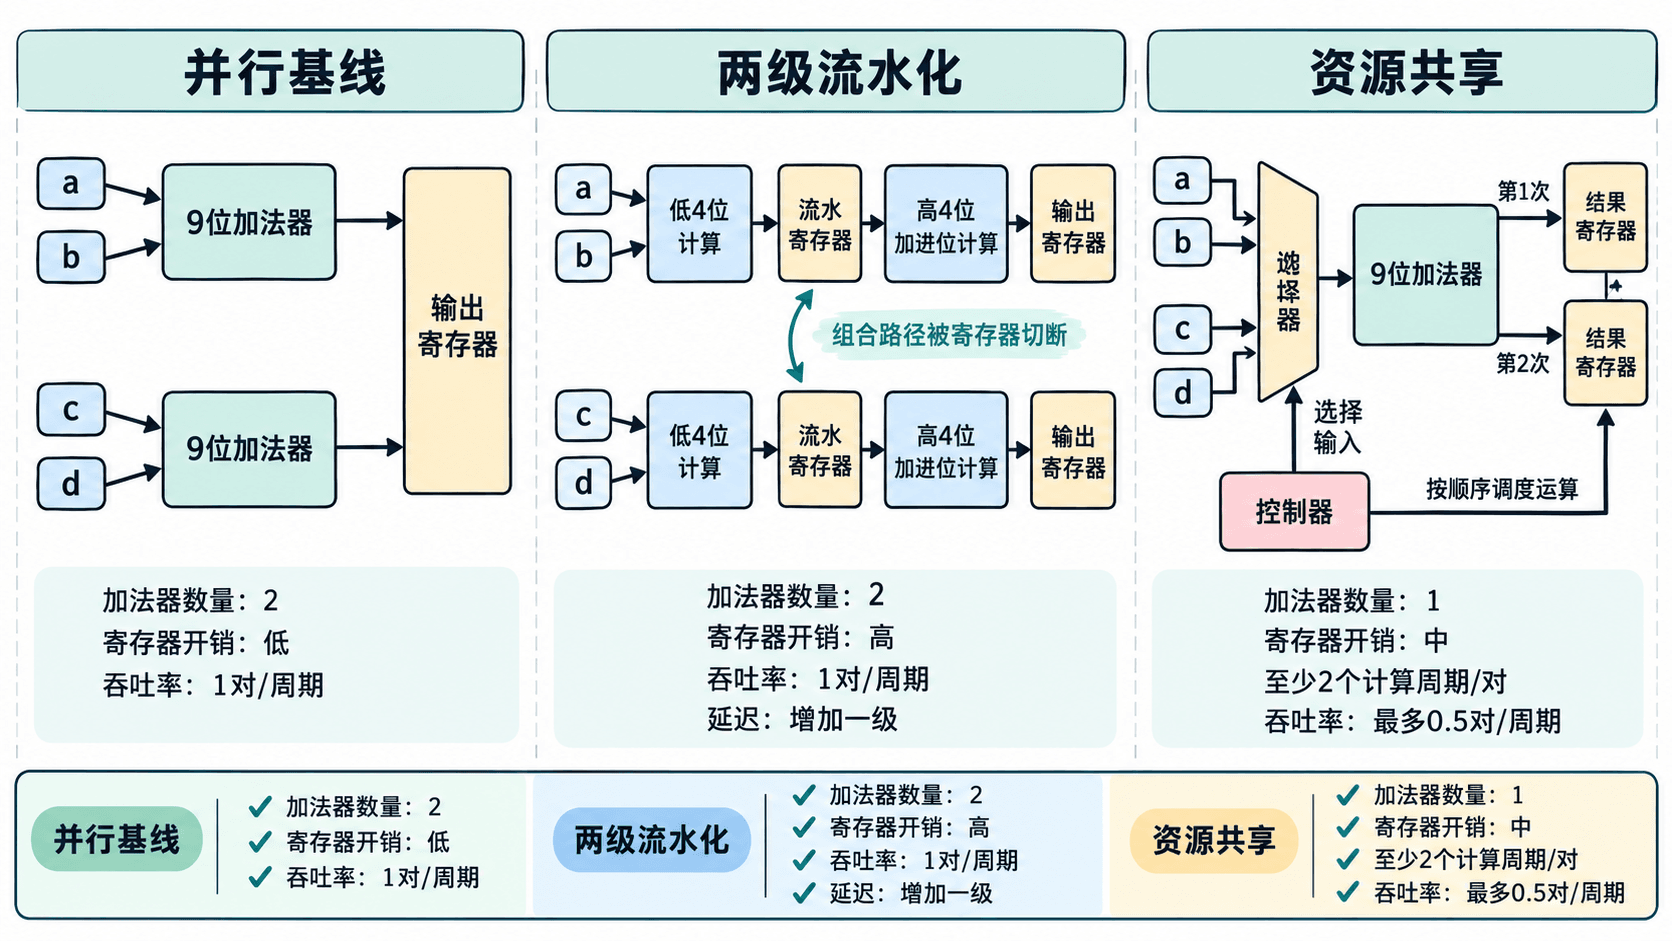
从结构上看,流水线通常以更多时序单元换取更短组合路径,资源共享通常以复用运算单元换取更低吞吐率。实际面积变化还取决于综合器能否优化选择器、进位逻辑及中间寄存器。
用 Yosys 对比组合逻辑重构
为了先建立可运行的面积对比实验,使用 Yosys 的通用逻辑综合流程,比较两种等价的组合加法写法。此实验不需要厂商工艺库,适合检查结构差异,但通用逻辑单元统计不能直接换算成芯片面积,也不能产生可靠的物理时序 WNS。
下面给出完整的 SystemVerilog 示例,保存为 add_compare.sv。两种模块均输出正确的 9 位加法结果。
module add_parallel (
    input  logic [7:0] a, b, c, d,
    output logic [8:0] y0, y1
);
    // 两组加法互不依赖,可以并行执行。
    assign y0 = {1'b0, a} + {1'b0, b};
    assign y1 = {1'b0, c} + {1'b0, d};
endmodule

module add_split (
    input  logic [7:0] a, b, c, d,
    output logic [8:0] y0, y1
);
    logic [4:0] lo0, lo1;
    logic [4:0] hi0, hi1;

    // 按低位进位、高位求和拆分;此处没有插入寄存器。
    assign lo0 = {1'b0, a[3:0]} + {1'b0, b[3:0]};
    assign lo1 = {1'b0, c[3:0]} + {1'b0, d[3:0]};
    assign hi0 = {1'b0, a[7:4]} + {1'b0, b[7:4]} + lo0[4];
    assign hi1 = {1'b0, c[7:4]} + {1'b0, d[7:4]} + lo1[4];
    assign y0 = {hi0, lo0[3:0]};
    assign y1 = {hi1, lo1[3:0]};
endmodule
这里的 add_split 是组合逻辑重构,而不是真正的两级流水线。它没有时钟与寄存器,因此不能声称增加了流水级或缩短了寄存器到寄存器的关键路径。综合器还可能将两种写法优化为相近的逻辑网络。
在安装了 Yosys 的环境中运行以下命令,分别综合两个顶层模块,并保存统计报告。
yosys -p 'read_verilog -sv add_compare.sv; hierarchy -top add_parallel; synth -top add_parallel; stat' > parallel.rpt
yosys -p 'read_verilog -sv add_compare.sv; hierarchy -top add_split; synth -top add_split; stat' > split.rpt
预期结果:命令正常退出,生成 parallel.rpt 和 split.rpt,末尾均包含 Printing statistics 和对应顶层模块的单元统计。具体单元数量随 Yosys 版本和优化规则变化,不应预先假定哪种写法一定更小。
=== add_parallel ===
...
=== add_split ===
...
以上只是报告中需要查找的模块标题片段,并非完整或固定的工具输出。可以用下面的命令验证两个报告是否存在。
test -s parallel.rpt && test -s split.rpt && echo 'reports ready'预期输出:
reports ready接下来检查两份报告中的单元总数和类型分布。如果采用相同的 synth 流程,比较结果才有意义。不要把通用门数的减少直接写成标准单元面积减少百分之多少。
对比面积和最差时序余量
真实芯片设计应在目标标准单元库上完成映射,并由静态时序分析工具读取时钟、输入输出延迟、负载等约束。使用 FPGA 时则应比较 LUT、寄存器、DSP 等资源和实现后的时序报告,不能将 LUT 数当作 ASIC 的面积单位。
假设某 ASIC 项目采用同一个工艺角和约束,对三个功能等价但微架构不同的时序实现进行综合及静态时序分析,得到如下教学用假设数据。这些数值用于演示计算方法,不是上述 Yosys 命令产生的实测报告。
| 方案 | 总单元面积(μm²) | WNS(ns) | 延迟(周期) | 吞吐率(对/周期) |
|---|---|---|---|---|
| 并行基线 | 820 | -0.35 | 1 | 1 |
| 两级流水 | 990 | +0.42 | 2 | 1 |
| 单加法器共享 | 610 | +0.18 | 2 | 0.5 |
若原始面积为 820 μm²,流水化后的面积为 990 μm²,则面积增长率为:
与此同时,WNS 从 -0.35 ns 提高到 +0.42 ns,改善了 0.77 ns。两级流水方案在这个假设案例中满足 2.00 ns 的时钟约束,并保留每周期一对结果的稳态吞吐率,代价是增加一级延迟和约 20.7% 的单元面积。
共享方案相对基线的面积下降约 25.6%,但每周期只能完成半对结果。如果系统硬性要求每周期接收并处理一对新输入,则它即使 WNS 为正、面积最小,也是不合格的实现。
从时序报告定位真正的优化对象
当某个版本的 WNS 变差时,先查看最差路径的起点、终点和路径上的单元,再决定如何修改 RTL。假设原始路径报告显示 input_reg 到 result_reg 的路径中,进位传播链占用 1.15 ns,选择器占用 0.32 ns,其余逻辑与连线合计 0.41 ns,则需要判断进位链和选择器是否能够分别缩短。
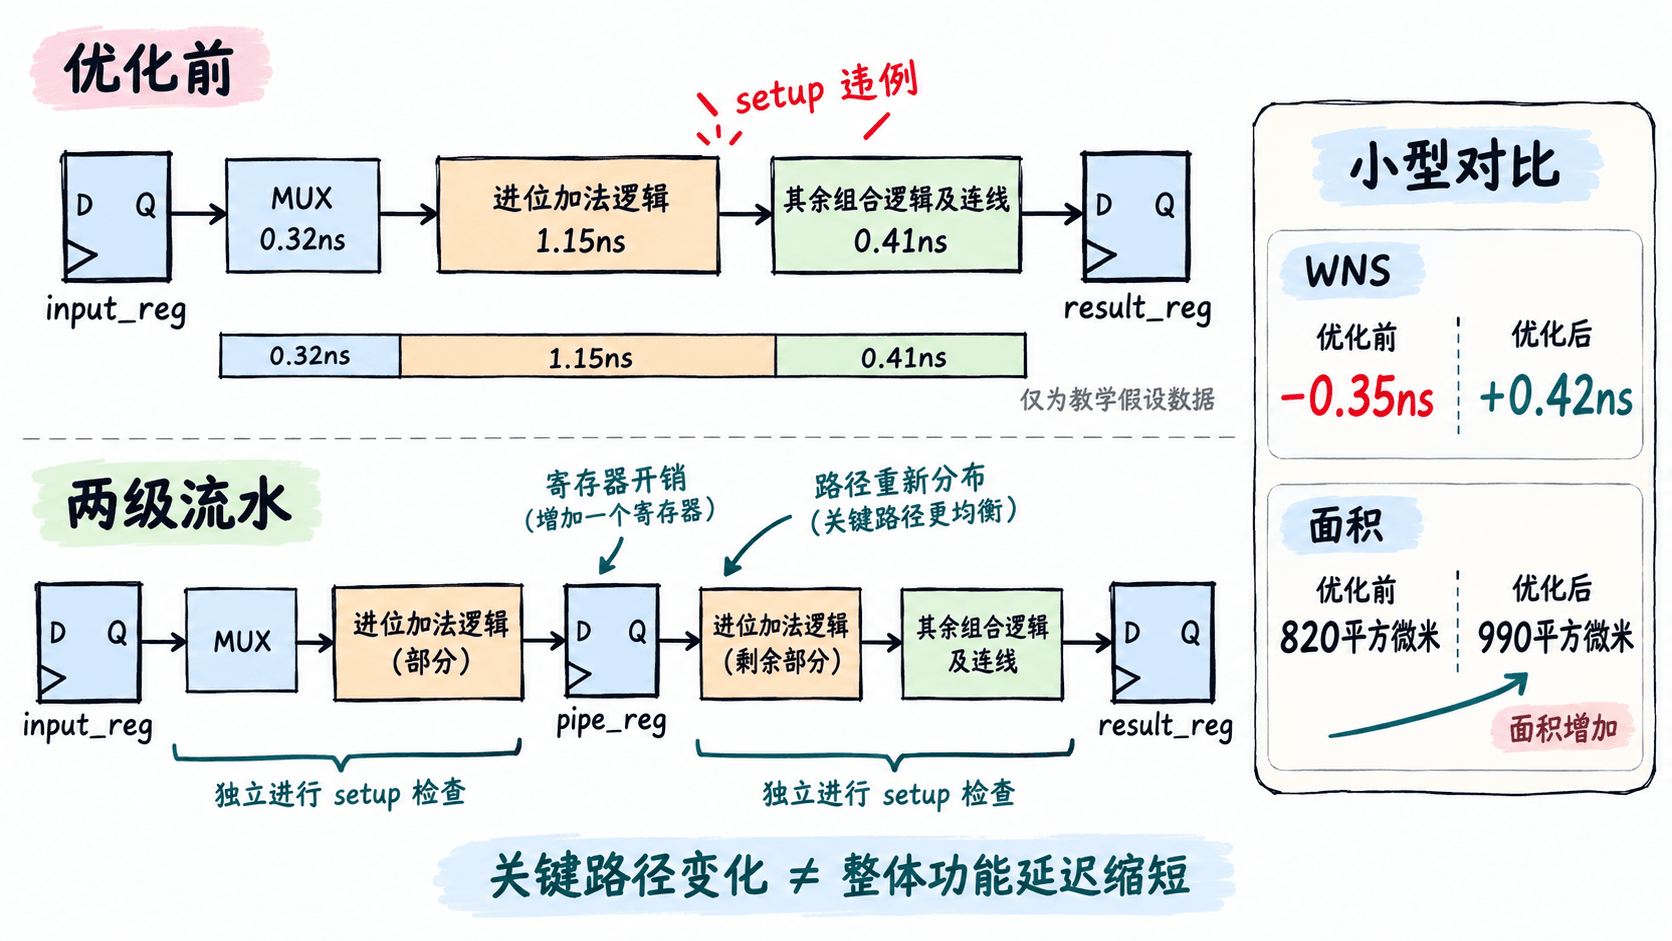
建议按以下顺序检查,避免盲目拆分代码:
- 检查时钟约束是否正确,确认关键路径没有被错误的假路径、多周期路径或缺失的输入输出约束掩盖。
- 阅读最差路径的起点与终点,区分寄存器到寄存器、输入到寄存器、寄存器到输出等路径类型。
- 按单元延迟和连线延迟区分瓶颈。若进位链占主导,考虑流水切分、改变算法或让综合器识别更合适的加法结构。
- 若选择器占主导,检查资源共享引入的多路选择级数,而不是单纯减少加法器数量。
- 修改后重新运行等价性检查、综合与 STA,同时检查 setup、hold、未约束路径及面积变化。
对于流水化版本,传统同周期组合等价检查通常不适用,应使用考虑延迟映射的时序等价验证或参考模型,核对输出数据、有效信号和事务顺序。对于资源共享版本,还要确认连续输入时是否发生丢数,以及接口是否允许降低吞吐率。
根据约束决定保留哪个版本
假设本项目规定总单元面积不超过 1050 μm²、时钟周期 2.00 ns、吞吐率至少每周期一对结果,并允许最多两个周期延迟。
按照前面的假设测量数据,并行基线存在负 WNS,不能通过时序验收;共享方案吞吐率只有 0.5 对/周期,不能通过性能验收;两级流水方案的面积为 990 μm²、WNS 为 +0.42 ns、吞吐率为 1 对/周期,因此在这三个候选方案中应选择两级流水。
如果产品允许每两周期完成一对结果,且面积上限收紧至 700 μm²,资源共享反而可能成为更合适的选择。设计结论必须跟随约束变化,不能把某种 RTL 写法永久标记为最优。
实际交付时,为每个候选方案保存 RTL 修订版本、综合脚本、时序约束、标准单元库版本、面积统计、关键路径报告和功能验证结果。只有这些条件一致,面积变化百分比和 WNS 差异才具有可复现的工程意义。