
FPGA 与数字 IC 设计 / 系统课时
识别高扇出与深层选择关键路径
识别高扇出与深层选择关键路径
综合后的 RTL 即使逻辑功能正确,也可能因为优先级条件链过长、宽比较器延迟过大,或控制信号驱动过多寄存器而无法满足时序。本课通过一份具体的时序报告和 SystemVerilog 示例,学习定位这些关键路径,并选择能够被综合和时序分析验证的修正方法。
学习目标
- 从寄存器到寄存器的时序报告中识别逻辑深度、扇出和布线延迟。
- 分辨优先级选择链、宽比较器和高扇出控制信号造成的不同瓶颈。
- 使用 RTL 重构和综合前后对比验证优化是否有效。
从时序报告判断真正的瓶颈
以下使用同步设计中的建立时间路径作为分析对象。假设时钟周期为 5.00 ns,时钟不确定度为 0.10 ns,建立时间为 0.10 ns,时钟到 Q 延迟为 0.20 ns,且暂不考虑时钟偏斜,则组合逻辑与数据布线的预算约为 4.60 ns。
如果组合逻辑和布线实际消耗 5.10 ns,则路径总到达时间为 5.30 ns,要求时间为 4.80 ns,建立时间裕量 Slack 为 -0.50 ns。负裕量说明该路径未满足时序约束。
阅读时序报告时,优先核对以下信息:
| 报告项目 | 示例 | 判断价值 |
|---|---|---|
| Startpoint | state_reg[0] | 确定路径起点 |
| Endpoint | data_reg[7] | 确定路径终点 |
| Logic Levels | 9 | 观察组合逻辑级数 |
| Fanout | 128 | 发现高负载网络 |
| Cell Delay | 3.60 ns | 衡量逻辑单元延迟 |
| Net Delay | 1.50 ns | 衡量连线与负载影响 |
| Slack | -0.50 ns | 判断违反程度 |
这是一份用于教学的简化报告,不代表所有综合工具的原始输出格式。实际报告应通过 report_timing 查看完整单元弧、网络延迟和逐级累积时间,扇出则结合 report_net_fanout 或工具对应的网络属性查询。
识别优先级条件链与深层选择器
连续的 if ... else if 通常表达优先级:多个条件同时成立时,只选择最前面的分支。综合工具可能将其映射为多级选择器、AOI/OAI 等复合门,也可能依据条件关系进行化简,因此不能简单认定每个 if 必然对应一级 MUX。
下面是一个完整的四路优先级选择模块:
module priority_select (
    input  logic       clk,
    input  logic       rst_n,
    input  logic [3:0] req,
    input  logic [7:0] d0, d1, d2, d3,
    output logic [7:0] result
);
    logic [7:0] selected;

    // 请求编号越小,优先级越高。
    always_comb begin
        selected = 8'h00;
        if (req[0])
            selected = d0;
        else if (req[1])
            selected = d1;
        else if (req[2])
            selected = d2;
        else if (req[3])
            selected = d3;
    end

    // 将组合选择结果锁存到输出寄存器。
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n)
            result <= 8'h00;
        else
            result <= selected;
    end
endmodule
这是可综合模块定义,需要连接时钟、复位和输入信号的测试平台才能仿真。可以使用测试向量 req=4'b1010、d0=8'h10、d1=8'h21、d2=8'h32、d3=8'h43,并在有效时钟上升沿后观察输出。
预期结果:由于 req[1] 和 req[3] 同时有效,而 req[1] 优先级更高,因此 result=8'h21。当 req=4'b0000 时,下一个有效上升沿后结果为 8'h00。
在综合结果中,重点检查 req 到 result 的控制路径是否出现连续 MUX 或逻辑复合门。优先级分支增加到 16 路或 32 路时,路径可能进一步加深。
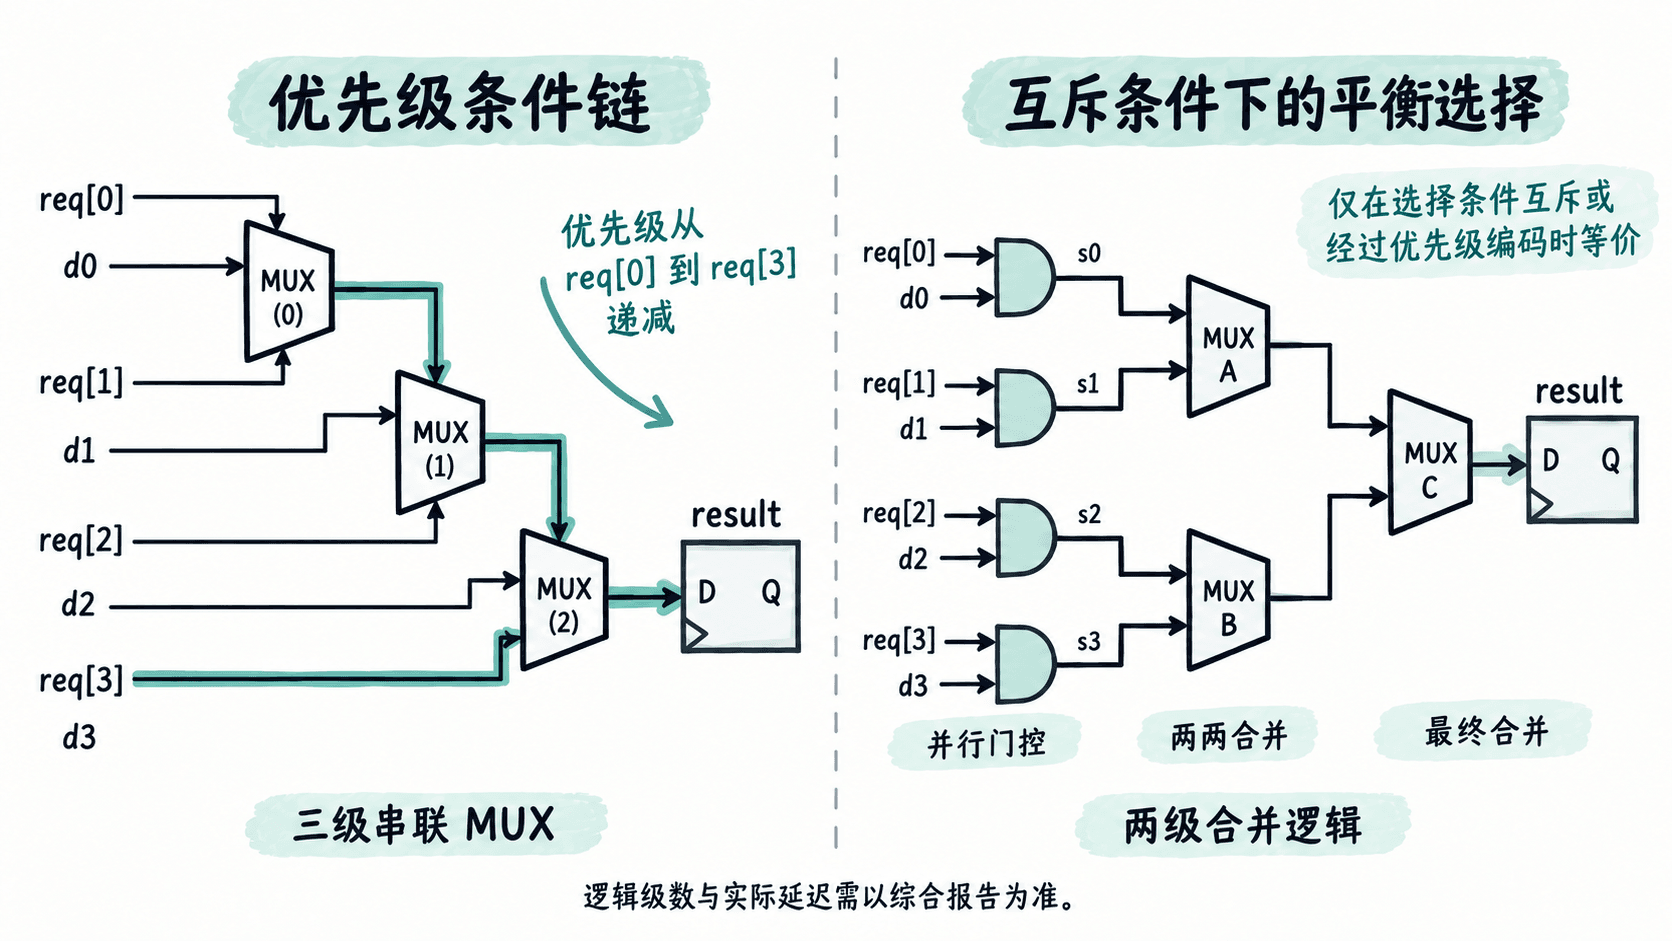
只有在请求互斥,或者先完成优先级编码后,才能考虑并行门控与平衡归约结构。直接把优先级链改写为按位或,遇到多个请求同时有效时会产生错误数据。例如 8'h21 | 8'h43 = 8'h63,明显不同于原来的 8'h21。
宽比较器与控制信号高扇出的影响
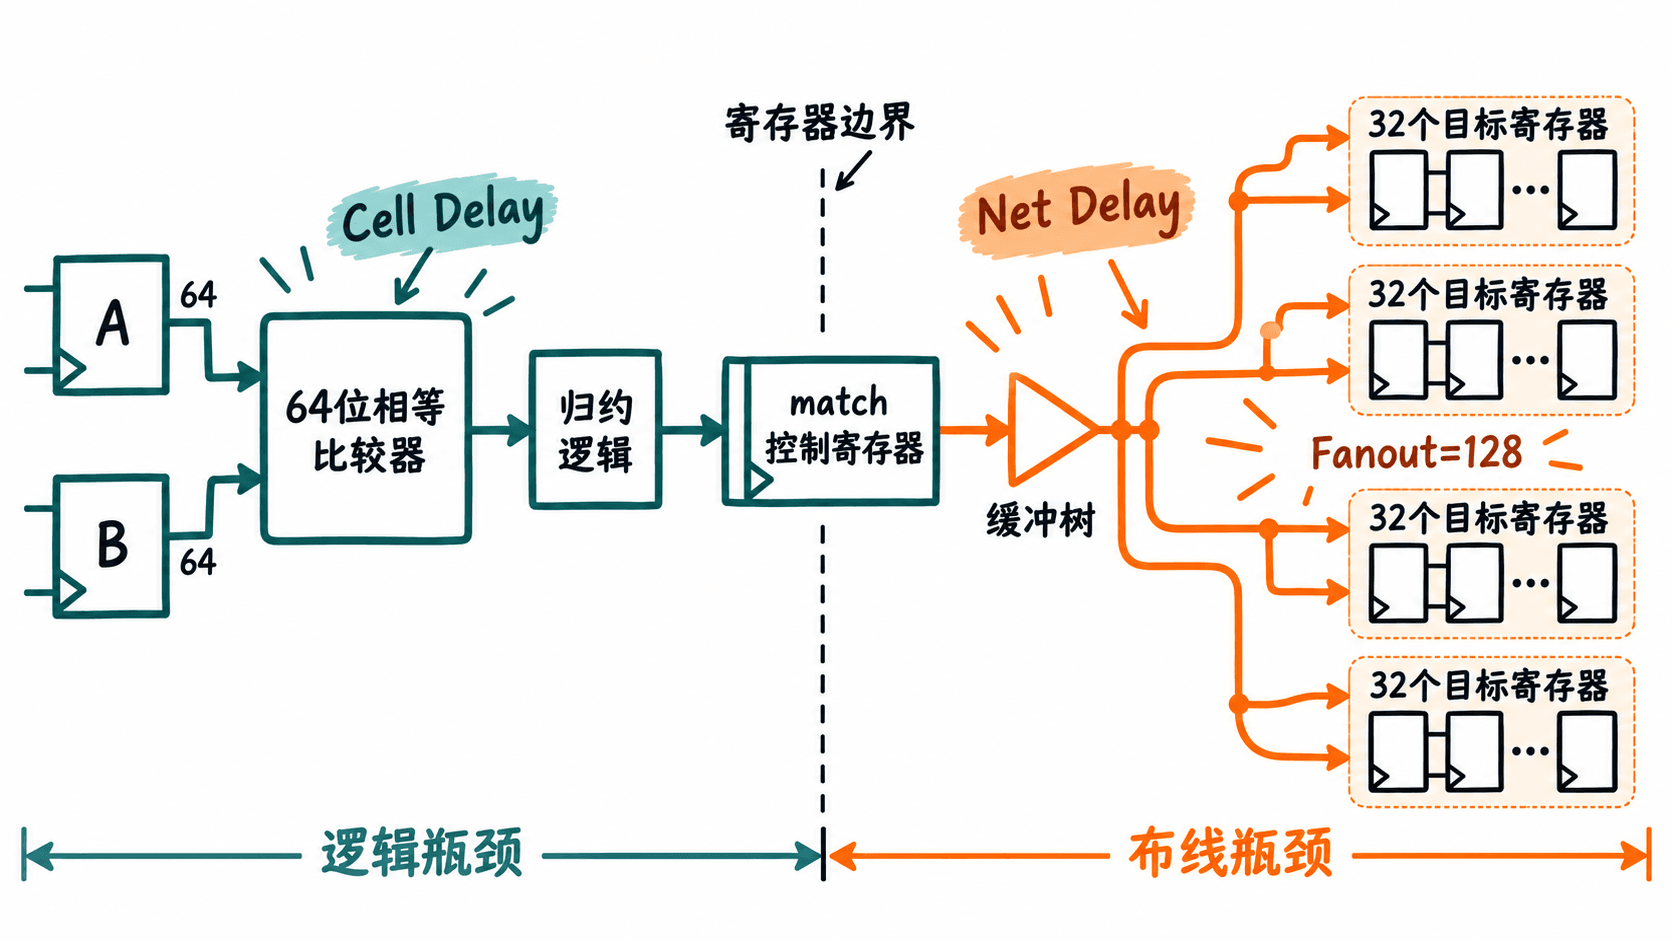
宽比较器会将大量位比较结果合并。例如 a == b 对 64 位数据进行相等判断,需要比较全部位并归约比较结果。它既可能造成较大的门级深度,也可能因为比较结果又控制大量寄存器而形成复合瓶颈。
假设 64 位比较器输出 match,用于控制 128 个寄存器的使能。在时序报告中可能观察到两类问题:
- 比较器路径过长:从参与比较的源寄存器出发,穿过 XNOR 或等效比较逻辑与归约网络,终止于受控数据寄存器。
- 控制网络扇出过高:从保存
match的寄存器出发,经过使能逻辑到达大量目标寄存器,出现缓冲单元和较高的网络延迟。
这两个问题不能混为一谈。前者主要关注布尔逻辑和归约结构,后者主要关注负载、物理分布、缓冲树以及寄存器使能实现。
RTL 中可以明确共享比较条件,避免重复书写难以识别的比较表达式,但综合器本身通常也能进行公共子表达式消除。不能仅凭源码里出现多次比较,就断言最终一定存在多个物理比较器。
对于高扇出控制,优先考虑让综合和物理优化工具执行缓冲插入、单元尺寸调整或适当的寄存器复制。若需要手工拆分控制寄存器,应确保复制寄存器在同一时钟下采样相同的控制值,并检查复位及控制信号的周期语义。
按瓶颈类型选择优化手段
假设同一设计中测得三条不满足约束的路径,可以按下表分别处理,而不是统一增加流水线。
| 关键路径 | 主要证据 | 优先尝试的修正 |
|---|---|---|
| 16 路优先级选择 | 多级MUX,Cell Delay占比高 | 检查互斥条件,使用平衡结构或分级仲裁 |
| 64 位比较与归约 | 比较和归约链占主要延迟 | 检查位宽需求、预解码或流水化 |
| 控制信号驱动128位 | Net Delay高、缓冲较多 | 扇出优化、寄存器复制、物理聚类 |
如果协议允许增加一个周期,可以在比较器输出后插入寄存器,将比较路径与后续控制路径分隔。但这会改变控制信号到达的时刻,所有受控数据与 valid 等标志必须同步对齐。
如果接口规定请求必须在当前周期生效,则不能直接插入流水线。应优先选择等价组合优化、减小不必要的比较位宽,或者优化实际的高负载网络。
使用综合和时序报告验证修正
下面以 Synopsys Design Compiler 的 Tcl 命令为例,演示在已经完成库加载、RTL读取、设计链接、时钟约束和综合之后,如何检查关键路径。命令适用于支持这些命令的 Design Compiler 环境,不应直接照搬到 Vivado 或 Quartus。
# 前提:current_design已设置,设计已综合并具有有效时序约束。
check_timing
report_timing -delay_type max -max_paths 10 -path_type full > timing_before.rpt
report_constraint -all_violators > violations_before.rpt
report_area > area_before.rpt
这些命令不会自动执行 RTL 修正。预期结果是在当前工作目录生成三个报告文件,其中 timing_before.rpt 包含最多10条最大延迟路径;若没有违例,violations_before.rpt 可能不包含违规路径。具体文本随工具版本、工艺库和约束变化。
随后按同一套库、时钟、输入输出约束和综合设置处理修改后的 RTL,并将报告保存为 timing_after.rpt、violations_after.rpt 和 area_after.rpt。必要时进一步比较布局布线后的时序报告,避免只依据综合阶段的估计布线得出结论。
可以用以下教学算例理解验收标准:
| 指标 | 修正前 | 修正后 |
|---|---|---|
| 最差 Slack | -0.50 ns | +0.12 ns |
| 最差路径 Cell Delay | 3.60 ns | 2.90 ns |
| 最差路径 Net Delay | 1.50 ns | 1.60 ns |
| 组合单元面积 | 1000 | 1060 |
表中数据是假设的对比结果,不是上面命令的实际输出。修正后最差 Slack 转正,说明所报告的建立时间检查达到约束;组合单元面积增加 6%,体现出可能的面积代价。真实验收还需确认所有相关时钟组的最大延迟检查、保持时间检查及功能等价性。
实际项目中,应保存每次修改对应的 RTL 版本、约束、综合日志和时序报告。如果负裕量从 -0.50 ns 改善至 -0.20 ns,说明方向可能有效,但仍未达到要求;如果单条路径改善后另一条路径成为最差路径,则必须继续检查全设计的 WNS、TNS 和违规终点数量。
定位高扇出与深层选择关键路径时,最终判断依据是完整路径上的单元延迟、网络延迟和修正后的时序收敛结果。任何改变优先级、握手周期或寄存器控制行为的优化,都必须先证明功能正确,再接受其时序收益。