
FPGA 与数字 IC 设计 / 系统课时
在长逻辑链中插入流水线寄存器
在长逻辑链中插入流水线寄存器
当多个加法器或比较器连续串接时,组合逻辑可能无法在一个时钟周期内完成。本课以四个 8 位无符号数求和为例,将三级串行加法拆成两级流水线,给出可综合的 SystemVerilog 实现,并验证流水前后的数值等价、延迟和吞吐率。
学习目标
- 根据时钟周期与路径延迟判断是否需要插入流水线寄存器。
- 实现两级加法流水线,正确处理数据位宽、有效标志和复位。
- 使用仿真检查流水线的结果、周期延迟与连续输入能力。
找到需要切断的组合逻辑路径
假设设计的时钟频率为 200 MHz,对应周期为 5 ns。四个 8 位输入需要求出最大为 1020 的总和,因此结果必须使用 10 位,不能直接用 8 位保存。
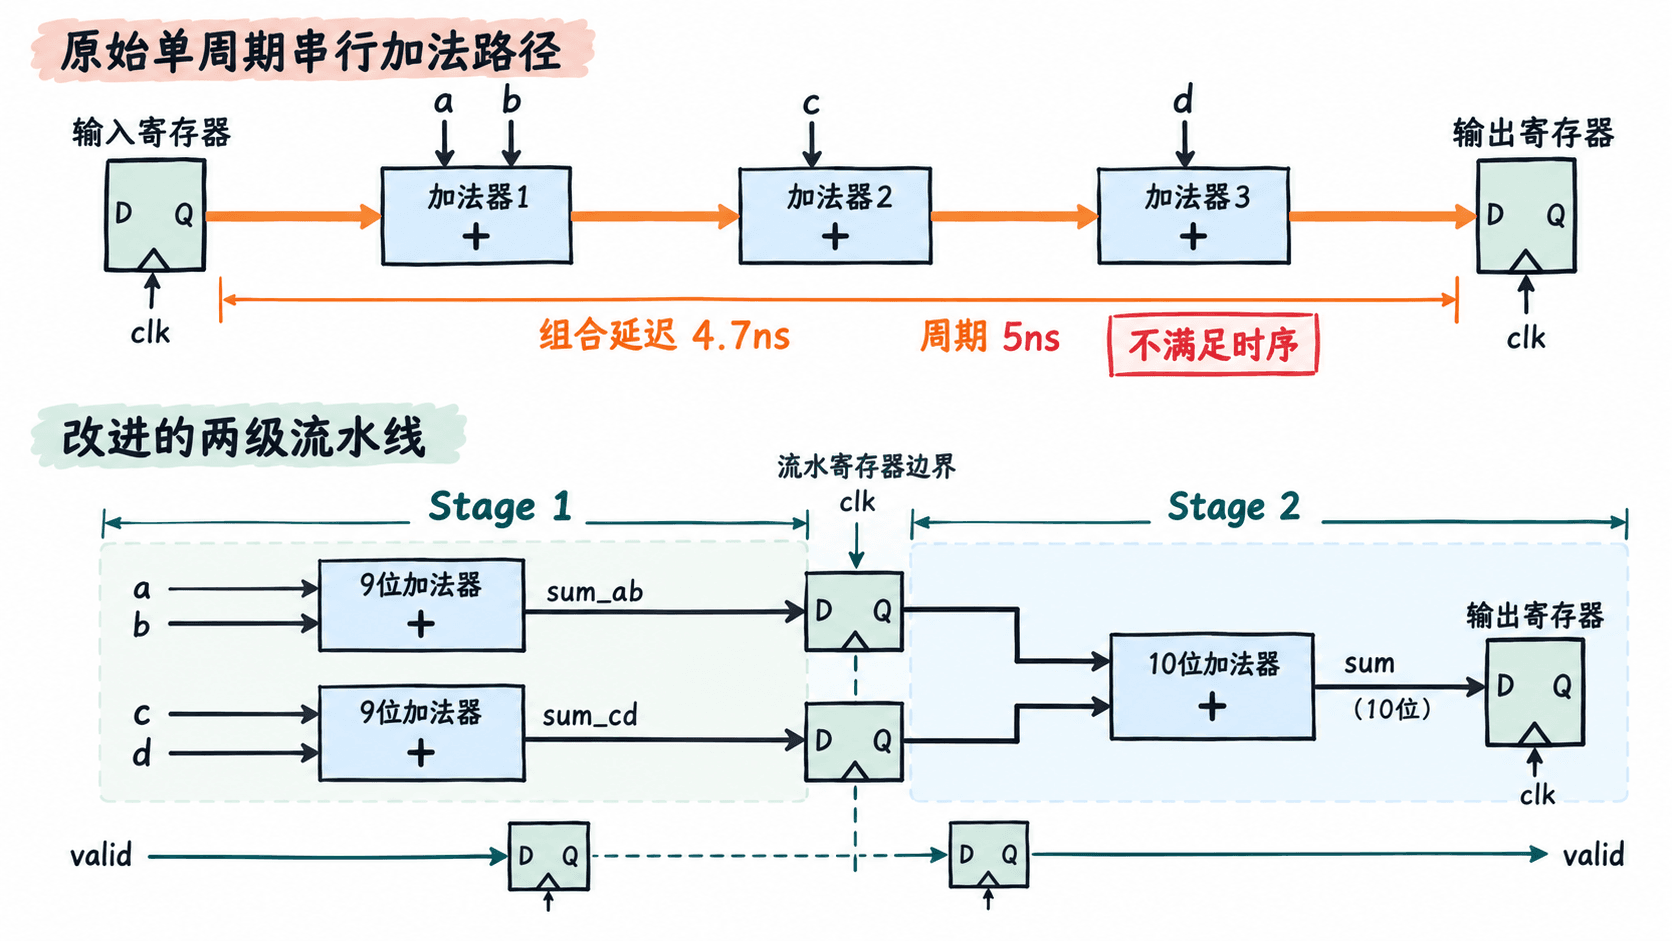
原始设计把三个加法操作放在同一条组合路径上:先计算 a+b,再加 c,最后加 d。为了便于估算,假设综合后的三级加法逻辑每级延迟约 1.4 ns,连线和其他组合逻辑合计 0.5 ns。
| 时序项目 | 预算或估算值 |
|---|---|
| 时钟周期 | 5.0 ns |
| 发射寄存器 clk-to-Q | 0.3 ns |
| 三级加法与连线 | 4.7 ns |
| 捕获寄存器建立时间 | 0.3 ns |
| 时钟不确定度 | 0.2 ns |
| 总需求时间 | 5.5 ns |
按这个简化预算,路径比时钟周期超出 0.5 ns,建立时间裕量为 -0.5 ns。以上延迟是教学假设,不是某款 FPGA 或标准单元库的固定数据。真实项目应通过综合与布局布线后的静态时序分析确认最差路径。
如果目标是保留 200 MHz 时钟,可以把加法链拆成两段:第一级并行计算 a+b 和 c+d;第二级把两项部分和相加。这样每个流水阶段只经过一级加法逻辑。
实现两级加法流水线
下面使用 SystemVerilog 编写完整模块。约定 valid_i 在时钟上升沿为 1 时接收一组输入;模块不支持背压,输入可连续有效,输出也可连续有效。
第一级同时计算两组 9 位部分和,并寄存为 sum_ab_q 和 sum_cd_q。第二级将它们扩展到 10 位后相加,写入 sum_o。两个有效标志寄存器分别记录数据在流水线中的位置。
module pipelined_sum4 (
    input  logic       clk,
    input  logic       rst_n,
    input  logic       valid_i,
    input  logic [7:0] a, b, c, d,
    output logic       valid_o,
    output logic [9:0] sum_o
);
    logic [8:0] sum_ab_q, sum_cd_q;
    logic       valid_s1_q;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            sum_ab_q  <= '0;
            sum_cd_q  <= '0;
            valid_s1_q <= 1'b0;
            sum_o     <= '0;
            valid_o   <= 1'b0;
        end else begin
            // 第一级:先扩展位宽,避免8位加法溢出
            sum_ab_q <= {1'b0, a} + {1'b0, b};
            sum_cd_q <= {1'b0, c} + {1'b0, d};
            valid_s1_q <= valid_i;

            // 第二级:使用上一拍寄存的两项部分和
            sum_o   <= {1'b0, sum_ab_q} + {1'b0, sum_cd_q};
            valid_o <= valid_s1_q;
        end
    end
endmodule
这里利用非阻塞赋值 <= 的时序语义:同一个上升沿中,第二级读取的是第一级寄存器的旧值,而不是本次刚计算的新值。两个阶段因此不会重新合并成一条长组合路径。
第一级寄存器每拍都会更新,包括 valid_i=0 的周期。无效周期的数据没有业务意义,接收端必须只在 valid_o=1 时使用 sum_o。复位清零两个有效标志,避免复位后把无效数据当作正式结果。
理解新增的周期延迟
设输入数据 A 在上升沿 E1 被接受,第一级会在 E1 更新部分和;第二级在 E2 使用这些部分和并更新输出。因此,从输入采样到最终输出寄存器更新,需要经过两个寄存器边沿,E2 后 valid_o 为 1。
若把输入采样边沿定义为第 0 拍,这一结果在下一拍边沿出现,常称为一个完整时钟周期的输入到输出延迟。不要把两个流水阶段误读为输入采样后还要等待两个额外周期。
| 上升沿 | 输入采样 | 第一级寄存器更新 | 第二级输出更新 |
|---|---|---|---|
| E1 | A | A 的部分和 | 无效 |
| E2 | B | B 的部分和 | A 的总和 |
| E3 | C | C 的部分和 | B 的总和 |
| E4 | 无效 | 无效数据 | C 的总和 |
| E5 | 无效 | 无效数据 | 无效 |
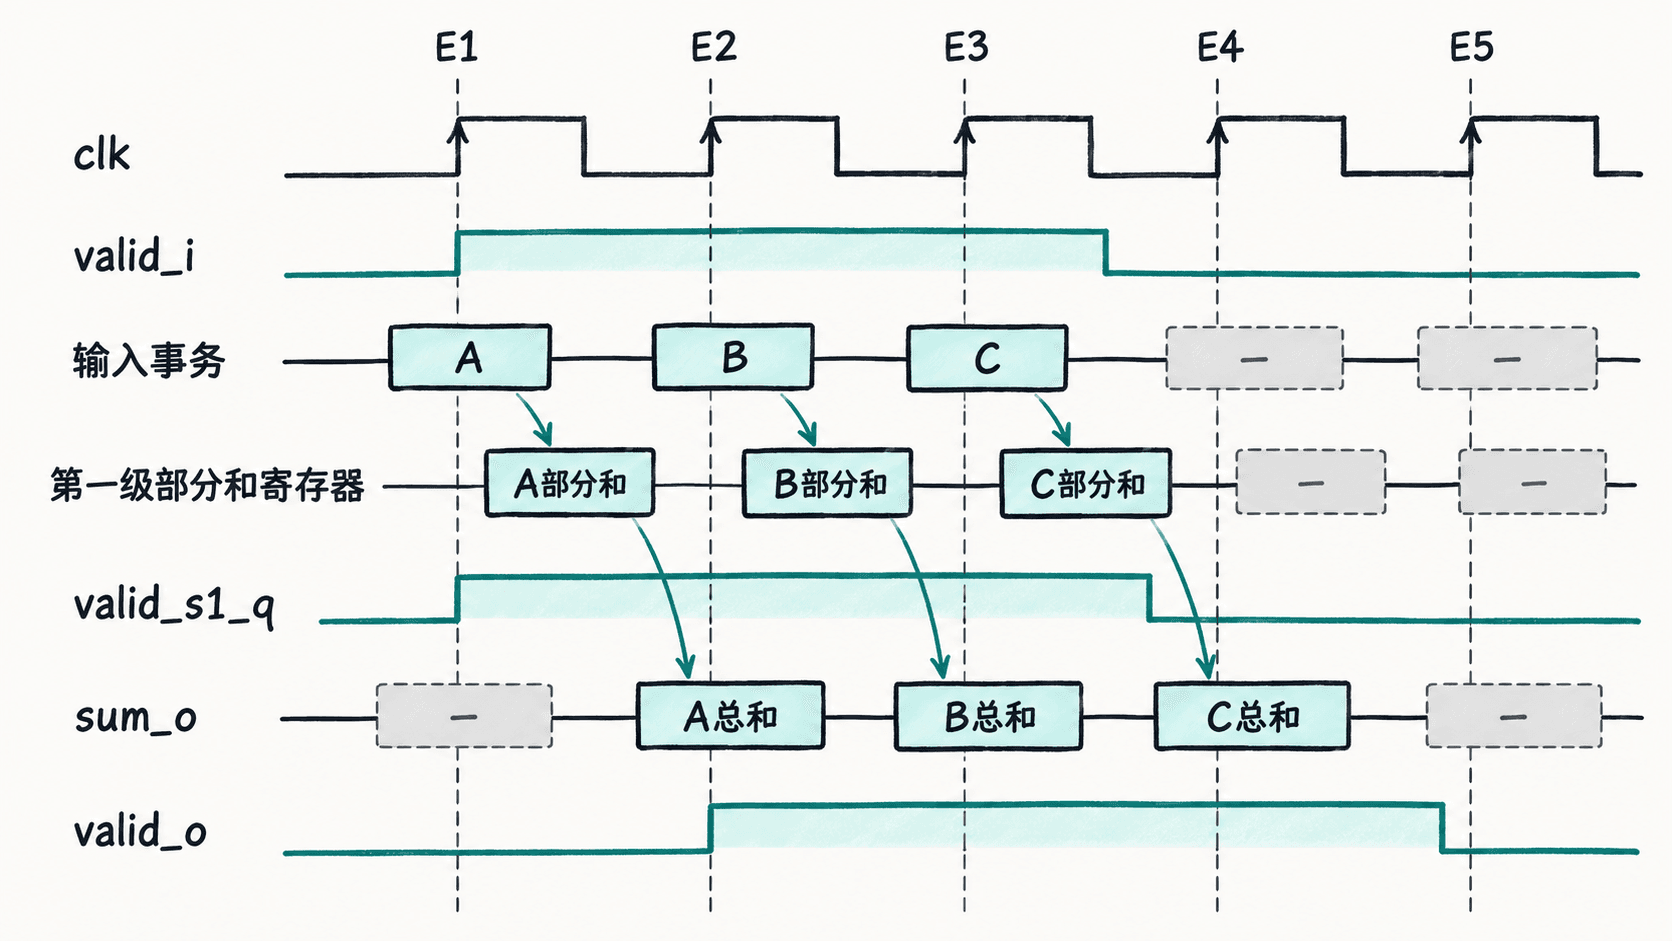
流水线改善的是单级最长组合路径,而不是单笔输入从采样到输出的总延迟。进入稳定状态后,本例仍能做到每个时钟周期接受一组输入、输出一组结果,吞吐率上限为 200 M组/秒,前提是时序收敛且上下游能持续提供和接收数据。
用仿真检查功能等价与数据对齐
以下测试平台适用于支持 SystemVerilog 的仿真器,依赖前面的 pipelined_sum4 模块。它连续送入三组数据,再插入无效周期,检查结果是否按顺序出现。期望值分别为 10、100 和 1020。
module tb;
    logic clk = 0;
    logic rst_n = 0;
    logic valid_i = 0;
    logic [7:0] a = 0, b = 0, c = 0, d = 0;
    logic valid_o;
    logic [9:0] sum_o;
    int received = 0;

    pipelined_sum4 dut (.*);
    always #5 clk = ~clk;

    // 在下降沿改变激励,避免与采样上升沿竞争
    task automatic send(input logic v,
                        input logic [7:0] x, y, z, w);
        @(negedge clk);
        valid_i = v;
        a = x; b = y; c = z; d = w;
    endtask

    // 在非采样边沿检查寄存后的稳定输出
    always @(negedge clk) begin
        if (rst_n && valid_o) begin
            case (received)
                0: assert (sum_o == 10) else $fatal(1, "A mismatch");
                1: assert (sum_o == 100) else $fatal(1, "B mismatch");
                2: assert (sum_o == 1020) else $fatal(1, "C mismatch");
                default: $fatal(1, "Unexpected output");
            endcase
            $display("result[%0d]=%0d", received, sum_o);
            received++;
        end
    end

    initial begin
        repeat (2) @(negedge clk);
        rst_n = 1;
        send(1, 1, 2, 3, 4);
        send(1, 10, 20, 30, 40);
        send(1, 255, 255, 255, 255);
        send(0, 0, 0, 0, 0);
        repeat (2) @(negedge clk);
        if (received != 3) $fatal(1, "Missing output");
        $display("PASS");
        $finish;
    end
endmodule
预期输出(不含仿真器自身的结束信息):
result[0]=10
result[1]=100
result[2]=1020
PASS
这个测试能够发现结果顺序错误、位宽截断和一部分 valid 错拍问题。进一步验收时,应增加随机输入与空泡周期,用参考模型计算 int'(a)+int'(b)+int'(c)+int'(d),并以事务队列按有效输出顺序逐项比较。
验证时序收益并避开常见陷阱
将流水线代码综合后,分别检查输入寄存器到第一级寄存器、以及第一级到第二级寄存器的建立时间路径。对前述 5 ns 教学预算,假设每条路径只有一级 1.4 ns 加法与 0.3 ns 连线,再计入 clk-to-Q 0.3 ns、建立时间 0.3 ns 和时钟不确定度 0.2 ns,则单级总需求约 2.5 ns,理论裕量约 2.5 ns。
实际验证不能只看 RTL 中是否增加了寄存器,还要确认工具没有因约束缺失、逻辑重组或外部路径预算而留下新的关键路径。时序报告至少检查时钟约束、起终点、逻辑深度、最差建立时间裕量和寄存器数量。
常见错误有三种:
- 只寄存一条分支:若
a+b延迟一拍,而c+d仍使用当前输入,结果就混合了不同事务。两条分支必须在同一个阶段边界同步寄存。 - 忘记扩展位宽:8 位加法最大只能表示 255,
255+255必须先扩展到 9 位;两项 9 位部分和相加必须使用 10 位结果。 - 插入数据寄存器却不延迟有效标志:数据 A 在 E2 才成为输出,而
valid_o若直接连接valid_i,就可能提前声明结果有效。
流水线切分完成后,要同时满足三项验收条件:各级时序收敛、有效事务的计算结果与原组合表达式相同、事务顺序及输出有效周期与接口约定一致。满足这三项,新增寄存器才是真正有效的时序优化。