
React / 系统课时
日志、健康检查与监控
日志、健康检查与监控
本课为已部署的全栈应用建立最小可用的可观测闭环:每个请求都有结构化日志和追踪标识,运维系统可以区分进程存活与依赖就绪,错误不会只停留在浏览器中,并能通过基础指标判断请求量、失败数、延迟和内存变化。
学习目标
- 输出可检索的 JSON 请求日志与错误日志
- 实现存活检查、就绪检查和统一错误响应
- 暴露基础运行指标并设计可执行的告警规则
建立最小观测闭环
一次线上请求至少要留下四类信息:Nginx 访问日志说明请求是否到达入口,应用日志说明业务处理过程,健康检查说明实例能否接收流量,指标则用于观察一段时间内的趋势。单独拥有其中任意一项,都不足以快速区分网络、代理、应用和依赖故障。
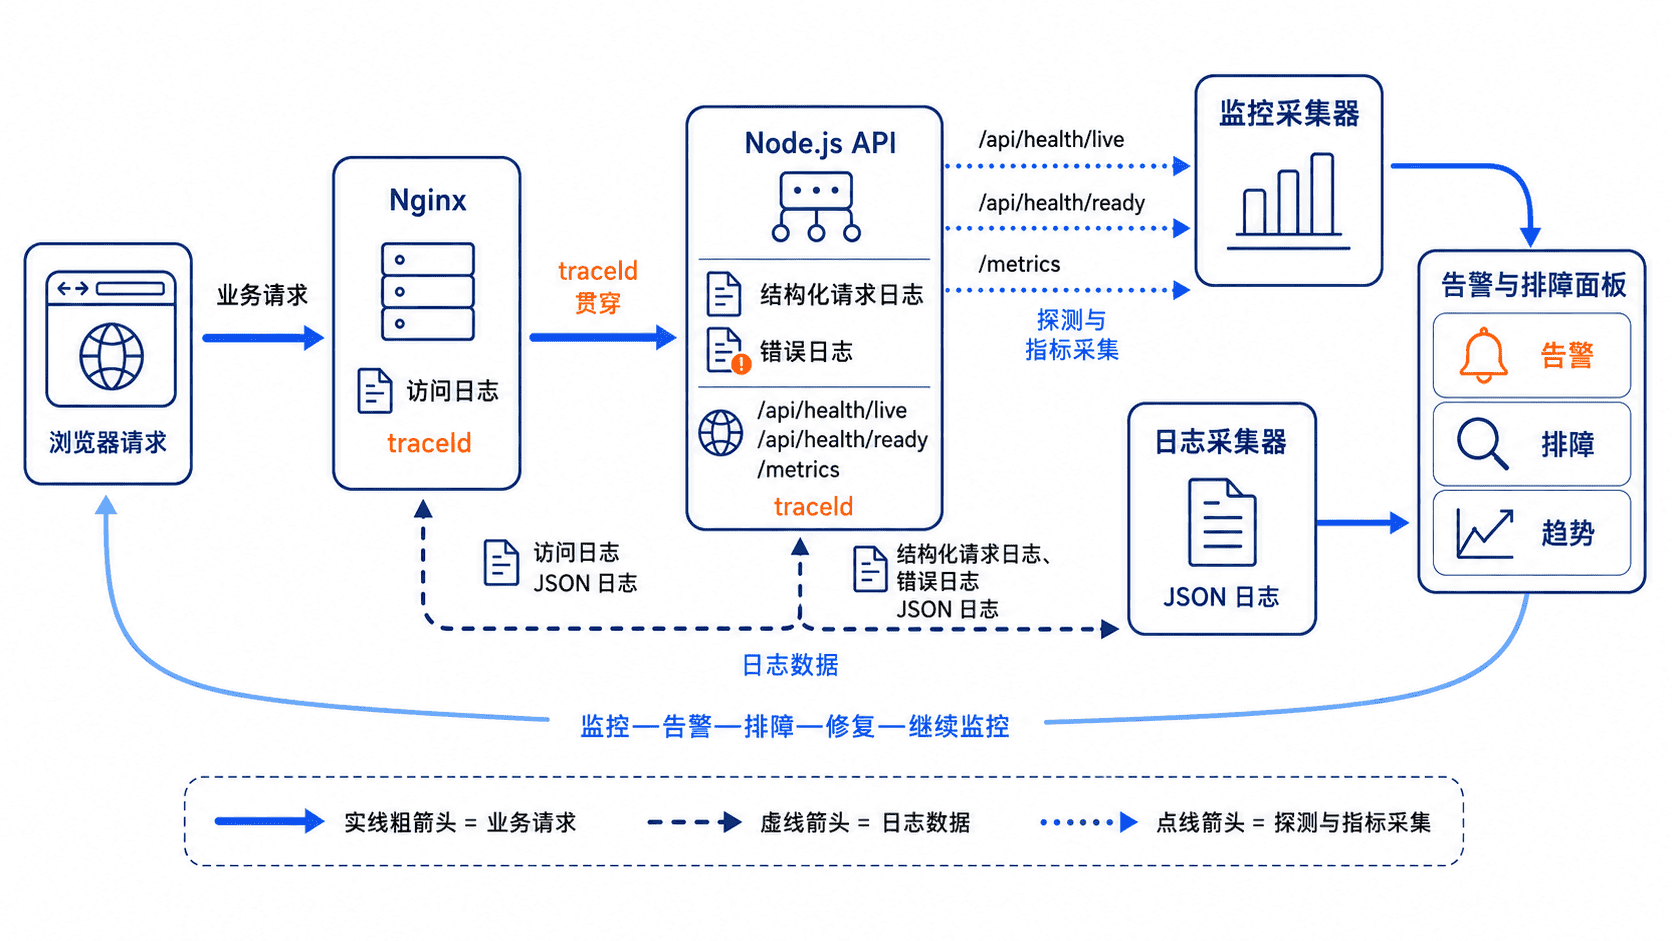
日志字段应保持稳定,至少包含时间、级别、事件、请求方法、路径、状态码、耗时和 traceId。健康检查则拆成两个端点:存活检查只回答进程是否还能响应;就绪检查还要判断数据库等关键依赖是否可用,失败时返回 503,阻止负载均衡继续分配新流量。
实现日志、健康检查与指标
下面示例使用 Express,保存为 server.mjs。它不依赖专用监控 SDK,先用标准输出承载 JSON 日志,并用文本端点暴露最小指标;生产环境可再由日志采集器和指标采集器接管。
import express from "express";
import { randomUUID } from "node:crypto";

const app = express();
const port = Number(process.env.PORT ?? 3000);
let httpRequestsTotal = 0;
let httpErrorsTotal = 0;

app.use(express.json());

// 统一接收或生成 traceId,让入口日志与应用日志能够关联。
app.use((req, res, next) => {
  const startedAt = process.hrtime.bigint();
  const traceId = req.get("x-trace-id") || randomUUID();

  res.locals.traceId = traceId;
  res.set("x-trace-id", traceId);
  httpRequestsTotal += 1;

  // 响应结束后再记录最终状态码与耗时。
  res.on("finish", () => {
    const durationMs =
      Number(process.hrtime.bigint() - startedAt) / 1_000_000;

    console.log(
      JSON.stringify({
        timestamp: new Date().toISOString(),
        level: "info",
        event: "http_request",
        traceId,
        method: req.method,
        path: req.originalUrl,
        status: res.statusCode,
        durationMs: Number(durationMs.toFixed(2)),
      }),
    );
  });

  next();
});

function dependenciesReady() {
  // 示例用环境变量模拟依赖状态,生产中应替换为轻量数据库或缓存探测。
  return process.env.DATABASE_READY !== "false";
}

app.get("/api/health/live", (_req, res) => {
  res.json({ status: "UP" });
});

app.get("/api/health/ready", (_req, res) => {
  const ready = dependenciesReady();
  res.status(ready ? 200 : 503).json({
    status: ready ? "READY" : "NOT_READY",
    dependencies: { database: ready ? "UP" : "DOWN" },
  });
});

// 暴露机器可解析的基础指标,不把监控逻辑混入业务路由。
app.get("/metrics", (_req, res) => {
  const memory = process.memoryUsage();
  const metrics = [
    `process_uptime_seconds ${process.uptime().toFixed(0)}`,
    `http_requests_total ${httpRequestsTotal}`,
    `http_errors_total ${httpErrorsTotal}`,
    `process_resident_memory_bytes ${memory.rss}`,
  ];

  res.type("text/plain").send(`${metrics.join("\n")}\n`);
});

app.get("/api/demo-error", () => {
  throw new Error("demo failure");
});

// 错误详情只写服务端日志,客户端只接收稳定错误码和 traceId。
app.use((error, _req, res, _next) => {
  httpErrorsTotal += 1;
  const traceId = res.locals.traceId;

  console.error(
    JSON.stringify({
      timestamp: new Date().toISOString(),
      level: "error",
      event: "unhandled_error",
      traceId,
      message: error.message,
      stack: error.stack,
    }),
  );

  res.status(500).json({
    code: "INTERNAL_ERROR",
    message: "Internal server error",
    traceId,
  });
});

app.listen(port, "127.0.0.1", () => {
  console.log(
    JSON.stringify({
      timestamp: new Date().toISOString(),
      level: "info",
      event: "server_started",
      port,
    }),
  );
});
预期结果:服务启动后监听本机端口,所有请求输出单行 JSON 日志,健康检查和指标端点可通过后续命令验证。
请求日志在响应结束后记录,因此状态码和耗时是最终值。错误堆栈只进入服务端日志,客户端只得到稳定错误码与 traceId,既便于关联排查,也避免泄露内部路径和实现细节。安装依赖并启动服务:
# 在项目目录安装依赖并启动服务。
npm install express
node server.mjs
预期输出:
{"timestamp":"<TIME>","level":"info","event":"server_started","port":3000}<TIME> 是实际启动时间。服务只监听 127.0.0.1,应由同机 Nginx 访问,而不是直接暴露到公网。
验证健康检查、错误与指标
先验证正常状态。存活端点用于判断进程是否响应,就绪端点用于决定实例是否可以接收业务流量。
# 分别检查进程存活和关键依赖就绪。
curl -i http://127.0.0.1:3000/api/health/live
curl -i http://127.0.0.1:3000/api/health/ready
预期输出:
HTTP/1.1 200 OK
{"status":"UP"}

HTTP/1.1 200 OK
{"status":"READY","dependencies":{"database":"UP"}}
再以依赖不可用状态启动另一个测试实例,确认就绪检查能够返回 503,而存活检查仍保持 200:
# 后台启动一个依赖不可用的临时实例,验证 503 后立即停止。
DATABASE_READY=false PORT=3001 node server.mjs > /tmp/health-test.log 2>&1 &
TEST_PID=$!
sleep 1
curl -i http://127.0.0.1:3001/api/health/ready
kill "$TEST_PID"
预期输出:
HTTP/1.1 503 Service Unavailable
{"status":"NOT_READY","dependencies":{"database":"DOWN"}}
验证统一错误响应和服务端错误记录:
# 主动制造一次受控错误,检查响应与日志关联。
curl -i http://127.0.0.1:3000/api/demo-error
预期输出:
HTTP/1.1 500 Internal Server Error
{"code":"INTERNAL_ERROR","message":"Internal server error","traceId":"<ID>"}
控制台同时会输出一条 unhandled_error JSON 日志和一条状态码为 500 的 http_request 日志,两条记录使用相同的 <ID>。最后读取指标:
# 读取文本指标并确认计数器可解析。
curl -s http://127.0.0.1:3000/metrics
预期输出:
process_uptime_seconds <SECONDS>
http_requests_total <COUNT>
http_errors_total <COUNT>
process_resident_memory_bytes <BYTES>
这些值会随运行时间和请求数量变化。验收重点是字段持续存在、数值可解析,并且制造一次错误后 http_errors_total 增加。
配置 Nginx JSON 访问日志
应用日志只能证明请求进入了 Node.js。还需要在 Nginx 层记录入口状态、上游耗时和应用返回的追踪标识。log_format 可以定义访问日志字段,access_log 决定写入文件和使用的格式。:contentReference[oaicite:4]{index=4}
在 Nginx 的 http 上下文中加入日志格式,并在站点的 server 中启用它:
# log_format 必须放在 Nginx 的 http 上下文中。
log_format json_main escape=json
    '{"time":"$time_iso8601",'
    '"remoteAddr":"$remote_addr",'
    '"request":"$request",'
    '"status":$status,'
    '"requestTime":$request_time,'
    '"upstreamTime":"$upstream_response_time",'
    '"traceId":"$upstream_http_x_trace_id"}';

server {
    listen 443 ssl;
    server_name app.example.com;

    access_log /var/log/nginx/app.access.json json_main;
    error_log /var/log/nginx/app.error.log warn;

    location /api/ {
        proxy_pass http://127.0.0.1:3000;
        proxy_set_header X-Trace-Id $request_id;
    }
}
预期结果:该片段依赖站点已有的证书、静态资源和其他代理配置,属于片段示例。生效后每个请求写入一行 JSON;traceId 取自应用响应头,便于把入口日志与应用日志关联。检查并重载配置:
# 配置校验通过后重载,并发送一次请求生成访问日志。
sudo nginx -t
sudo systemctl reload nginx
curl -s https://app.example.com/api/health/live > /dev/null
sudo tail -n 1 /var/log/nginx/app.access.json
预期输出:
{"time":"<TIME>","remoteAddr":"<IP>","request":"GET /api/health/live HTTP/1.1","status":200,"requestTime":<SECONDS>,"upstreamTime":"<SECONDS>","traceId":"<ID>"}实际路径、耗时、IP 和追踪标识会不同。若 traceId 为空,检查应用是否始终返回 X-Trace-Id,以及代理是否经过了包含该日志格式的站点。
设置告警与排查顺序
基础监控不需要一开始就堆积大量指标,应先覆盖会直接影响用户的信号:就绪检查持续失败、5xx 比例升高、请求耗时明显上升、进程内存持续逼近限制。阈值应结合正常流量基线设置,避免把单次超时直接当作事故。
排查时按请求链路从外向内推进:先确认域名和 HTTPS,再看 Nginx 状态码与上游耗时,然后用 traceId 查应用请求日志和错误日志,最后检查数据库、缓存等依赖。这样可以快速判断故障发生在入口、代理、应用还是下游依赖,而不是直接重启所有服务。
常见错误包括:让存活检查执行重查询导致探测本身拖垮数据库;就绪失败仍返回 200;把完整错误堆栈返回浏览器;日志字段随代码分支变化;只记录错误而不记录正常请求耗时。修复原则是让探测轻量、字段稳定、错误可关联、指标可聚合。