
可观测性与稳定性 / 系统课时
使用手工埋点创建业务 Span
使用手工埋点创建业务 Span
自动埋点擅长生成 HTTP、RPC、数据库等技术 Span,但它不知道“库存预留”“风控决策”“订单确认”这些业务边界。本篇用 Java API 创建一个业务 Span,并说明命名、父子关系、错误记录和切分粒度,让 Trace 既能解释业务过程又不过度膨胀。
学习目标
- 使用
Tracer创建并正确结束业务 Span - 让手工 Span 继承当前上下文并成为正确的子 Span
- 判断哪些业务步骤值得独立成 Span,避免低价值过度切分
先选对业务边界
一个操作适合成为独立 Span,通常因为它有明确业务含义、可感知的耗时或失败结果,并且你希望单独查询它。例如“预留库存”值得观察成功率和延迟,而“读取一个局部变量”“拼接字符串”通常不值得。
Span 名称应稳定描述操作类型,例如 checkout.reserve_inventory。不要把订单号、用户 ID 或时间戳拼进名称,否则同一种操作会产生大量不同名称,难以聚合;实例信息放在属性中更合适。
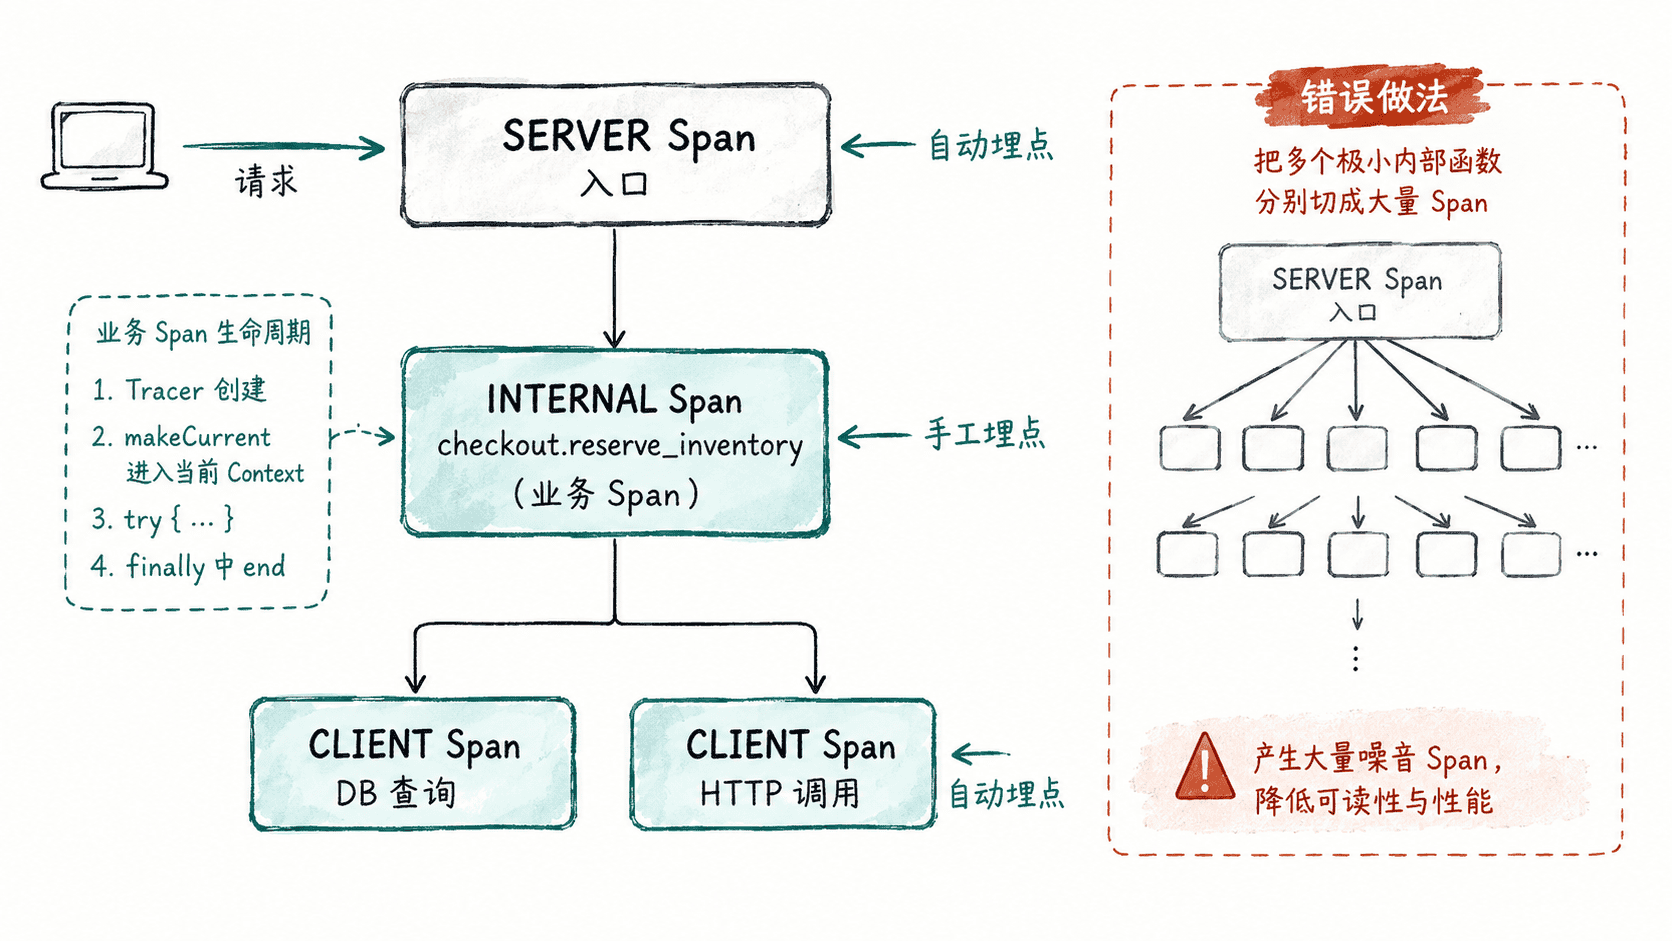
用 Tracer 创建并进入当前上下文
下面是片段示例。它依赖应用已经完成 OpenTelemetry SDK 或 Java Agent 初始化,并把可用的 Tracer 注入当前类;reserveInDatabase 代表已有的业务实现。
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.SpanKind;
import io.opentelemetry.api.trace.StatusCode;
import io.opentelemetry.api.trace.Tracer;
import io.opentelemetry.context.Scope;

public final class CheckoutService {
    private final Tracer tracer;

    public CheckoutService(Tracer tracer) {
        this.tracer = tracer;
    }

    public void reserveInventory(String orderId) {
        Span span = tracer.spanBuilder("checkout.reserve_inventory")
                .setSpanKind(SpanKind.INTERNAL)
                .setAttribute("order.id", orderId)
                .startSpan();

        try (Scope scope = span.makeCurrent()) {
            // 当前作用域内创建的后续 Span 会自动继承这个业务 Span。
            reserveInDatabase(orderId);
        } catch (RuntimeException e) {
            // 失败既记录异常事件,也明确标记当前业务操作失败。
            span.recordException(e);
            span.setStatus(StatusCode.ERROR, "inventory reservation failed");
            throw e;
        } finally {
            // 无论成功或异常都结束 Span,避免产生长期未结束的遥测数据。
            span.end();
        }
    }

    private void reserveInDatabase(String orderId) {
        // 这里调用真实的库存持久化逻辑。
    }
}
预期结果
当 reserveInventory 在已有请求 Span 的上下文中执行时,后端应看到名为 checkout.reserve_inventory 的 INTERNAL 子 Span。
Span 包含 order.id 属性;发生 RuntimeException 时包含异常记录并标记为 ERROR。
实际 trace_id、span_id、时间戳与耗时会随每次请求变化。
makeCurrent() 的作用不是“启动 Span”,而是把它放进当前 Context。这样内部自动埋点产生的数据库或 HTTP Span 才会把业务 Span 当作父节点。Scope 必须在当前线程的对应作用域内关闭,而 Span 必须在业务操作真正结束时调用 end()。
让属性、事件和状态各司其职
业务维度如果没有独立时间点意义,优先使用属性,例如订单 ID、业务类型或处理结果。某个瞬时节点本身值得标记时,再使用 Span Event,例如“库存锁定完成”。异常导致当前操作失败时记录异常并设置 ERROR;成功路径通常不必额外强制设置 OK。
对采样决策重要、且创建 Span 时就已知的字段,应尽量在 spanBuilder 上设置。敏感信息、完整请求体、令牌等不要直接写入 Span;高基数字段是否保留,也要结合后端索引成本和检索需求决定。
避免把函数调用等同于 Span
手工埋点的目标是补足业务语义,而不是复刻调用栈。一个业务操作内部如果有十几个只耗时几微秒、没有独立失败意义的辅助方法,把它们全部切成 Span 只会增加遥测量并降低 Trace 可读性。
更实用的判断方式是:这个步骤是否需要单独回答“它花了多久、是否失败、为什么失败、与上下游什么关系”。如果答案大多是否,就保留在父 Span 中;如果涉及独立业务决策、异步边界或重要外部依赖,则更值得成为独立 Span。
完成埋点后,用一条固定测试请求检查 Trace 树:入口 Span 下应出现业务 Span,业务 Span 下再连接自动生成的数据库或 HTTP Span。只要父子关系、错误状态和关键属性符合预期,手工埋点就真正补上了自动埋点看不到的业务层语义。