
可观测性与稳定性 / 系统课时
完成生产级遥测链路演练
完成生产级遥测链路演练
这次演练把“能看到 Trace”提升为“故障时仍能解释发生了什么”:统一接入多服务遥测,建立正常基线,再主动制造丢数、断链和背压,并用业务、后端与 Collector 三类证据完成验收。
学习目标
- 为至少两个服务配置一致的 OTLP 出口、传播协议和资源属性。
- 能分别注入丢数、上下文断链与导出背压,并判断故障发生在哪一段。
- 用可重复的检查项形成验收记录,并把恢复动作沉淀成 Runbook。
先固定拓扑与验收口径
建议在预发布环境使用“应用服务 → OpenTelemetry Collector Gateway → Trace 后端”的统一出口。应用只负责生成遥测和传播上下文,Collector 负责批处理、限流、排队、重试与导出;这样故障发生时,业务链路和遥测链路可以分开判断。
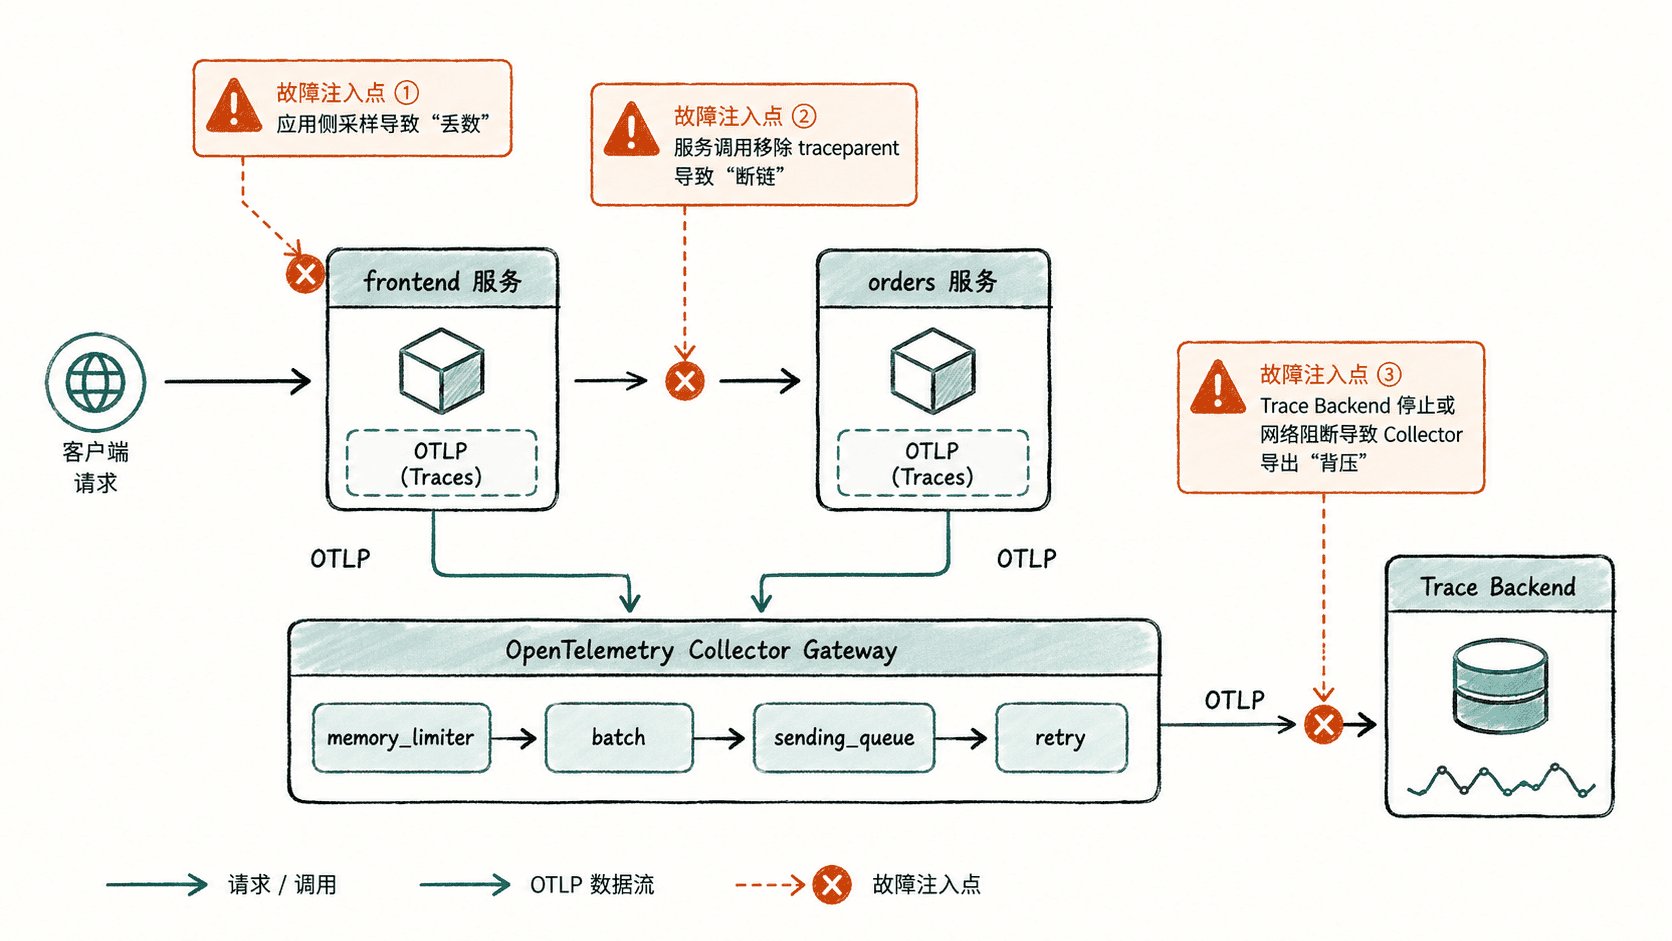
验收不要只看“页面里有没有 Trace”。每次请求至少记录一个业务结果、一个 Trace 结果和一个 Collector 结果:业务是否成功、跨服务是否保持同一 trace_id、Collector 是否出现重试或排队异常。只有三类证据能相互解释,才算形成完整证据链。
接入并建立正常基线
两个服务的 service.name 必须唯一,但 OTLP 出口与传播格式应一致。下面以 frontend 为例;orders 只需把服务名改为自己的值。<PORT>、版本号和后端地址按实际环境替换。
export OTEL_SERVICE_NAME=frontend
export OTEL_EXPORTER_OTLP_ENDPOINT=http://otel-gateway:4318
export OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf
export OTEL_PROPAGATORS=tracecontext,baggage
export OTEL_RESOURCE_ATTRIBUTES="deployment.environment=staging,service.version=<VERSION>"
printf '%s\n%s\n' "$OTEL_SERVICE_NAME" "$OTEL_EXPORTER_OTLP_ENDPOINT"
预期输出
frontend
http://otel-gateway:4318
这是环境配置示例,生效方式取决于应用所使用的 OpenTelemetry SDK 或自动注入方式。验证重点不是环境变量本身,而是后端能看到 frontend、orders 两个服务,并且一次跨服务请求共享同一个 Trace。
Collector 至少要具备内存保护、批处理、发送队列和失败重试。下面配置展示这些生产化能力的最小组合;后端地址替换为实际 OTLP 接收端。
receivers:
  otlp:
    protocols:
      grpc:
      http:

processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 256
  batch:
    timeout: 1s
    send_batch_size: 512

exporters:
  otlp/backend:
    endpoint: trace-backend:4317
    tls:
      insecure: true
    sending_queue:
      enabled: true
      num_consumers: 4
      queue_size: 2048
    retry_on_failure:
      enabled: true
      initial_interval: 1s
      max_interval: 10s
      max_elapsed_time: 60s

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp/backend]
配置生效后,用一条真实业务请求建立基线。
curl -sS -o /dev/null -w '%{http_code}\n' http://localhost:<PORT>/checkout预期输出
200随后在 Trace 后端确认这次请求同时包含 frontend 与 orders 的 Span,且两者属于同一 trace_id。如果业务返回 200 但后端完全没有数据,应先检查应用到 Collector 的接收路径,而不是直接怀疑跨服务传播。
注入三类故障
丢数要可控,最容易复现的是把入口服务的采样率临时降到 25%。对 frontend 设置 OTEL_TRACES_SAMPLER=parentbased_traceidratio 和 OTEL_TRACES_SAMPLER_ARG=0.25 后重启实例,再连续发起同一类请求。此时业务成功率不应变化,但 Trace 数量会明显少于请求数;Collector 没有持续导出错误时,证据更指向采样策略而不是传输故障。
断链要破坏的是传播,而不是整个调用。可以在测试网关或代理中临时删除 traceparent 与 tracestate,让 orders 仍然被调用,却无法继承上游上下文。恢复前应看到两个服务各自生成可查询的 Span,但同一次业务调用不再落在同一个 Trace 中。
背压则从导出端制造:先停止 Trace 后端,再保持业务流量一段时间,观察 Collector 是否进入重试和排队状态。下面的命令假设后端容器名为 trace-backend。
docker compose stop trace-backend
seq 1 200 | xargs -I{} -P20 curl -sS -o /dev/null http://localhost:<PORT>/checkout
docker compose logs --since=2m otel-gateway | grep -E 'Exporting failed|retry|queue' | tail -n 20
预期输出
<TIME> ... Exporting failed ... retry ...不同 Collector 版本的日志措辞可能不同,但应能看到导出失败或重试证据。业务请求如果仍大多成功,说明业务面与遥测导出面已经解耦;若队列最终耗尽并开始丢弃数据,则需要把“排队过载”与单纯“后端暂时不可达”区分记录。
用证据链完成验收
恢复后端后执行 docker compose start trace-backend,继续发送少量请求。预期结果是 Collector 的导出错误停止增长,新 Trace 再次进入后端;如果队列中的历史数据仍在有效重试窗口内,还会继续补发。
docker compose start trace-backend
curl -sS -o /dev/null -w '%{http_code}\n' http://localhost:<PORT>/checkout
预期输出
200把四种状态放在同一张验收表里最容易暴露误判。
| 场景 | 业务证据 | Trace 证据 | Collector 证据 | 结论 |
|---|---|---|---|---|
| 正常 | 请求成功 | 跨服务同一 trace_id |
无持续导出错误 | 链路健康 |
| 丢数 | 请求成功 | Trace 数显著少于请求数 | 无持续导出错误 | 优先检查采样策略 |
| 断链 | 请求成功 | 上下游出现不同 trace_id |
接收与导出仍正常 | 优先检查上下文传播 |
| 背压 | 请求多为成功 | 新 Trace 延迟或缺失 | 出现重试、排队或丢弃迹象 | 优先检查导出端与队列容量 |
把演练沉淀为 Runbook
Runbook 不要只写“重启 Collector”。至少固定五个字段:现象、第一证据、判定条件、恢复动作、恢复验证。这样值班人员能沿同一顺序排查,而不是凭经验跳步骤。
incident: telemetry-export-backpressure
symptoms:
  - "业务请求成功,但新 Trace 延迟进入后端"
first_evidence:
  - "检查 Collector 导出失败、重试与队列相关日志"
decision:
  - "若应用到 Collector 正常,而 Collector 到后端失败,则定位为导出侧背压"
recovery:
  - "恢复后端或网络"
  - "确认队列开始排空"
verification:
  - "新请求重新生成完整跨服务 Trace"
  - "Collector 持续导出错误停止增长"
这段 Runbook 配置不是程序输入,而是可直接转成团队值班文档的结构化模板。真正的生产级验收标准不是“故障被修好一次”,而是同一故障能被重复注入、用相同证据定位,并按固定步骤恢复。