
可观测性与稳定性 / 系统课时
处理滚动发布与短生命周期工作负载
处理滚动发布与短生命周期工作负载
这节课处理 Kubernetes 生命周期边界最容易丢掉的遥测尾部:滚动升级会终止旧 Pod,Job 可能很快结束,弹性缩容也会撤掉实例。目标是让业务先停止接流量、再触发 SDK 冲刷,并让 Collector 在自身退出前尽量排空队列。
学习目标
- 找出滚动发布、Job 与缩容时尾数据丢失的窗口
- 为应用和 Collector 设计可执行的优雅终止顺序
- 用稳定的服务属性和唯一实例身份避免新旧 Pod 混淆
找到真正的丢失窗口
尾数据通常不是“网络突然丢包”,而是仍停留在内存中。应用 SDK 的 Batch Span Processor 可能还有未发送 Span;短 Job 可能在下一次周期导出前就退出;Gateway 也可能在发送队列或 tail sampling 决策窗口里保存尚未处理完的数据。
滚动发布时,新旧 Pod 会短暂并存。service.name 应保持稳定,service.version 用于区分版本,而 service.instance.id 必须区分同时存在的实例。如果把 Deployment 名称当作实例 ID,新旧 Pod 会被错误地看成同一个实例。
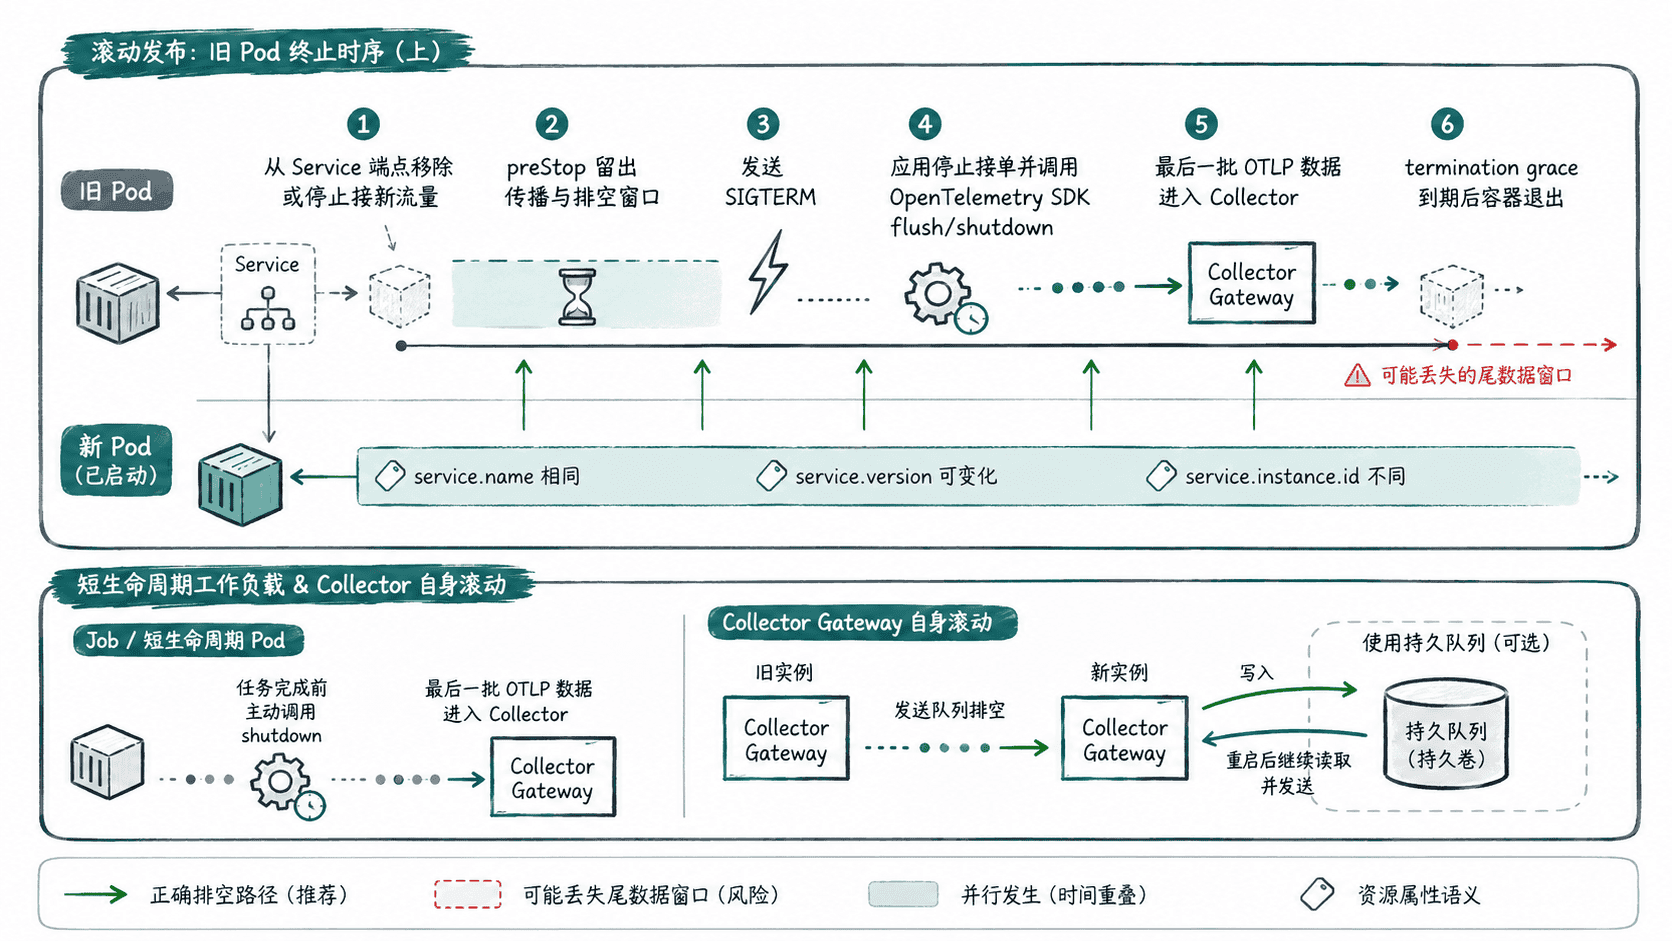
关键原则是把“停止接收新工作”和“进程立即退出”拆开,中间留出足够时间让正在执行的请求结束,并让遥测 SDK 的关闭逻辑完成最终导出。
给应用留下可用的退场时间
下面是需要并入实际 Deployment 的片段示例。preStop 先留出 5 秒让负载均衡与上游停止继续送流量,随后 Kubernetes 再向容器发送终止信号;总的 terminationGracePeriodSeconds 必须覆盖业务排空和遥测冲刷时间。
spec:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  template:
    spec:
      terminationGracePeriodSeconds: 45
      containers:
        - name: app
          lifecycle:
            preStop:
              exec:
                command: ["/bin/sh", "-c", "sleep 5"]
          env:
            - name: POD_UID
              valueFrom:
                fieldRef:
                  fieldPath: metadata.uid
            - name: OTEL_SERVICE_NAME
              value: checkout
            - name: OTEL_RESOURCE_ATTRIBUTES
              value: "service.namespace=shop,service.version=2.4.0,service.instance.id=$(POD_UID)"
            - name: OTEL_BSP_SCHEDULE_DELAY
              value: "1000"
这里假设一个 Pod 内只有一个需要标识的服务进程,因此 Pod UID 可以作为该服务实例的唯一身份。如果一个容器里运行多个独立服务进程,应由应用为每个实例生成独立的 service.instance.id,不要让 Collector 猜测。
把 OTEL_BSP_SCHEDULE_DELAY 调短可以减少 Span 在内存中等待周期导出的时间,但它不能替代显式关闭;不同语言对环境变量和关闭 API 的支持程度也要按所用 SDK 验证。
让 Job 在成功退出前主动冲刷
Job、CronJob、迁移脚本和一次性批处理最容易暴露这个问题,因为业务逻辑完成后进程通常马上返回。正确顺序是:创建并复用 Provider,执行任务,停止产生新遥测,等待 Span、Metric 和 Log 的最终导出,再返回成功退出码。
不要把“任务执行成功”当成“遥测已经发送成功”。对于只有几百毫秒到几秒的任务,即使把批处理周期调短,也可能在第一次定时导出前结束,因此显式 shutdown 比调整定时器更可靠。
如果 Job 会被主动删除或超过 activeDeadlineSeconds,还要确保剩余终止宽限期足够执行关闭逻辑。若平台最终发送强制终止信号,任何仍停留在应用内存中的遥测都无法再由 Collector 补救。
保护 Collector 自己的发送队列
Collector 正常收到终止信号时会进入关闭流程,但只靠内存发送队列仍无法覆盖进程崩溃或 Pod 被重新创建的情况。对不能接受这类丢失的 Gateway,可以把发送队列接到 file_storage,前提是该目录真正位于能跨重启保留的数据卷上。
extensions:
  file_storage:
    directory: /var/lib/otelcol/storage

receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

exporters:
  otlp/backend:
    endpoint: backend.example.com:4317
    tls:
      insecure: false
    sending_queue:
      enabled: true
      storage: file_storage
      queue_size: 5000
    retry_on_failure:
      enabled: true
      max_elapsed_time: 10m

service:
  extensions: [file_storage]
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [otlp/backend]
把配置保存为 <PATH>/gateway.yaml 后可以先验证组件与字段是否被当前发行版识别:
otelcol-contrib validate --config=<PATH>/gateway.yaml >/dev/null && echo "persistent queue config valid"预期输出:
persistent queue config valid配置通过并不等于数据已经持久化:/var/lib/otelcol/storage 还必须挂载到合适的数据卷。emptyDir 不能跨 Pod 重建保存数据;多副本 Gateway 也不要让多个 Collector 进程共享同一个可写的 file_storage 目录。需要每副本稳定磁盘时,通常应使用具备稳定身份和独立卷的部署方式,或者改用外部消息队列。
验证发布与实例身份
完成生命周期配置后,实际触发一次滚动发布,确认 Deployment 能在宽限期内完成,并观察新 Pod 获得新的 UID:
kubectl -n app rollout restart deployment/checkout >/dev/null && echo "restart requested"
kubectl -n app rollout status deployment/checkout --timeout=180s >/dev/null && echo "rollout complete"
kubectl -n app get pods -l app=checkout -o custom-columns=NAME:.metadata.name,UID:.metadata.uid --no-headers
预期输出:
restart requested
rollout complete
<NAME> <ID>
<NAME> <ID>
<NAME> <ID>
Pod 名称和 UID 的实际值会不同。再到遥测后端检查同一服务的资源属性:service.name 应持续为 checkout,service.version 应对应实际版本,新旧 Pod 的 service.instance.id 不应相同。若发布期间仍出现最后几秒 Trace 缺口,就按“应用是否收到 SIGTERM并完成 shutdown → Collector 队列是否堆满 → Gateway 是否在同一时间被替换 → 后端是否拒绝或超时”的顺序定位,而不是先盲目增加重试次数。