
可观测性与稳定性 / 系统课时
排查背压、丢弃与重试堆积
排查背压、丢弃与重试堆积
当 Collector 的出口速度低于入口速度时,现象可能从队列增长演变为内存压力、拒绝新数据和真实丢弃。本课用一条固定证据链区分这些阶段,并给出先恢复出口、再消除积压、最后验证数据流恢复的排查顺序。
学习目标
- 根据队列、拒绝、发送失败和内存指标判断拥塞发生在哪一段。
- 区分“正在重试”与“已经丢失”,避免只看到错误计数就误判数据丢失。
- 按后端、容量和队列状态选择恢复动作,并用数据流指标完成验收。
先把拥塞链路画清楚
Collector 的压力通常沿“Receiver → Processor → Exporter sending queue → Backend”传播。后端变慢时,导出请求先耗时变长并进入重试,随后 sending queue 增长;队列满后,新批次可能无法入队。若积压继续推高进程内存,memory_limiter 会主动拒绝数据并向上游施加背压。
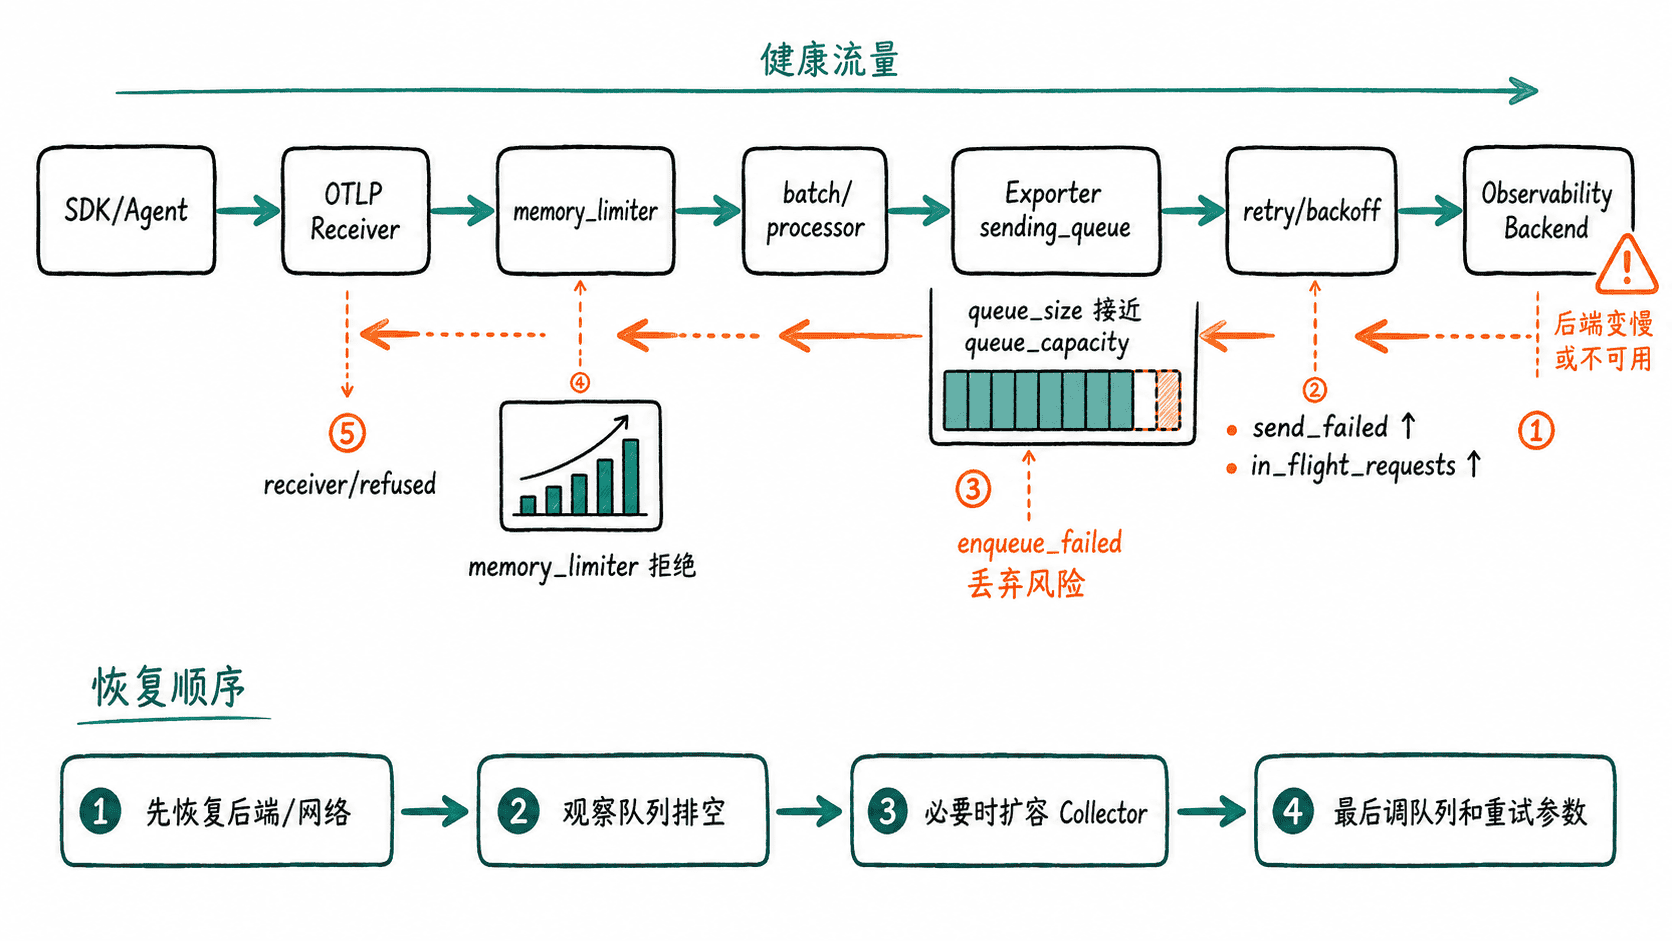
关键是不要把所有非零错误都叫“丢数据”。otelcol_exporter_send_failed_spans 表示发送尝试失败,数据仍可能处于可重试流程中;otelcol_exporter_enqueue_failed_spans 则表示数据没有进入 sending queue,风险更高。持续的 receiver refused 也意味着上游已经收到拒绝,最终是否丢失取决于上游是否会重试。
用四组信号确定堵点
先看趋势,不看单个瞬时值。Counter 要观察单位时间增量,Gauge 才直接看当前状态。
| 信号 | 典型现象 | 优先判断 |
|---|---|---|
otelcol_exporter_queue_size / queue_capacity |
队列持续逼近容量 | 出口吞吐低于入口 |
otelcol_exporter_send_failed_spans |
增速升高但队列仍可入队 | 网络或后端暂时失败,可能仍在重试 |
otelcol_exporter_enqueue_failed_spans |
开始持续增长 | 队列已无法接收新批次,存在直接丢弃风险 |
otelcol_processor_refused_spans、otelcol_receiver_refused_spans、进程 RSS |
拒绝与内存同时上升 | memory_limiter 或整体容量已进入保护阶段 |
Logs 和 Metrics 有对应的 *_log_records、*_metric_points 指标。若只检查 Trace,可能漏掉真正压垮 Collector 的高吞吐日志或指标流。
抓取一次故障快照
Collector 默认可通过 Prometheus 接口暴露内部指标,常见地址是 127.0.0.1:8888/metrics。在能够访问该端点的位置执行:
curl -fsS http://127.0.0.1:8888/metrics | grep -E 'otelcol_(exporter_queue_(size|capacity)|exporter_(enqueue_failed|send_failed)_spans|processor_refused_spans|receiver_refused_spans|process_memory_rss)'预期输出
otelcol_exporter_queue_capacity{...} <VALUE>
otelcol_exporter_queue_size{...} <VALUE>
otelcol_exporter_enqueue_failed_spans{...} <VALUE>
otelcol_exporter_send_failed_spans{...} <VALUE>
otelcol_processor_refused_spans{...} <VALUE>
otelcol_receiver_refused_spans{...} <VALUE>
otelcol_process_memory_rss{...} <VALUE>
<VALUE> 和标签会随实例变化;自定义 Prometheus reader 时,Counter 还可能带 _total 后缀。若命令完全没有结果,先确认 Collector 的内部指标端点是否已暴露,而不是直接得出“系统没有错误”的结论。
按瓶颈选择恢复动作
后端或网络故障时,先修复 DNS、TLS、鉴权、限流或后端容量,因为扩大 Collector 队列只能延迟失败。恢复出口后观察 queue_size 是否持续下降;只要队列能排空,就不应在故障高峰中贸然重启 Collector。
如果出口正常但队列长期高水位,说明 Collector 自身吞吐不足。优先横向扩容无状态 Collector,或减少昂贵处理器;涉及 tail sampling 时必须保持同一 Trace 的 spans 路由到同一采样实例,不能用普通随机扩容破坏采样完整性。
如果进程 RSS 接近容器限制并伴随拒绝,应先确认 memory_limiter 位于管道前部,再核对容器内存、限制参数和队列容量。不要简单把 queue_size 调大:内存队列越大,可吸收的故障窗口更长,但 OOM 风险也同步增加。
用排空而不是“错误消失”验收
恢复后的验收至少观察一个完整流量周期:queue_size 从高位回落并稳定,enqueue_failed_* 与 receiver_refused_* 不再增长,send_failed_* 的增长斜率归零或回到基线,同时 exporter_sent_* 恢复。若错误停止但队列仍不下降,系统只是停止恶化,还没有恢复吞吐余量。
最终目标不是把所有错误计数清零,而是确认入口速率重新小于可持续出口能力,并且积压正在被消费。只有这一条件成立,才算真正解除背压。