
可观测性与稳定性 / 系统课时
设计 Collector 高可用与水平扩缩
设计 Collector 高可用与水平扩缩
Collector 能否直接增加副本,取决于流水线是否保存跨请求状态。本课把接入层与有状态处理层拆开,设计可扩缩的两层 Collector,并给出副本分布、路由和容量冗余的验收方法。
学习目标
- 区分可直接水平扩展的无状态处理与需要稳定分片的有状态处理
- 使用 Trace ID 一致性路由保护尾采样等跨 Span 状态
- 用副本分布、故障余量和扩缩边界设计生产级容量
先按状态决定扩缩方式
OTLP 接收、批处理、属性转换等通常只处理当前批次,可以把多个 Collector 副本放在 Kubernetes Service 或四层负载均衡器后面。tail_sampling 则要在决策窗口内保存同一 Trace 的 Span;若这些 Span 被随机分到不同副本,每个实例看到的都只是残缺 Trace,采样结果会失真。Prometheus 抓取、聚合类连接器也可能持有任务或聚合状态,因此不能把“Collector 进程无状态”当成所有组件都无状态。
| 处理类型 | 典型行为 | 扩缩重点 |
|---|---|---|
| 无状态 | OTLP 接入、batch、属性处理 | 多副本直接分流,重点保证均衡和故障切换 |
| 按 Trace 有状态 | tail sampling | 同一 Trace 必须稳定落到同一处理副本 |
| 抓取或聚合有状态 | Prometheus 抓取、服务级聚合 | 避免重复抓取或把同一聚合键拆到多个副本 |
有状态并不等于不能扩容,而是必须先定义“状态属于谁”,再选择稳定的分片键。尾采样通常按 traceID 分片,服务级指标聚合则更适合按 service.name 或其他稳定业务键分片。
用两层 Collector 隔离路由与有状态处理
推荐把入口 Collector 与尾采样 Collector 拆成两层:第一层本身保持无状态并可快速扩缩,load_balancing exporter 根据 Trace ID 把数据稳定发送到第二层;第二层通过无头 Service 暴露全部后端地址,并执行 tail_sampling。这样入口层故障不会破坏 Trace 归属规则,而尾采样层可以独立做容量规划。当前 load_balancing exporter 支持按 traceID 一致性路由,并能通过 DNS 或 Kubernetes resolver 感知后端集合。
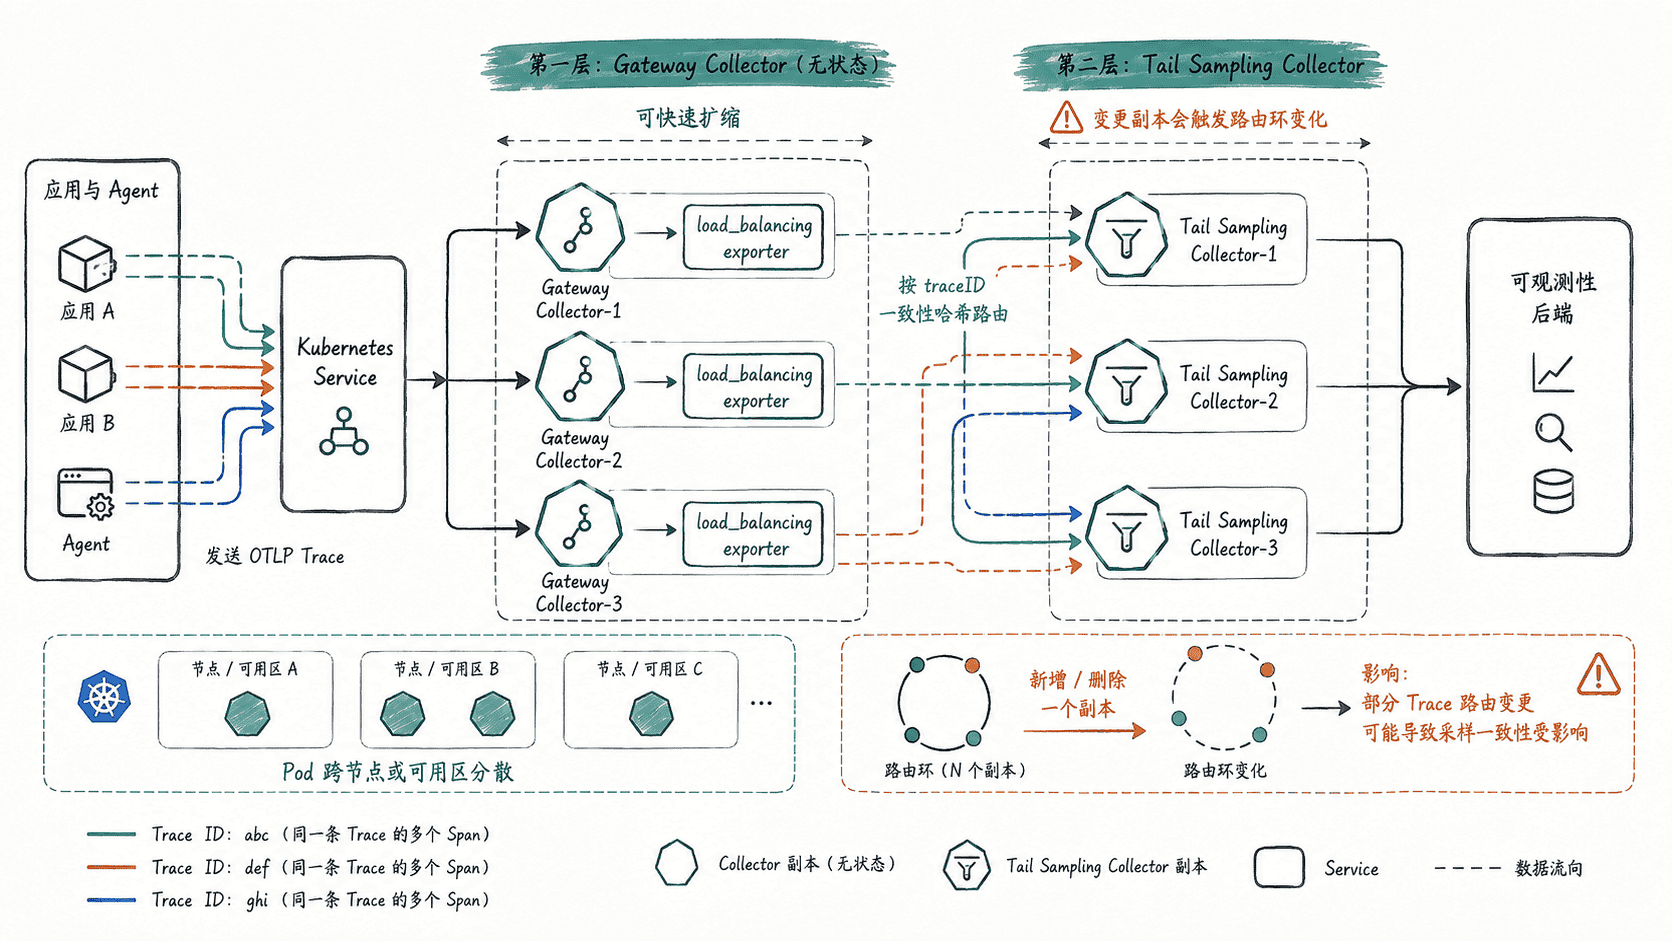
入口层的核心配置如下。这里显式使用 traceID,并让 DNS resolver 解析第二层无头 Service;集群内若没有 mTLS,再由 tls.insecure 表示明文 OTLP/gRPC,生产环境应按网络边界替换为实际 TLS 配置。
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20
  batch:

exporters:
  load_balancing/traces:
    routing_key: traceID
    timeout: 10s
    retry_on_failure:
      enabled: true
      initial_interval: 1s
      max_interval: 10s
      max_elapsed_time: 60s
    sending_queue:
      enabled: true
      num_consumers: 4
      queue_size: 1000
    protocol:
      otlp:
        timeout: 3s
        tls:
          insecure: true
    resolver:
      dns:
        hostname: otel-tail-sampling-headless.observability.svc.cluster.local
        interval: 5s

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [load_balancing/traces]
这是完整的入口层配置示例,但前提是所用 Collector 发行版包含 load_balancing exporter,且 DNS 名称能解析到第二层 Pod。部署前先做配置校验:
otelcol-contrib validate --config <PATH>/gateway.yaml && echo VALID预期输出:
VALID<PATH> 替换为实际配置目录;成功只说明配置可加载,不代表后端地址已经可达,因此还要在运行态观察后端解析数、发送失败和队列。
把副本数与亲和性设计成故障域
高可用不是“副本数大于 1”就结束。入口层通常至少跨多个节点放置,生产集群还应跨可用区分散;用 topologySpreadConstraints 或 Pod 反亲和性,避免调度器把所有 Collector 放到同一故障域。第二层也要分散,但扩缩节奏应比入口层更保守,因为后端集合变化会重新映射一部分 Trace。
容量目标应直接写成“失去一个副本仍能承载峰值”。若压测得到单副本安全处理能力为 ,计划运行 个副本,则常态峰值最好满足 。这样任意一个 Pod 故障后,剩余实例仍有处理余量,而不是刚好把故障变成新的拥塞。
用不同信号触发不同层的扩缩
入口层适合对 CPU、内存、接收拒绝量和发送队列做水平扩缩;尾采样层还必须关注每实例正在等待决策的 Trace 数和内存压力。若 exporter 队列持续接近容量,同时 send_failed 也上升,根因可能在后端或网络,此时继续增加 Collector 只会把压力推向已经过载的下游。OpenTelemetry 的扩缩指导也建议同时观察队列、拒绝量和后端能力,而不是只看 CPU。
扩容前先确认瓶颈属于当前层:接收侧拒绝增加而下游健康,优先扩入口;尾采样内存或决策积压高,扩第二层并控制变更节奏;所有 Collector 都出现导出失败且后端延迟同步升高,应先处理后端容量。
验收高可用而不是只看副本数
上线前至少做三类故障演练:删除一个入口 Pod,确认客户端仍能发送;删除一个尾采样 Pod,确认 resolver 能更新后端集合且失败率只短暂波动;限制后端出口,确认队列和失败指标会报警而不是静默丢数据。对有状态层还要抽样检查完整 Trace,确认同一 Trace 的 Span 没有长期分裂到多个采样器。
最终的设计原则是:无状态层追求弹性,有状态层追求稳定分片,两层都保留失去一个副本后的容量余量。只有负载均衡、故障域分散、路由稳定性和下游承载能力一起满足,Collector 的“多副本”才真正构成高可用。