
可观测性与稳定性 / 系统课时
使用 View 控制聚合与属性
使用 View 控制聚合与属性
本篇把 View 当作指标管道中的“重写规则”:先精确匹配 Instrument,再决定怎样聚合、保留哪些属性以及如何设置直方图边界。完成后,你可以在不修改业务埋点调用的前提下改善指标可用性,并压住不必要的时间序列基数。
学习目标
- 使用 InstrumentSelector 精确匹配需要调整的指标
- 用 View 修改 Histogram 聚合边界并裁剪属性
- 识别高基数属性与多 View 重叠带来的风险
View 改的是输出流
View 位于 Instrument 与 Metric Stream 之间。Selector 决定“匹配谁”,View 决定“输出成什么样”。常见控制项包括聚合方式、指标名称或描述、属性过滤以及 SDK 提供的基数保护能力。
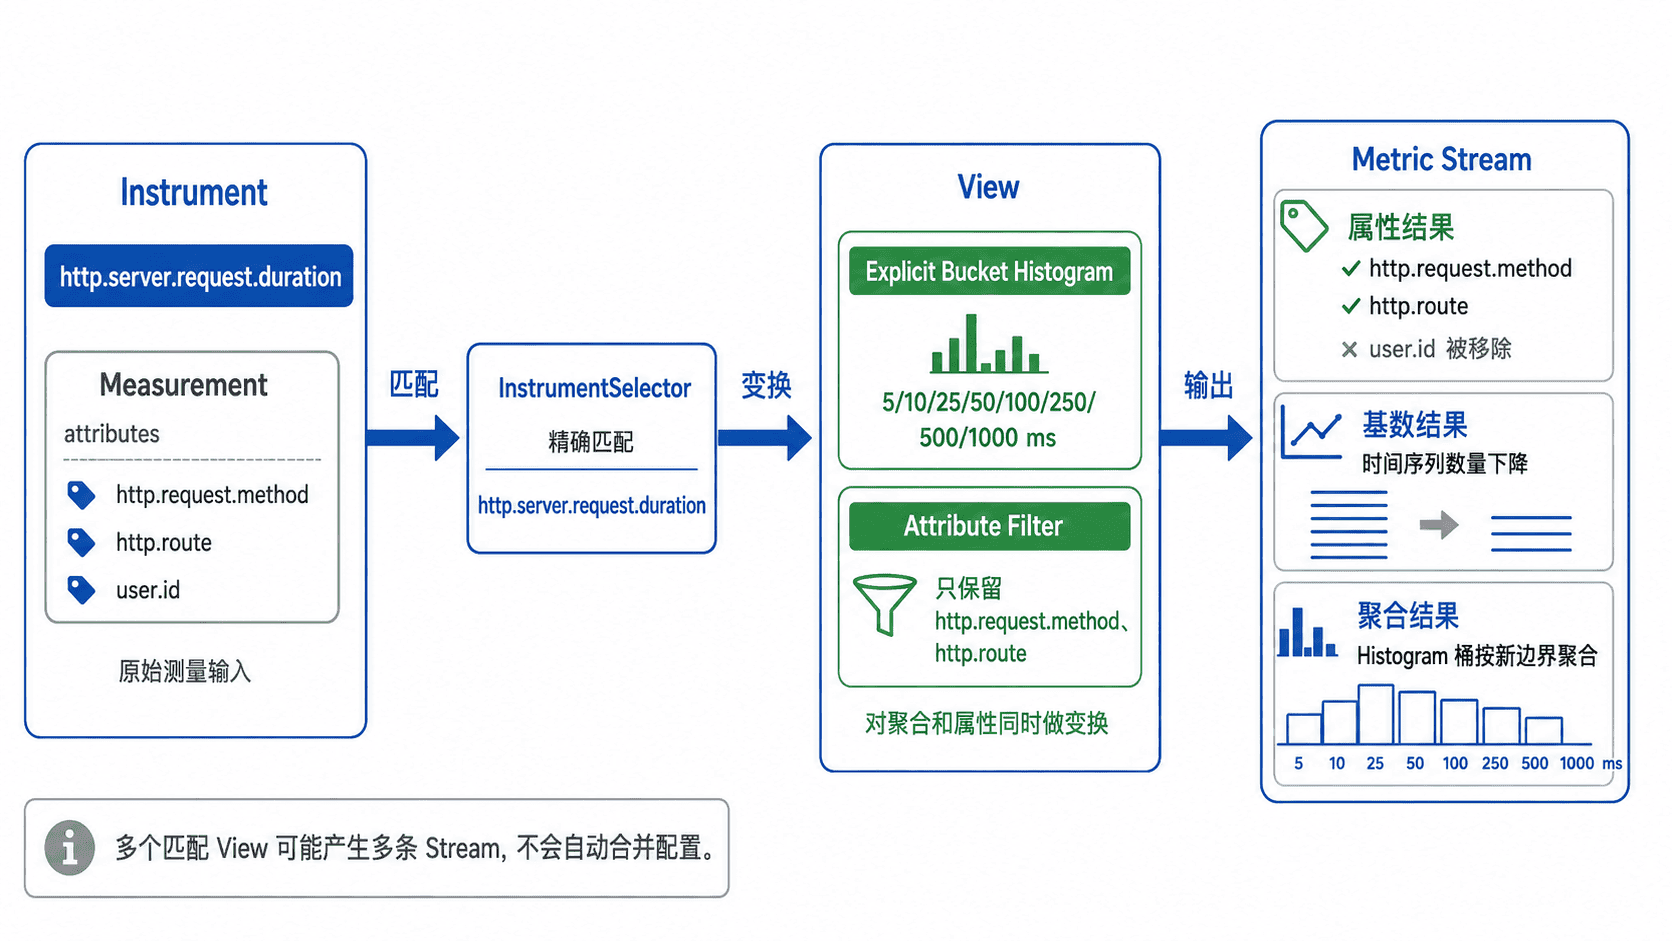
最安全的做法是让 Selector 尽量窄:按仪表名称、类型,必要时再结合 Meter 范围限定。匹配条件同时存在时按“且”关系理解,只有全部满足的 Instrument 才应用该 View。
配置一个主 View
下面是 Java SDK 片段示例,依赖项目已有的 opentelemetry-sdk-metrics,并应合入应用现有的 SdkMeterProvider 构建过程。示例只演示 View 配置;实际导出仍由项目中的 MetricReader 与 Exporter 负责。
import io.opentelemetry.sdk.metrics.Aggregation;
import io.opentelemetry.sdk.metrics.InstrumentSelector;
import io.opentelemetry.sdk.metrics.InstrumentType;
import io.opentelemetry.sdk.metrics.SdkMeterProviderBuilder;
import io.opentelemetry.sdk.metrics.View;
import java.util.Arrays;
import java.util.HashSet;

public final class MetricsViews {
    public static SdkMeterProviderBuilder addHttpDurationView(
            SdkMeterProviderBuilder builder) {
        return builder.registerView(
            InstrumentSelector.builder()
                .setName("http.server.request.duration")
                .setType(InstrumentType.HISTOGRAM)
                .build(),
            View.builder()
                // 桶边界围绕常见延迟与告警阈值布置,单位与 Instrument 保持一致。
                .setAggregation(Aggregation.explicitBucketHistogram(
                    Arrays.asList(5d, 10d, 25d, 50d, 100d, 250d, 500d, 1000d)))
                // 去掉逐用户维度,避免同一路由被拆成大量时间序列。
                .setAttributeFilter(new HashSet<>(Arrays.asList(
                    "http.request.method",
                    "http.route")))
                .build());
    }

    private MetricsViews() {}
}
预期结果(逻辑形态;具体序列化格式取决于 Exporter):
matched instrument: http.server.request.duration (Histogram)
retained attributes: http.request.method, http.route
dropped attribute: user.id
explicit boundaries(ms): 5,10,25,50,100,250,500,1000
验证时向该 Histogram 记录几组带 user.id 的请求数据,再检查导出结果:user.id 不应出现在数据点属性中,桶边界应与 View 配置一致;不匹配名称或类型的其他 Instrument 应保持原有配置。
让桶边界服务于查询
直方图边界不是越多越好。边界应围绕业务关心的区间布置,例如 100 ms、250 ms、500 ms 可能分别对应体验目标、告警阈值和严重超时区间。边界过稀会丢失分辨率,过密则增加每个数据点的体积和后端处理成本。
同时要确认单位一致。若 Instrument 声明单位为秒,却按毫秒写入 5, 10, 25 这样的边界,图表不会报语法错误,但桶的业务含义会完全错位。调整 View 前应先确认 Instrument 的 name、type 与 unit。
用属性过滤控制基数
指标基数主要由“被保留属性的取值组合数”决定。路由模板、请求方法、状态码通常较稳定;原始 URL、用户 ID、订单 ID、请求 ID 则可能持续产生新值。View 的属性过滤可以在聚合前丢弃不需要的键,让原本不同的 Measurement 合并到更少的 Metric Stream。
对 Gauge 类指标要更谨慎:Last Value 没有像 Sum 或 Histogram 那样自然的空间合并语义。若删除一个会区分多个独立实体的属性,剩余“最后值”未必还能代表一个有意义的整体。
避免多个 View 意外叠加
在 Java SDK 中,多个 View 同时匹配同一个 Instrument 时,不应期待它们把配置合并成一个结果。例如一个 View 改聚合,另一个 View 改属性,可能得到两条不同的 Metric Stream,而不是一条同时具备两项修改的 Stream。
因此,针对关键指标优先使用一个选择条件明确的 View,把相关变换集中配置。上线前用导出结果检查 metric name、data point type、bucket boundaries 与 attributes 四项,确认既保留了查询所需维度,也没有重新引入高基数。