
可观测性与稳定性 / 系统课时
用自遥测监控 Collector 运行状态
用自遥测监控 Collector 运行状态
Collector 自身也会拥塞、拒绝数据或卡在导出队列里。本课配置它的内部指标、结构化日志和健康端点,再用接收量、导出失败、队列、内存与 RPC 延迟建立一套能定位故障方向的监控视图。
学习目标
- 暴露 Collector 的内部 Prometheus 指标、JSON 日志与健康检查端点
- 用接收、导出、队列和内存指标判断数据流是否健康
- 区分 Collector 自身瓶颈、下游故障与仅存活但不可用的状态
把自遥测拆成三个互补入口
Collector 默认会产生内部指标和日志:指标适合持续看趋势与报警,日志提供错误上下文,健康端点适合 Kubernetes 探针或外部存活检查。内部指标覆盖进程 CPU、RSS 内存、receiver 接收与拒绝、exporter 发送失败、发送队列以及 HTTP/gRPC 请求时延等;Prometheus 拉取端口默认是 8888,日志默认写到 stderr。
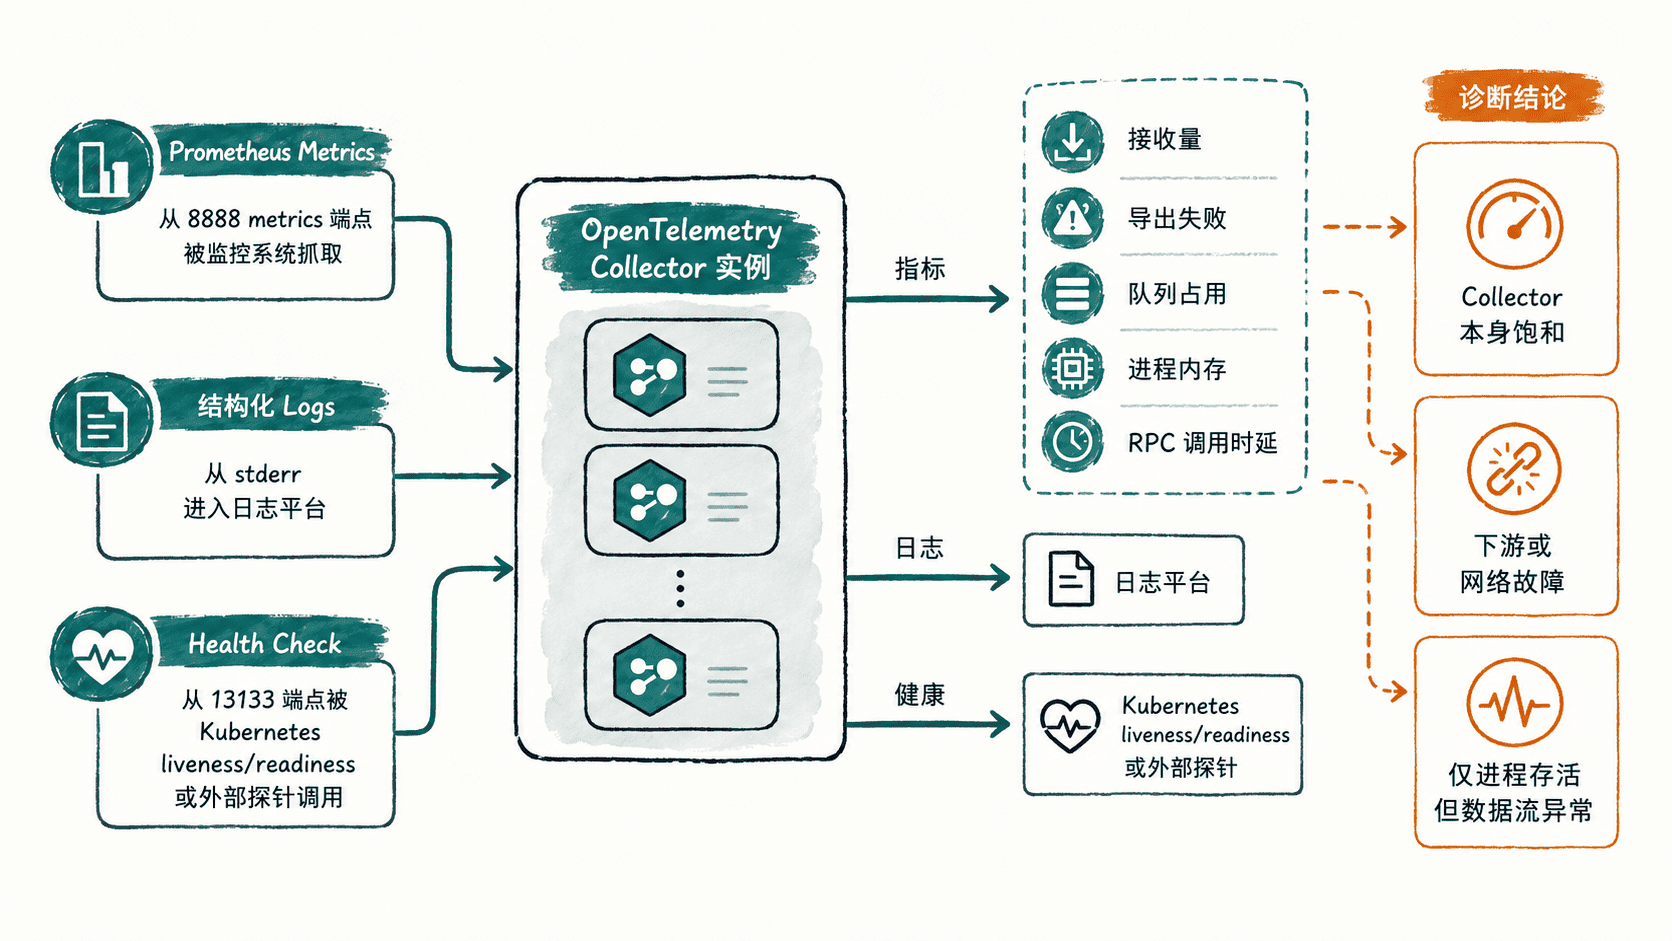
生产环境不要只保留默认的 127.0.0.1:8888,因为集群内 Prometheus 通常需要从 Pod 外抓取。下面把指标显式绑定到所有容器接口,同时保持较短的原始指标名,并开启 JSON 日志和健康检查:
extensions:
  health_check:
    endpoint: 0.0.0.0:13133

service:
  extensions: [health_check]
  telemetry:
    resource:
      service.name: otelcol-gateway
      deployment.environment.name: production
    metrics:
      level: normal
      readers:
        - pull:
            exporter:
              prometheus:
                host: 0.0.0.0
                port: 8888
                without_type_suffix: true
                without_units: true
    logs:
      level: info
      encoding: json
当前 Collector 的内部指标声明式配置仍在演进,升级版本时应先执行配置校验;较新的版本已经不再使用旧的 service.telemetry.metrics.address 来修改监听地址,而是通过 readers 配置 Prometheus pull exporter。
先验证端点,再谈仪表盘
先确认配置能加载、健康端点返回成功、指标端点确实有进程指标。下面的命令可直接用于容器内或端口转发后的本地检查:
otelcol-contrib validate --config <PATH>/collector.yaml \
  && curl -fsS -o /dev/null -w 'health=%{http_code}\n' http://127.0.0.1:13133/ \
  && curl -fsS http://127.0.0.1:8888/metrics \
  | grep 'otelcol_process_memory_rss' \
  | head -n 1
预期输出:
health=200
otelcol_process_memory_rss{<LABELS>} <VALUE><PATH>、<LABELS> 与 <VALUE> 会随环境变化。若健康端点是 200 而指标端点没有数据,优先检查监听地址、容器端口和抓取网络;若二者都正常,再继续判断流水线本身是否健康。
用四组核心指标判断数据流
先看“进入多少、出去多少、积压多少、失败多少”,不要一上来追单条日志。以下名称按上面的 Prometheus reader 配置保留原始 Collector 名称;只有启用了对应组件并产生流量后,相关时间序列才会出现。
| 问题 | 关键指标或查询 | 判断重点 |
|---|---|---|
| 是否收到数据 | rate(otelcol_receiver_accepted_spans[5m]) |
业务有流量但长期为 0,先查客户端、网络与 receiver |
| 是否拒绝接收 | rate(otelcol_receiver_refused_spans[5m]) |
持续大于 0 说明数据无法顺利进入流水线 |
| 是否导出失败 | rate(otelcol_exporter_send_failed_spans[5m]) |
持续上升通常指向网络、鉴权或后端不可用 |
| 队列是否逼近上限 | otelcol_exporter_queue_size / otelcol_exporter_queue_capacity |
比率持续升高说明导出速度落后于接收速度 |
| 内存是否危险 | otelcol_process_memory_rss |
与 Pod memory limit 对比,观察持续逼近限制而非单点峰值 |
队列尤其适合做容量早期预警。OpenTelemetry 的扩缩指导建议在队列达到大约 60%~70% 容量时开始关注扩容或下游吞吐问题;若队列比例很高且发送失败也持续上升,更应先检查后端是否已经成为瓶颈。
用日志和时延确定故障方向
指标告诉你“哪里不正常”,日志帮助解释“为什么”。Collector 会记录启动与停止、节流导致的数据丢弃、无效数据以及崩溃等事件;当队列满时,还可能出现与发送队列满和丢弃数据相关的错误信息。日志格式本身没有稳定兼容保证,因此报警应优先依赖指标,日志用于关联上下文。
处理延迟不能只看一个总耗时指标。新版 Collector 的 gRPC 内部遥测会暴露 rpc.server.call.duration 与 rpc.client.call.duration,可分别观察接收侧和调用下游时延;如果使用 load_balancing exporter,还可以结合其后端延迟指标判断是否只有某个下游实例变慢。RPC 指标名称和内部 Trace 仍可能随版本演进,因此更适合作为诊断信号,而不是单独承担长期 SLO。
建立可执行的报警与排查顺序
报警阈值应和压测基线绑定,而不是照搬固定数字。一个实用起点是:队列占用持续超过 70% 触发容量告警;receiver refused 或 exporter send failed 持续大于 0 触发数据风险告警;RSS 长时间超过容器限制的 80% 触发内存告警。阈值触发后按“接收 → 处理 → 队列 → 导出 → 下游”的顺序排查,能减少把下游故障误判成 Collector 需要扩容的概率。
当健康端点正常、接收量稳定、队列低位、导出失败接近零且内存有余量时,才可以认为 Collector 数据面处于健康状态;其中任意一项异常,都应结合日志和 RPC 时延继续定位,而不是仅凭 Pod Running 状态结束排查。