
可观测性与稳定性 / 系统课时
控制高基数属性与指标维度
控制高基数属性与指标维度
高基数属性会把一个本来可聚合的指标拆成大量时间序列,直接放大内存、存储与查询成本。本课用可运行的小实验识别维度爆炸,再把用户 ID、URL 参数等信息合理分配到 Metric、Trace 和 Log。
学习目标
- 能用值域与组合数判断属性是否会制造高基数
- 能区分同一信息进入 Metric、Trace 或 Log 时的成本与用途
- 能设计从埋点、视图到后端的多层高基数保护
先看值域,不要只看字段名
指标的基数来自“不同属性组合的数量”。http.request.method 通常只有少量取值,http.route 应使用路由模板,因此适合作为聚合维度;而 user.id、订单 ID、请求 ID、带参数的原始 URL 往往接近每次请求都不同,一旦进入 Metric 就可能为每个值创建新的时间序列。
高基数和敏感信息是两个维度的问题。user.id 既可能高基数,也可能涉及隐私;即使某个字段基数很低,只要包含凭证、邮箱、精确位置等敏感内容,也不能因为“成本可控”就直接采集。
用小实验看维度爆炸
下面的 Python 程序把 1000 次请求映射成指标属性组合。它不依赖 OpenTelemetry SDK,只演示 Metric 后端真正面对的唯一属性集合数量。
methods = ("GET", "POST", "DELETE")
routes = ("/orders/{id}", "/users/{id}")

# 模拟 1000 个不同用户访问有限的方法和路由模板。
requests = [
    {
        "method": methods[i % len(methods)],
        "route": routes[i % len(routes)],
        "user_id": f"user-{i}",
    }
    for i in range(1000)
]

def series_count(keys):
    # 每个不同的属性元组都代表一个潜在时间序列。
    return len({tuple(item[key] for key in keys) for item in requests})

print("method+route:", series_count(("method", "route")))
print("method+route+user_id:", series_count(("method", "route", "user_id")))
预期输出
method+route: 6
method+route+user_id: 1000
这里只增加一个 user_id 维度,序列数就从 6 增长到 1000。真实系统还会叠加服务、区域、状态、实例等属性,因此不能用“单个字段看起来没多少值”来判断总体成本。
按信号分配属性
Metric 负责聚合趋势,最需要低且可预测的维度;Trace 以单次请求为中心,可以在确有诊断价值且满足隐私要求时保留部分高基数标识;Log 更适合承载详细诊断内容,但仍要区分“保存”与“建立索引”,否则日志索引也会承担类似的高基数成本。
| 信息 | Metric | Trace | Log | 处理原则 |
|---|---|---|---|---|
http.request.method |
适合 | 适合 | 可选 | 值域小,便于聚合 |
http.route |
适合 | 适合 | 可选 | 必须使用路由模板,不能用真实路径替代 |
error.type |
通常适合 | 适合 | 适合 | 应使用可预测、低基数的错误类别 |
user.id / enduser.id |
不适合 | 谨慎使用 | 谨慎使用 | 高基数且可能涉及隐私,必要时脱敏或改用受控关联方式 |
| 原始 URL 与查询参数 | 不适合 | 谨慎使用 | 谨慎使用 | 先清除凭证和敏感参数,避免把动态参数变成指标维度 |
| 订单 ID、请求业务 ID | 不适合 | 视诊断价值使用 | 视诊断价值使用 | 适合定位单次事件,不适合长期聚合 |
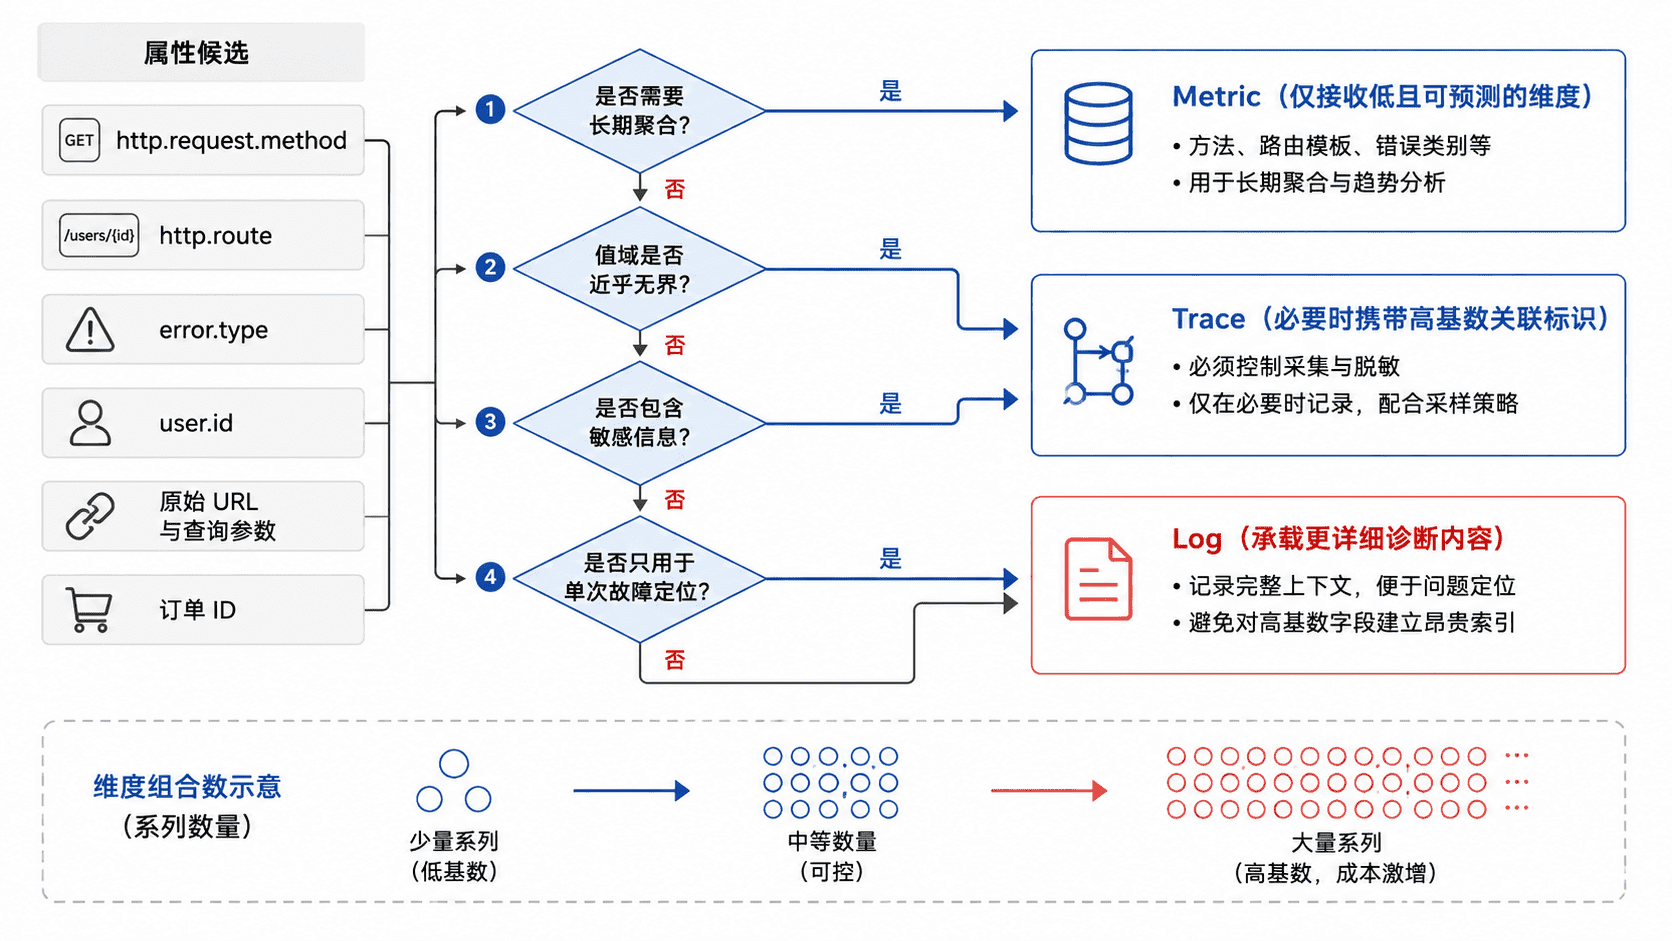
把限制放在数据进入指标之前
最有效的治理是在埋点处不把高基数字段放进 Metric。第二层是在 SDK 的 Metric View 或等价配置中只保留允许的属性键;第三层才是 Collector 或后端过滤。SDK 的 cardinality limit 可以作为兜底,但它解决的是“最多保留多少组合”,不是“哪些维度具有正确业务语义”,不能替代属性设计。
对于 URL,优先让指标使用 http.route 这样的低基数模板;原始 URL 或查询参数即使进入 Trace 或 Log,也应先做敏感参数清理。对于用户标识,先回答是否真的需要遥测系统长期持有,再决定是否使用受控的伪匿名标识、仅在 Trace 中保留,或完全不采集。
验收治理是否生效
上线前先比较变更前后的唯一属性组合数、时间序列数和导出数据量,再抽样检查是否仍出现真实用户 ID、订单 ID、原始动态路径或未清理的查询参数。告警和仪表盘应继续按路由模板、方法、错误类别等稳定维度得到一致结果。
高基数治理的核心不是把所有“唯一值”都删掉,而是让聚合信号只承担聚合职责,把单次事件的定位信息留给更合适的 Trace 或 Log,并在任何信号上都先满足隐私和安全边界。