
可观测性与稳定性 / 系统课时
排查采样、基数与成本异常
排查采样、基数与成本异常
可观测性成本突然上涨时,真正的原因可能是业务流量增加、采样率改变、属性变宽或后端计费口径变化。本课把“事件数量、保留比例、每条数据大小和指标时间序列数”拆开检查,避免只盯总摄入量反复调采样率。
学习目标
- 区分流量增长、采样失效、高基数属性和单条遥测变大的不同成本来源。
- 用实际采样决策而不是配置文件中的百分比判断 Tail Sampling 是否按预期工作。
- 找到异常属性后选择降基数、降采样或缩减字段,并验证数据质量没有被破坏。
先拆开成本的四个变量
Trace 成本大致受“进入的 Trace 数 × 实际保留比例 × 每个 Trace 的 spans 数 × 单个 span 大小”影响;Metric 成本还要额外关注唯一属性组合形成的时间序列数量。把 user.id、订单号或原始 URL 放进指标维度,即使请求量不变,也可能让时间序列数量迅速膨胀。
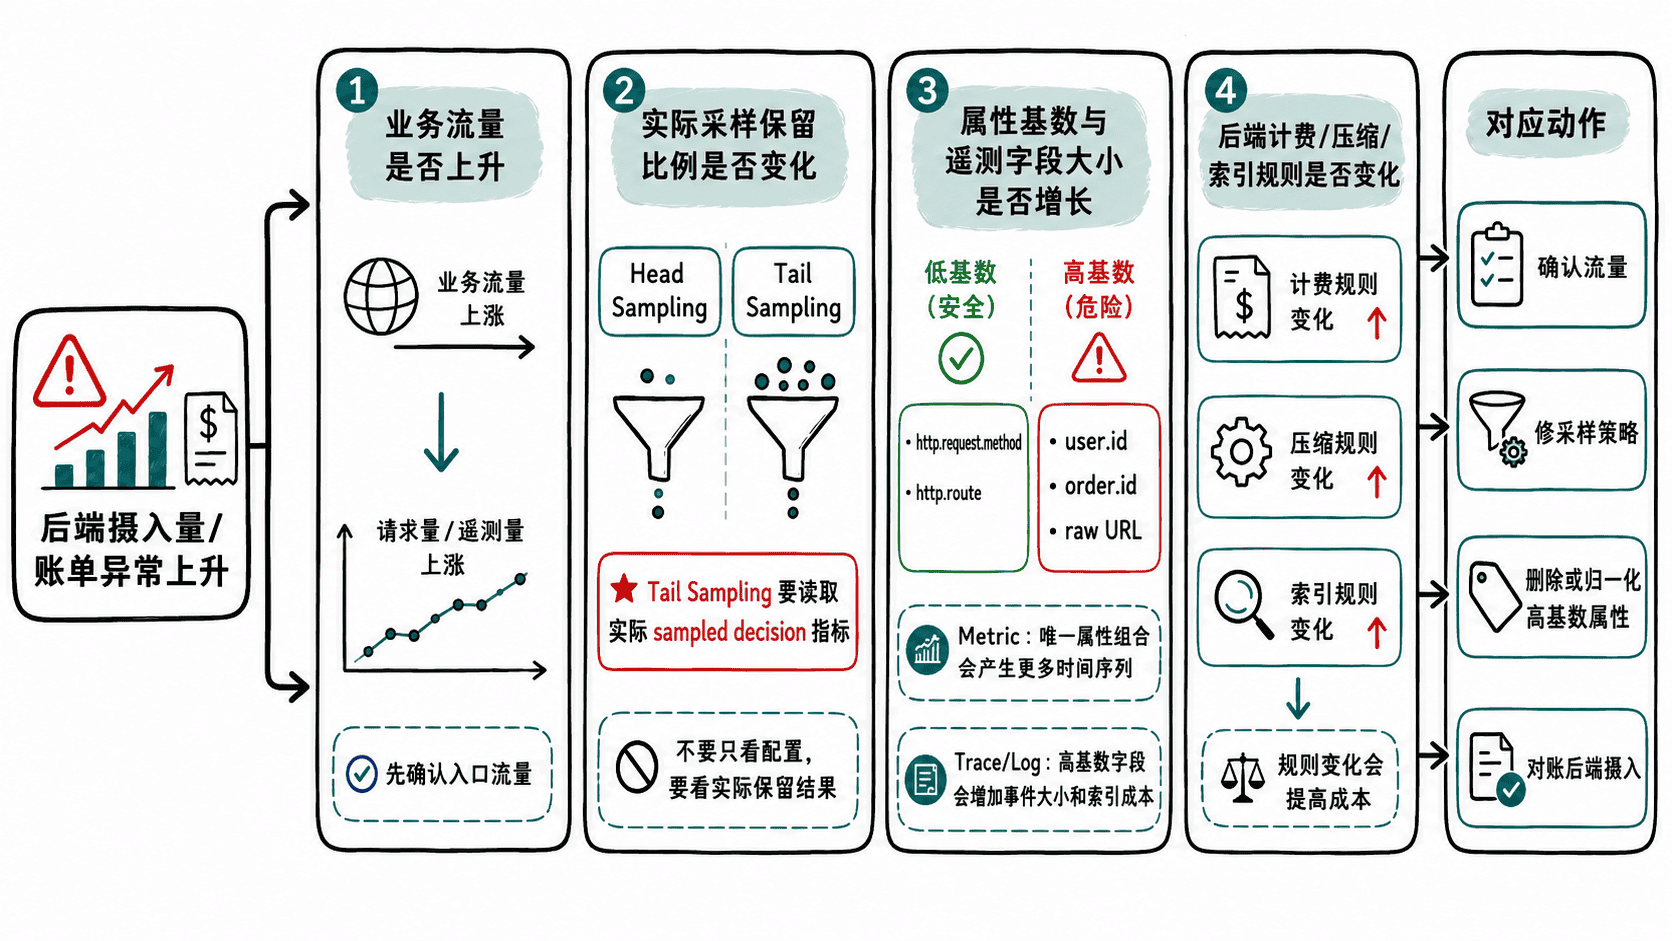
这四个变量要分别建立基线。只有 Trace 数量异常而 Metric 基本稳定,优先看采样与 Trace 路由;只有 Metric series 暴涨,优先看 attributes;三类信号同时按相同比例增加,则更像业务流量或重复采集。
先验证实际采样结果
Head Sampling 要核对入口根采样器的比例以及 ParentBased 传播是否被破坏。Tail Sampling 则不能只看 sampling_percentage 配置,因为 ERROR、延迟、属性和复合策略都可能把 Trace 保留下来,多个策略叠加后的实际保留率可能远高于直觉。
Tail Sampling 还依赖状态:同一 Trace 的 spans 必须到达同一采样实例。路由错误、num_traces 太小或 decision_wait 不合适,会造成过早淘汰和迟到 span,既影响数据质量,也会让“配置采样率”和“实际可用数据”脱节。
可先从 Collector 内部指标确认采样处理器当前暴露了哪些关键统计:
curl -fsS http://127.0.0.1:8888/metrics | grep -E '^otelcol_processor_tail_sampling_' | sed -E 's/\{.*//' | awk '{print $1}' | sed -E 's/_total$//' | sort -u | grep -E 'global_count_traces_sampled|sampling_trace_dropped_too_early|sampling_late_span_age'预期输出
otelcol_processor_tail_sampling_global_count_traces_sampled
otelcol_processor_tail_sampling_sampling_late_span_age_bucket
otelcol_processor_tail_sampling_sampling_late_span_age_count
otelcol_processor_tail_sampling_sampling_late_span_age_sum
otelcol_processor_tail_sampling_sampling_trace_dropped_too_early
实际暴露项取决于 Collector 版本、指标级别和组件配置;若某项不存在,应先核对当前版本的 Tail Sampling 指标,而不是按不存在的序列做告警。采样率判断应使用 sampled 与总决策的增量比值,并与业务入口请求量同时对照。
找到高基数从哪里进入
先按信号分类属性。对 Metric,http.route、请求方法、状态码等有限集合通常适合聚合;user.id、订单 ID、完整 URL、查询参数和随机标识符不适合作为长期维度。对 Trace 和 Log,这些字段有时有排障价值,但仍会增加传输字节、存储和索引成本,应根据是否需要检索决定保留位置。
异常往往来自一次“看似无害”的字段变化:把模板路由 /orders/{id} 改成原始路径 /orders/839271,或把异常消息全文作为维度。请求数没有变化,唯一属性组合却大量增加,后端时间序列和索引项会随之扩张。
用对照法锁定成本变化点
选择异常发生前后的等长时间窗口,依次比较入口请求数、Collector accepted 数量、实际 sampled 比例、exporter sent 数量以及后端摄入字节。若 accepted 与业务流量同步增长,采样率不变,属于真实流量增长;若 accepted 稳定而 sampled 比例上升,问题在采样策略;若数量稳定但摄入字节上涨,应检查新增属性、事件、stacktrace 或日志正文。
Metric 还要单独比较 active series 或后端的唯一时间序列数量。series 暴涨而 metric points 增幅不大,几乎可以直接把调查重点放到属性维度,而不是扩大 Collector。
修复后同时验证成本与可观测性
修复应针对根因:采样规则过宽就收紧策略优先级或比例;高基数 Metric 要删除、归一化或改成低基数属性;Trace/Log 中仅用于偶发定位的高基数字段可减少索引或只在错误样本保留。不要为了立刻降账单统一删除所有上下文,否则故障定位能力会一起消失。
变更后重新比较同一组指标:业务流量相近时,采样实际保留率回到目标区间,Tail Sampling 的过早丢弃没有恶化,Metric series 数下降,后端摄入量同步回落,同时错误 Trace、慢 Trace 和关键业务路径仍可查询。只有成本和可观测性两条验收线都通过,修复才是完整的。